Sys.setenv(LANGUAGE = "en")   # messages en anglais

library(tidyverse)
library(here)
library(scales)
library(patchwork)
library(plotly)
library(crosstalk)

source(here("R", "theme_cours.R"))   # theme_cours(), pal_cours, pal_regions

wdi <- read_csv(here("data", "wdi_panel.csv"), show_col_types = FALSE)

# L'espérance de vie de la RCA n'est pas fiable dans cette version des WDI (14,7 en 2009, 18,8 en 2022) : on l'exclut pour toutes les années
wdi <- wdi |> mutate(life_exp = if_else(iso3c == "CAF", NA_real_, life_exp))

# Coupe transversale utilisée dans la plupart des exemples : dernière année bien couverte
wdi_2022 <- wdi |>
  filter(year == 2022) |>
drop_na(gdp_pc_ppp, life_exp, region)Séance 6 : Visualisation avancée et rapports Quarto
Facettes, thèmes, annotations, patchwork, interactivité, Shiny et votre premier rapport reproductible
Objectifs de la séance
- Découper un graphique en petits multiples avec
facet_wrap()etfacet_grid(), et savoir quand des échelles libres induisent en erreur. - Comprendre le fonctionnement de
theme()et construire votre propre thème à partir du thème du cours. - Annoter un graphique (texte, lignes de référence) pour qu’il porte son message.
- Combiner plusieurs graphiques en une seule figure avec patchwork et l’exporter avec
ggsave(). - Rendre un graphique interactif avec plotly et relier deux graphiques avec crosstalk.
- Lire une petite application Shiny, et écrire puis générer un rapport Quarto minimal.
- Produire la figure de la « note au ministre » (projet final).
Préparer votre session R
Packages utilisés aujourd’hui : tidyverse, here, scales, patchwork, plotly, crosstalk (et shiny, facultatif). S’il en manque un, exécutez une seule fois install.packages("name") dans la console.
Comme en séance 4 (§ « Vérifiez d’abord les extrêmes »), la série d’espérance de vie de la République centrafricaine est mise à manquant pour toutes les années : elle n’est pas fiable dans cette version des WDI, si bien que tous les graphiques et toutes les moyennes d’espérance de vie ci-dessous laissent la CAF de côté.
Script de la séance : télécharger seance-6.R, tout le code de cette page dans un seul fichier.
Nous gardons la question fil rouge du cours : croissance, santé et inégalités, que disent les données sur les pays en développement ? Tous les graphiques utilisent le panel de la Banque mondiale data/wdi_panel.csv (pays × année, 2000–2023).
Rythme. Le parcours principal dure environ 180 minutes, exercices compris. Les parties marquées Facultatif : pour aller plus loin (thème personnalisé et exercice 6.2, crosstalk, Shiny) ajoutent environ 40 minutes : faites-les si le temps le permet, ou chez vous.
Pourquoi 2022 ? Les séances 5 et 6 utilisent 2022, la dernière année avec une bonne couverture des pays (la séance 4 utilisait 2019, la dernière année avant la COVID-19).
Facettes : les petits multiples
≈ 30 min, exercice 6.1 inclus Après cette section, vous saurez découper n’importe quel graphique en panneaux comparables, et reconnaître quand des échelles libres induisent en erreur.
Une facette découpe un graphique en panneaux, un par valeur d’une variable catégorielle. Tous les panneaux utilisent les mêmes axes, si bien que l’œil compare les formes d’un coup. C’est souvent préférable à 7 couleurs superposées.
NoteEn clair
Pensez à une bande dessinée : le même cadre répété, une case par personnage. Comme le cadre ne change jamais, on voit d’un coup d’œil ce qui diffère d’une case à l’autre.
facet_wrap() : une variable, des panneaux répartis sur une grille
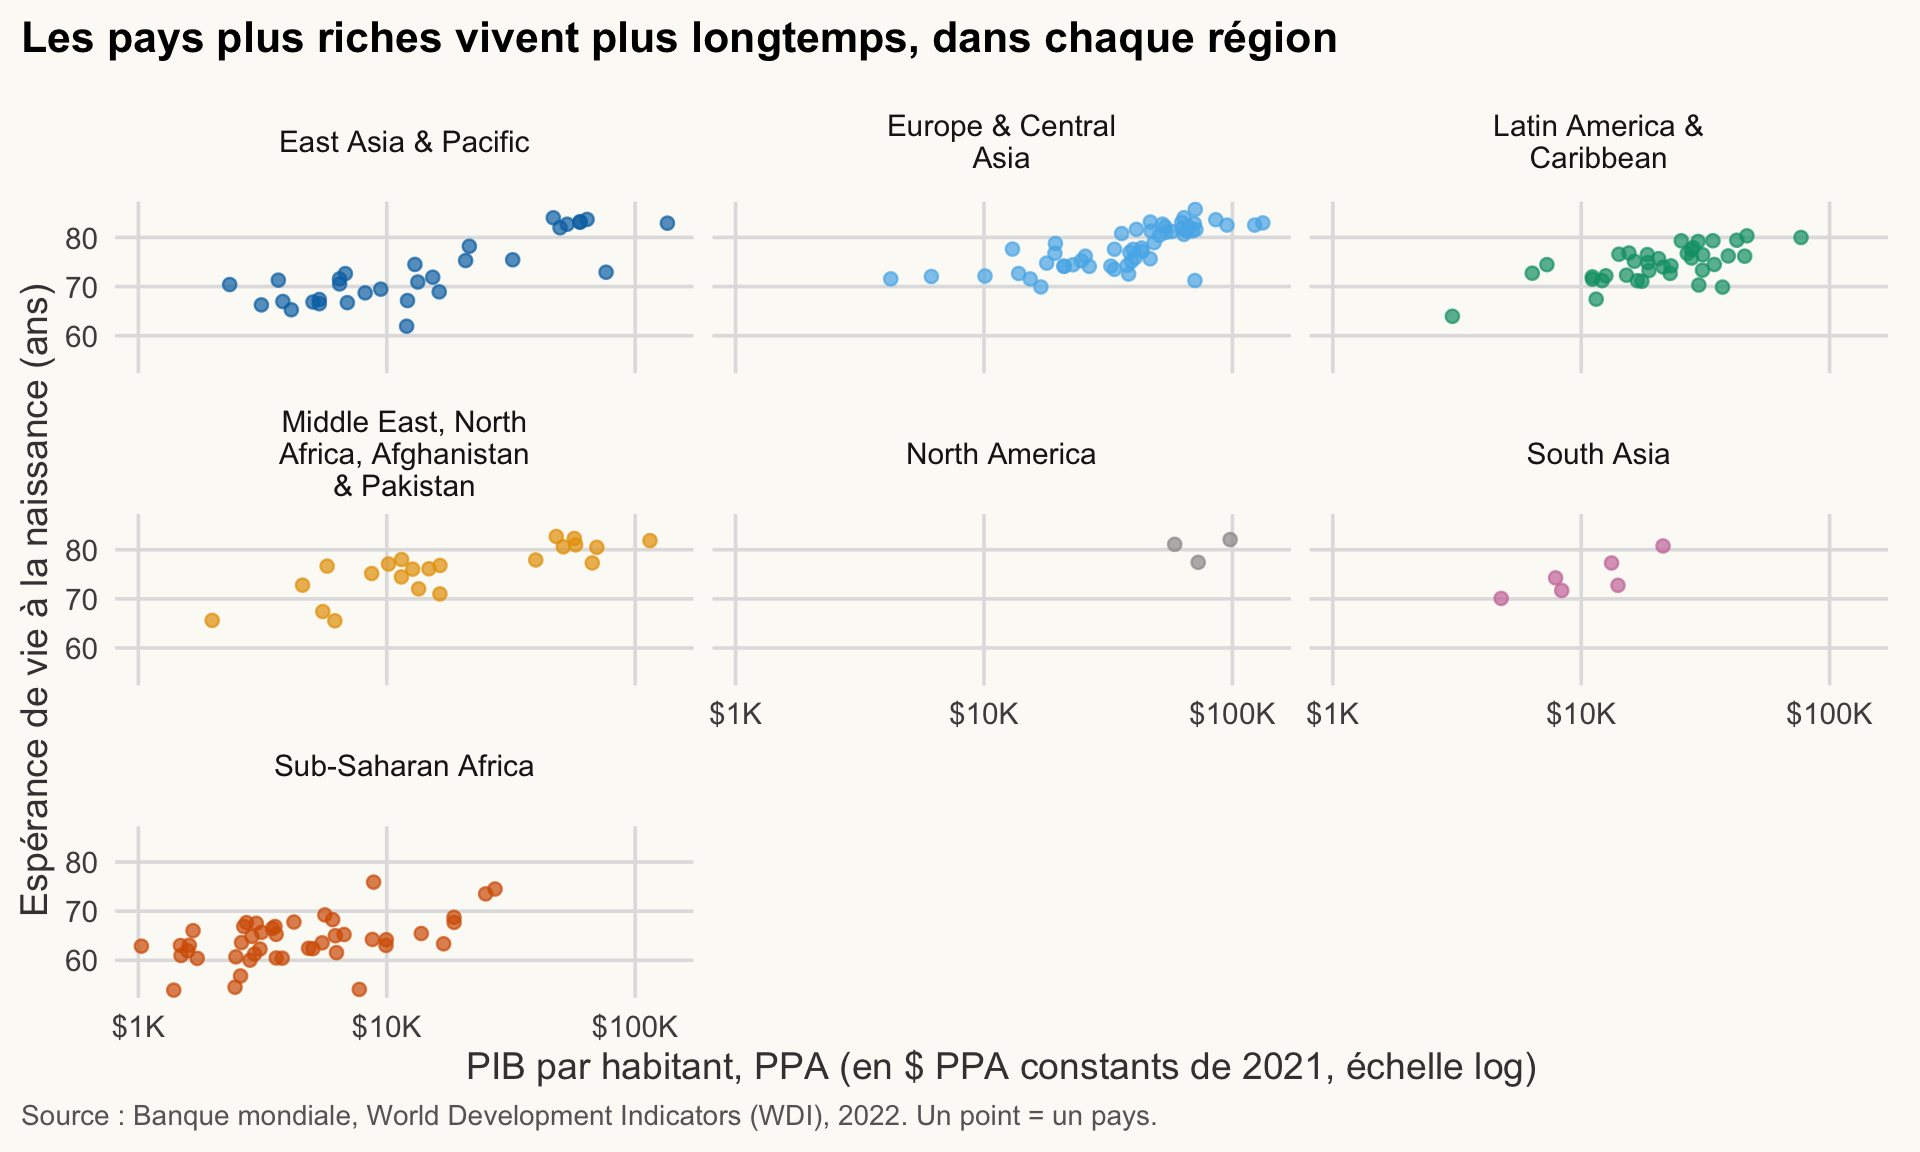
ggplot(wdi_2022, aes(x = gdp_pc_ppp, y = life_exp)) +
  geom_point(aes(colour = region), alpha = 0.7, show.legend = FALSE) +
  scale_colour_manual(values = pal_regions) +
  scale_x_log10(breaks = c(1e3, 1e4, 1e5),
                labels = label_dollar(scale_cut = cut_short_scale())) +
  facet_wrap(~ region, ncol = 3, labeller = label_wrap_gen(20)) +
  labs(
    title = "Les pays plus riches vivent plus longtemps, dans chaque région",
    x = "PIB par habitant, PPA (en $ PPA constants de 2021, échelle log)",
    y = "Espérance de vie à la naissance (ans)",
    caption = "Source : Banque mondiale, World Development Indicators (WDI), 2022. Un point = un pays."
  )
NoteComment lire ce graphique
- Chaque panneau est une région de la Banque mondiale ; chaque point est un pays.
- Comparez la pente du nuage d’un panneau à l’autre : la tendance à la hausse apparaît partout.
- Comparez la position des nuages : les panneaux se situent à des hauteurs différentes, car les axes sont partagés (fixes).
Remarques :
-
~ regionest une formule : « découper parregion».ncol/nrowcontrôlent la disposition ;label_wrap_gen(20)renvoie à la ligne les titres de panneaux trop longs. - La légende est redondante (le titre du panneau nomme déjà la région), d’où
show.legend = FALSE. - Utiliser les mêmes couleurs
pal_regionspartout permet de reconnaître une région tout au long du cours.
Tendances temporelles par panneau
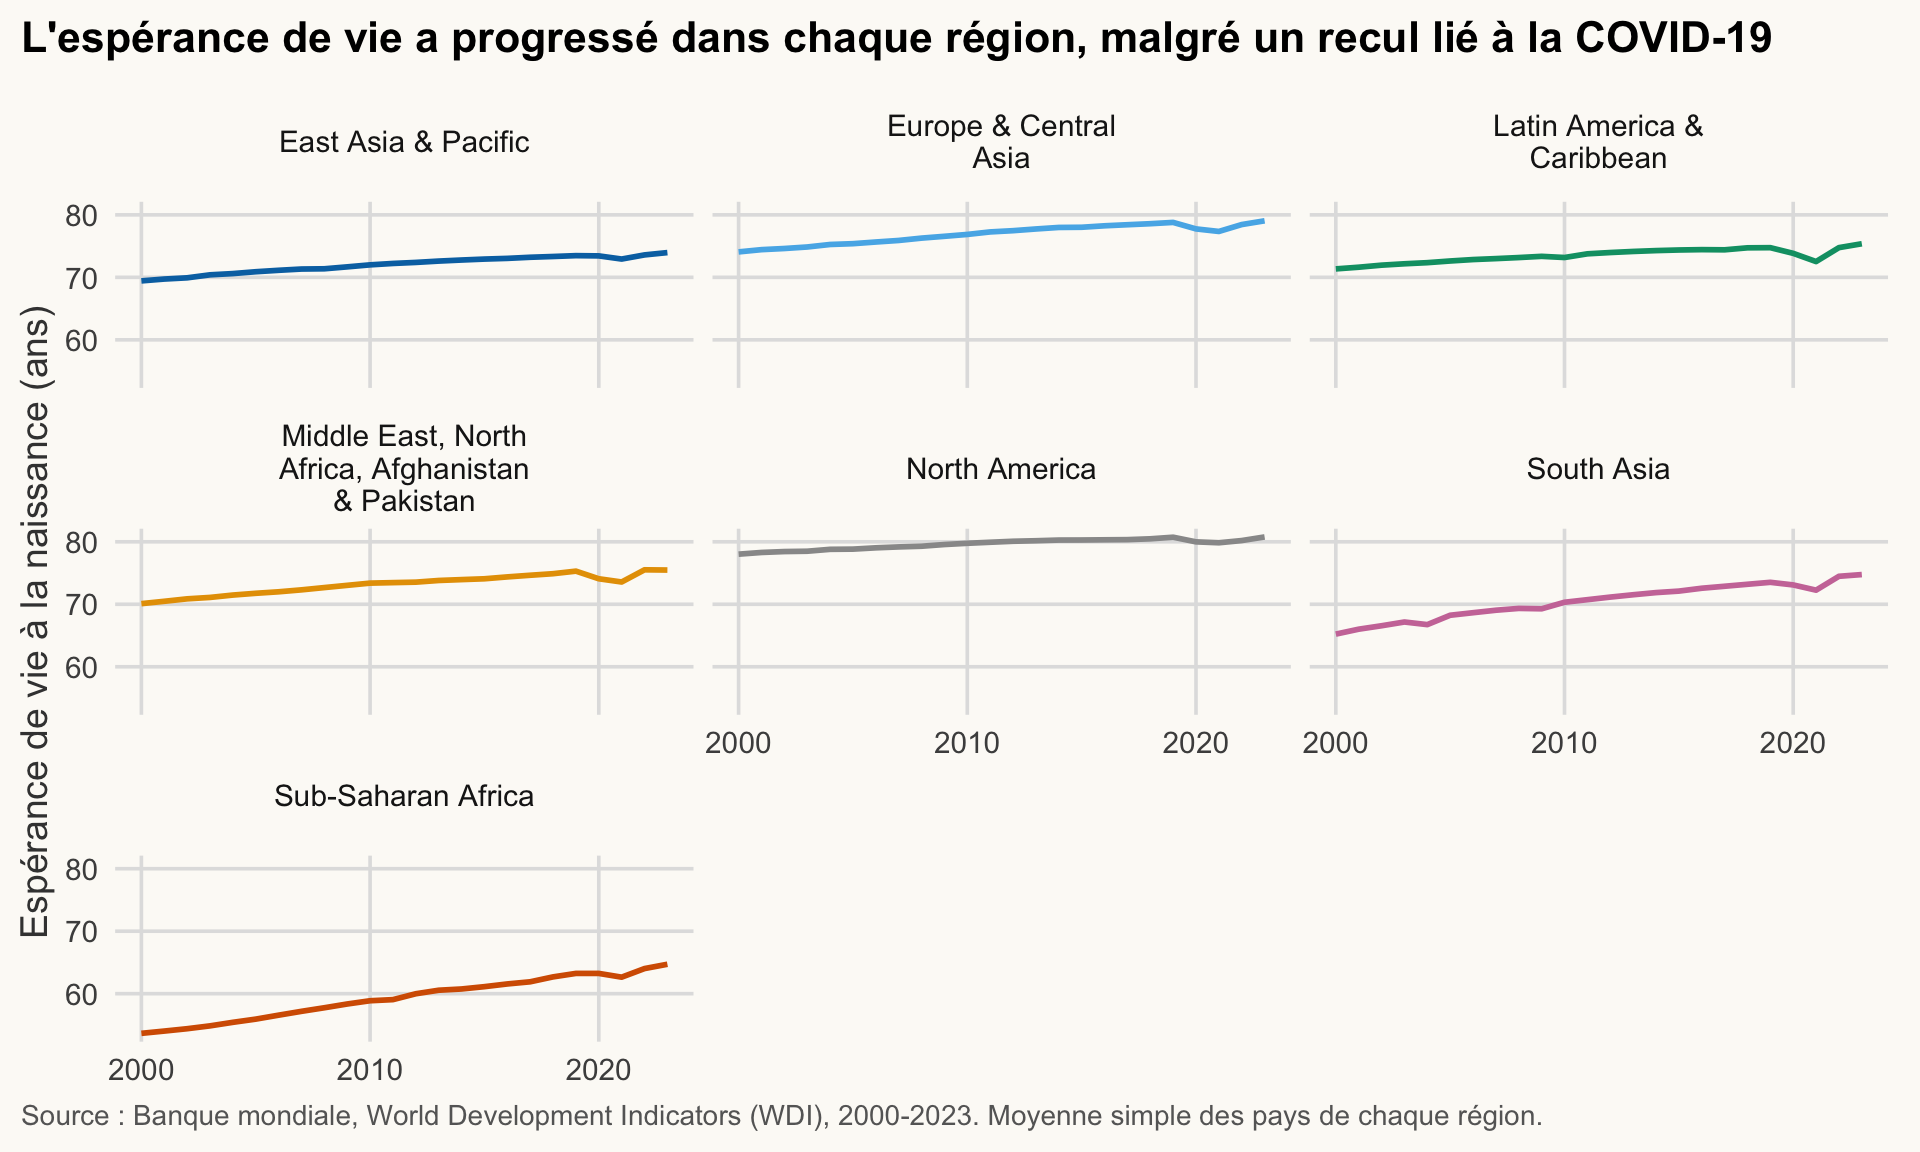
Les facettes conviennent bien aux séries temporelles. Voici l’espérance de vie moyenne par région (une simple moyenne des pays, non pondérée par la population).
trend_region <- wdi |>
  drop_na(life_exp, region) |>
  summarise(life_exp = mean(life_exp), .by = c(region, year))

ggplot(trend_region, aes(x = year, y = life_exp)) +
  geom_line(aes(colour = region), linewidth = 1, show.legend = FALSE) +
  scale_colour_manual(values = pal_regions) +
  scale_x_continuous(breaks = c(2000, 2010, 2020)) +
  facet_wrap(~ region, ncol = 3, labeller = label_wrap_gen(20)) +
  labs(
    title = "L'espérance de vie a progressé dans chaque région, malgré un recul lié à la COVID-19",
    x = NULL, y = "Espérance de vie à la naissance (ans)",
    caption = "Source : Banque mondiale, World Development Indicators (WDI), 2000-2023. Moyenne simple des pays de chaque région."
  )
ImportantIdée clé
Les petits multiples remplacent un graphique chargé par de nombreux graphiques simples qui partagent les mêmes axes. Mêmes axes, donc l’œil peut comparer.
facet_grid() : deux variables, lignes × colonnes
facet_grid(rows ~ columns) croise deux variables. Ici : le groupe de revenu (lignes) et deux années (colonnes). La colonne income est la classification par revenu actuelle de la Banque mondiale, appliquée à toutes les années : un pays figure dans son groupe d’aujourd’hui en 2000 aussi, même s’il a changé de groupe depuis. Il en va de même pour l’exercice 6.1.
income_levels <- c("Low income", "Lower middle income",
                   "Upper middle income", "High income")

wdi |>
  filter(year %in% c(2000, 2022), income %in% income_levels) |>
  drop_na(gdp_pc_ppp, life_exp) |>
  mutate(income = factor(income, levels = income_levels)) |>
  ggplot(aes(x = gdp_pc_ppp, y = life_exp)) +
  geom_point(colour = pal_cours[["principal"]], alpha = 0.6) +
  scale_x_log10(breaks = c(1e3, 1e4, 1e5),
                labels = label_dollar(scale_cut = cut_short_scale())) +
  facet_grid(income ~ year, labeller = label_wrap_gen(10)) +
  labs(
    title = str_wrap("Au sein des groupes de revenu, le lien revenu-santé paraît plus faible", 60),
    x = "PIB par habitant, PPA (en $ PPA constants de 2021, échelle log)",
    y = "Espérance de vie à la naissance (ans)",
    caption = str_wrap("Source : Banque mondiale, World Development Indicators (WDI), 2000 et 2022. Un point = un pays. Lignes : groupe de revenu (classification actuelle de la Banque mondiale).", 95)
  )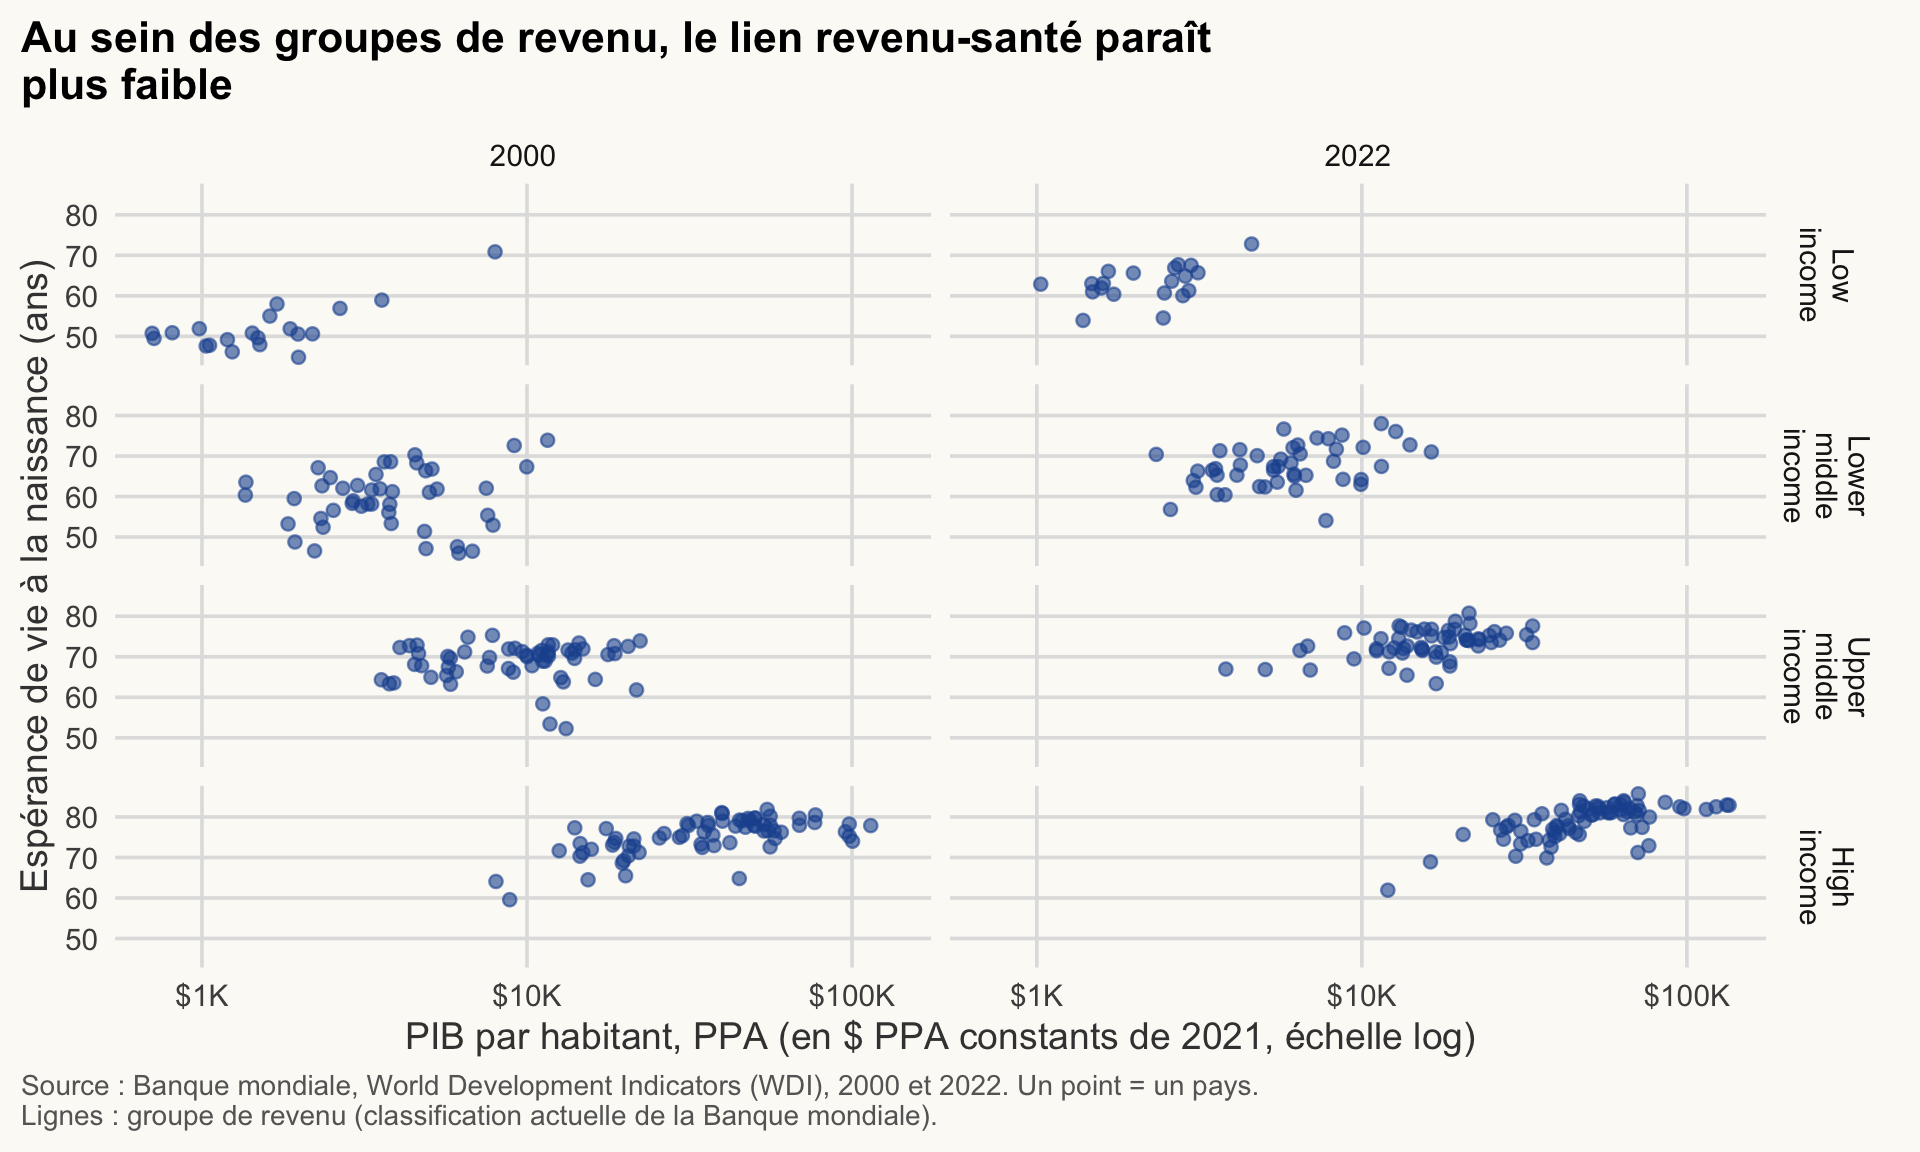
Remarquez le factor(..., levels = ...) : il place les groupes de revenu dans leur ordre naturel plutôt que dans l’ordre alphabétique.
Échelles libres : quand (ne pas) les utiliser
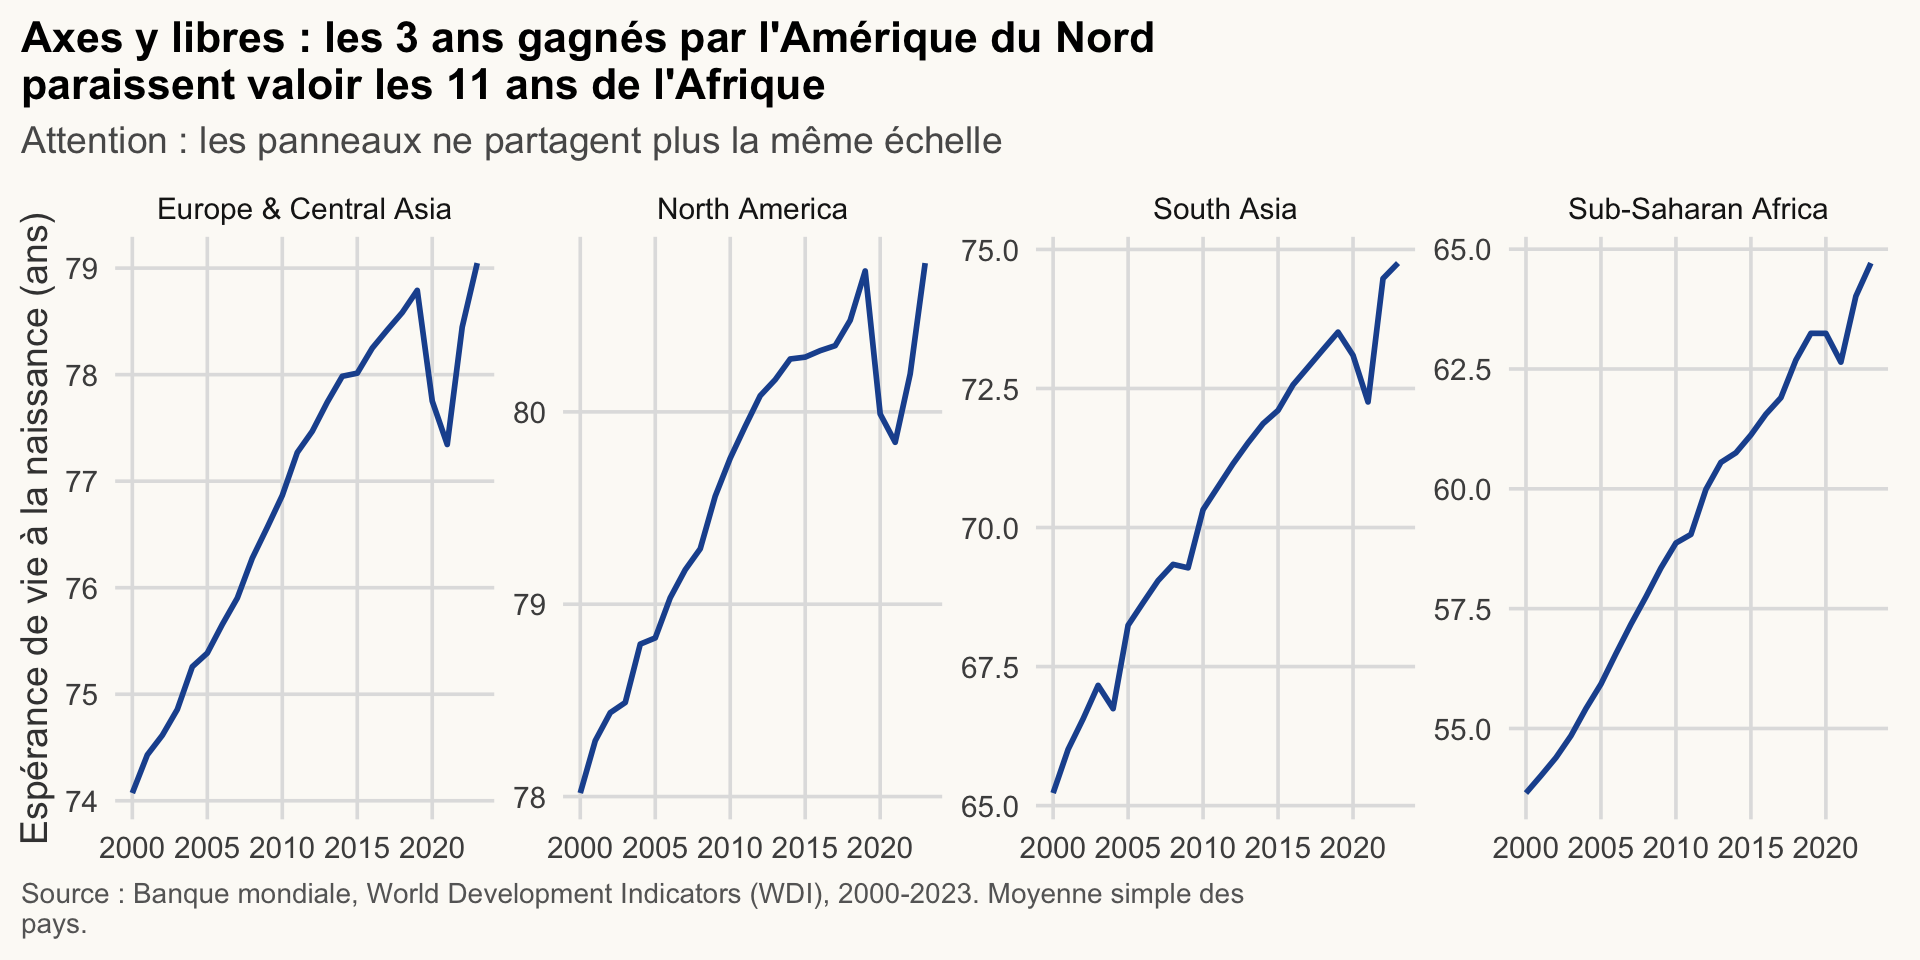
Par défaut, tous les panneaux partagent les mêmes axes (scales = "fixed"). Vous pouvez les libérer avec scales = "free", "free_x" ou "free_y".
trend_region |>
  filter(region %in% c("Sub-Saharan Africa", "North America",
                       "South Asia", "Europe & Central Asia")) |>
  ggplot(aes(x = year, y = life_exp)) +
  geom_line(linewidth = 1, colour = pal_cours[["principal"]]) +
  facet_wrap(~ region, scales = "free_y", nrow = 1) +
  labs(
    title = str_wrap("Axes y libres : les 3 ans gagnés par l'Amérique du Nord paraissent valoir les 11 ans de l'Afrique", 60),
    subtitle = str_wrap("Attention : les panneaux ne partagent plus la même échelle", 75),
    x = NULL, y = "Espérance de vie à la naissance (ans)",
    caption = str_wrap("Source : Banque mondiale, World Development Indicators (WDI), 2000-2023. Moyenne simple des pays.", 95)
  )
Pour comparer, voici les quatre mêmes régions avec l’échelle fixe par défaut.
trend_region |>
  filter(region %in% c("Sub-Saharan Africa", "North America",
                       "South Asia", "Europe & Central Asia")) |>
  ggplot(aes(x = year, y = life_exp)) +
  geom_line(linewidth = 1, colour = pal_cours[["principal"]]) +
  facet_wrap(~ region, nrow = 1) +
  labs(
    title = "Axes y fixes : les niveaux diffèrent, et l'Afrique et l'Asie du Sud gagnent le plus",
    x = NULL, y = "Espérance de vie à la naissance (ans)",
    caption = "Source : Banque mondiale, World Development Indicators (WDI), 2000-2023. Moyenne simple des pays."
  )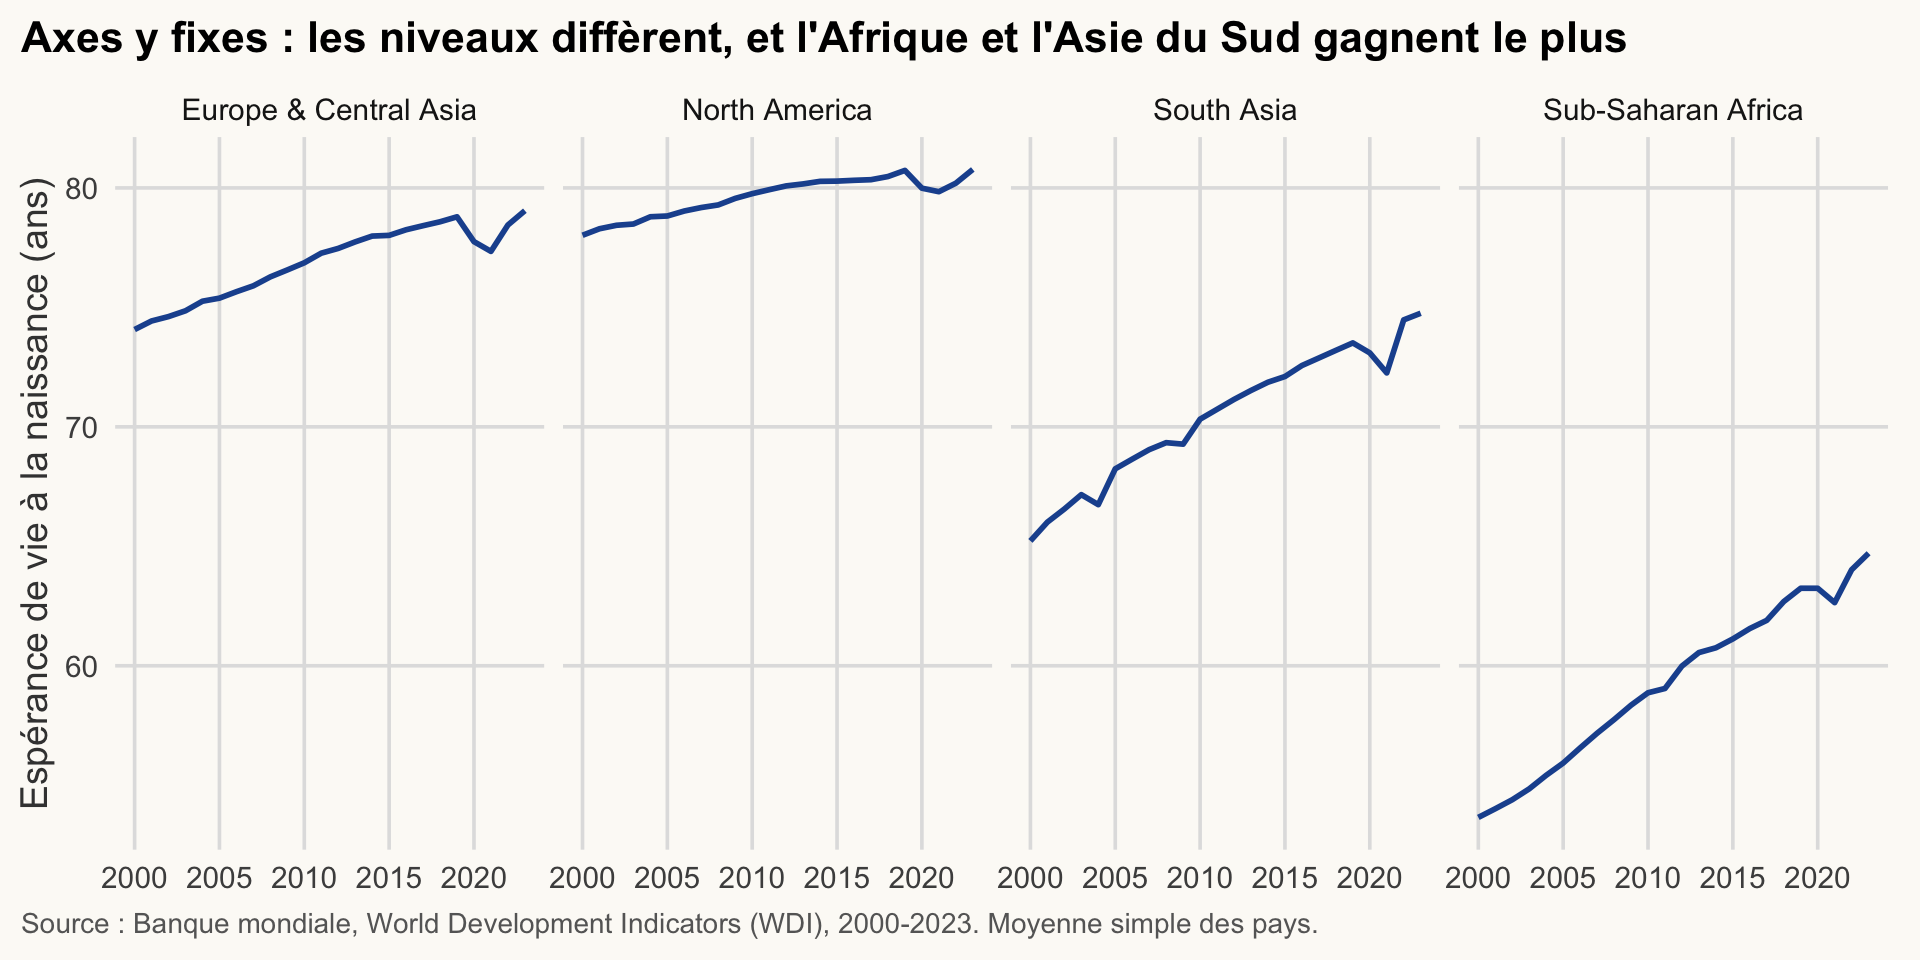
Mêmes données, deux histoires : la version à échelles libres masque les écarts de niveau et grossit les petites variations. L’Amérique du Nord a gagné environ 3 ans de 2000 à 2023 et l’Afrique subsaharienne environ 11, pourtant les deux courbes remplissent leur panneau ; et un recul lié à la COVID-19 d’environ un an en Amérique du Nord et d’un an et demi en Europe et Asie centrale ressemble à un effondrement.
AvertissementErreur fréquente
Les échelles libres font remplir à chaque panneau tout son cadre, si bien qu’une petite variation paraît aussi grande qu’une grande. Utilisez-les uniquement pour comparer des formes (moments, points de retournement), jamais des niveaux ni des ordres de grandeur. Si les lecteurs doivent comparer des niveaux, gardez des échelles fixes (c’est la valeur par défaut). Si vous libérez les axes, dites-le dans le sous-titre. Comment la repérer : des panneaux dont les graduations de l’axe des y diffèrent.
AstuceExercice 6.1
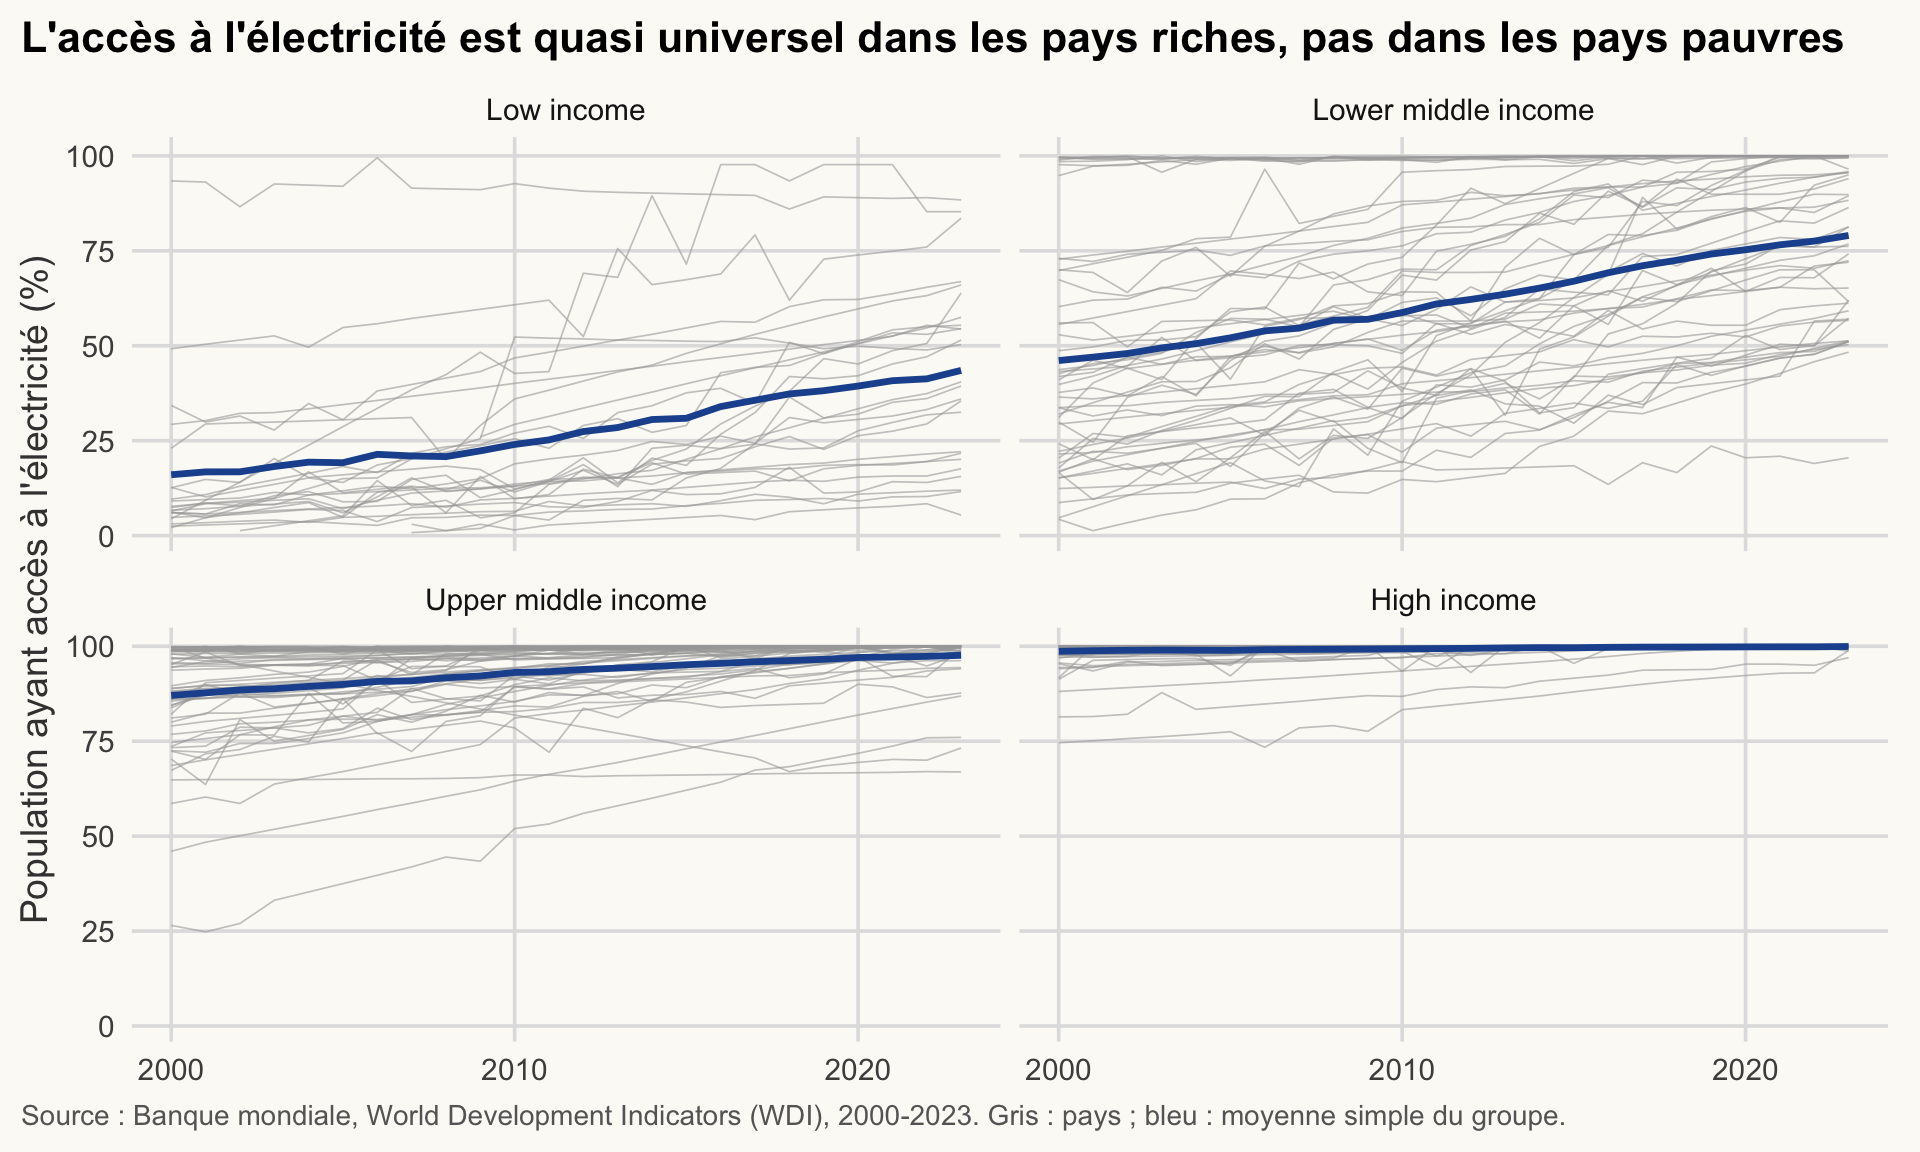
À partir de wdi, tracez la part de la population ayant accès à l’électricité (elec_access) en fonction de l’année pour les quatre groupes de revenu (facet_wrap(~ income)), avec une fine ligne grise par pays et la moyenne du groupe en pal_cours[["principal"]]. Choisissez un titre qui énonce le message. Indice : utilisez group = iso3c pour les lignes des pays, et un second geom_line() sur un data frame résumé.
NoteAfficher la solution
elec <- wdi |>
  filter(income %in% income_levels) |>
  drop_na(elec_access) |>
  mutate(income = factor(income, levels = income_levels))

elec_mean <- elec |>
  summarise(elec_access = mean(elec_access), .by = c(income, year))

ggplot(elec, aes(x = year, y = elec_access)) +
  geom_line(aes(group = iso3c), colour = pal_cours[["gris"]],
            linewidth = 0.3, alpha = 0.6) +
  geom_line(data = elec_mean, colour = pal_cours[["principal"]], linewidth = 1.2) +
  scale_x_continuous(breaks = c(2000, 2010, 2020)) +
  facet_wrap(~ income, labeller = label_wrap_gen(20)) +
  labs(
    title = "L'accès à l'électricité est quasi universel dans les pays riches, pas dans les pays pauvres",
    x = NULL, y = "Population ayant accès à l'électricité (%)",
    caption = "Source : Banque mondiale, World Development Indicators (WDI), 2000-2023. Gris : pays ; bleu : moyenne simple du groupe."
  )
Thèmes : maîtriser l’apparence
≈ 20 min Après cette section, vous saurez restyler n’importe quel graphique et définir une apparence unique pour tout un projet.
Avant et après : ce que les techniques apportent
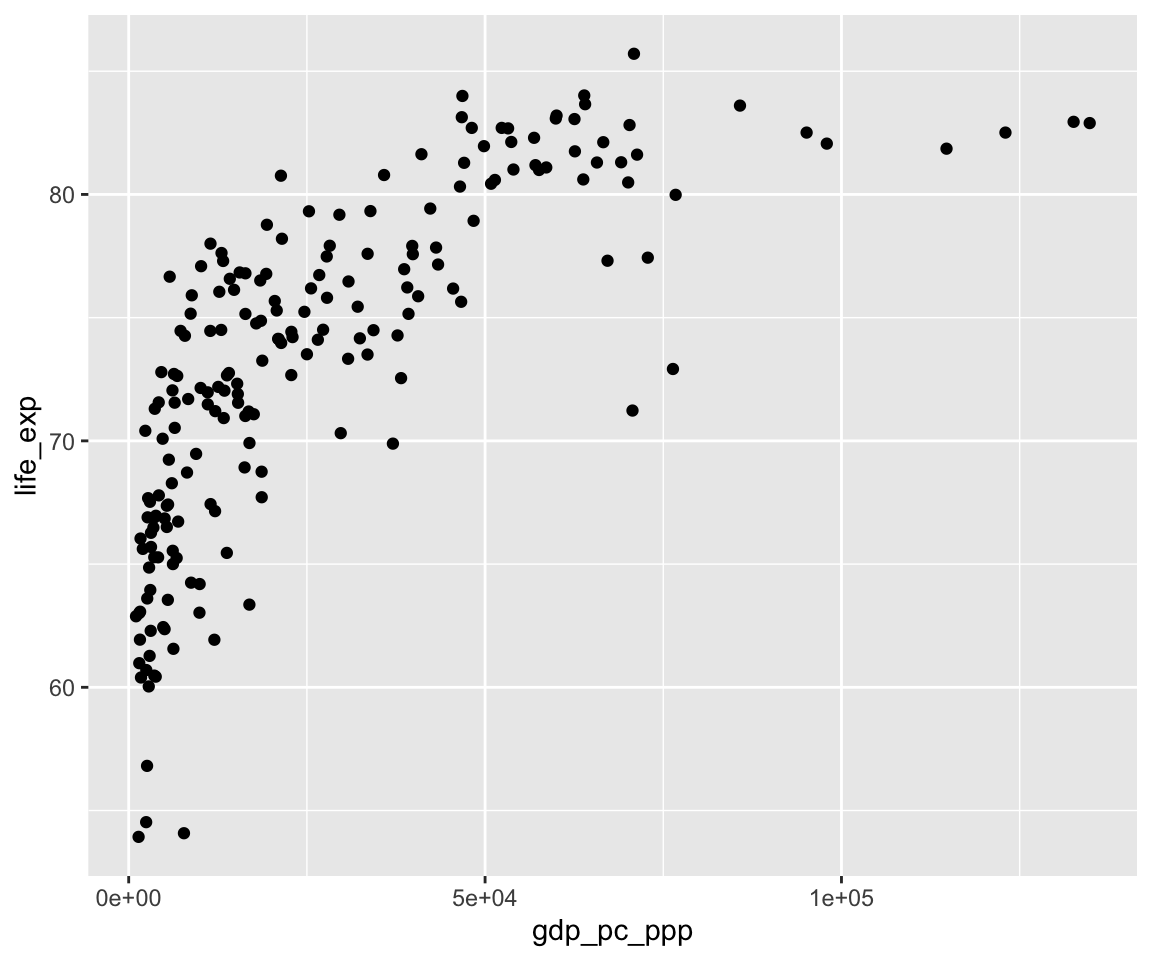
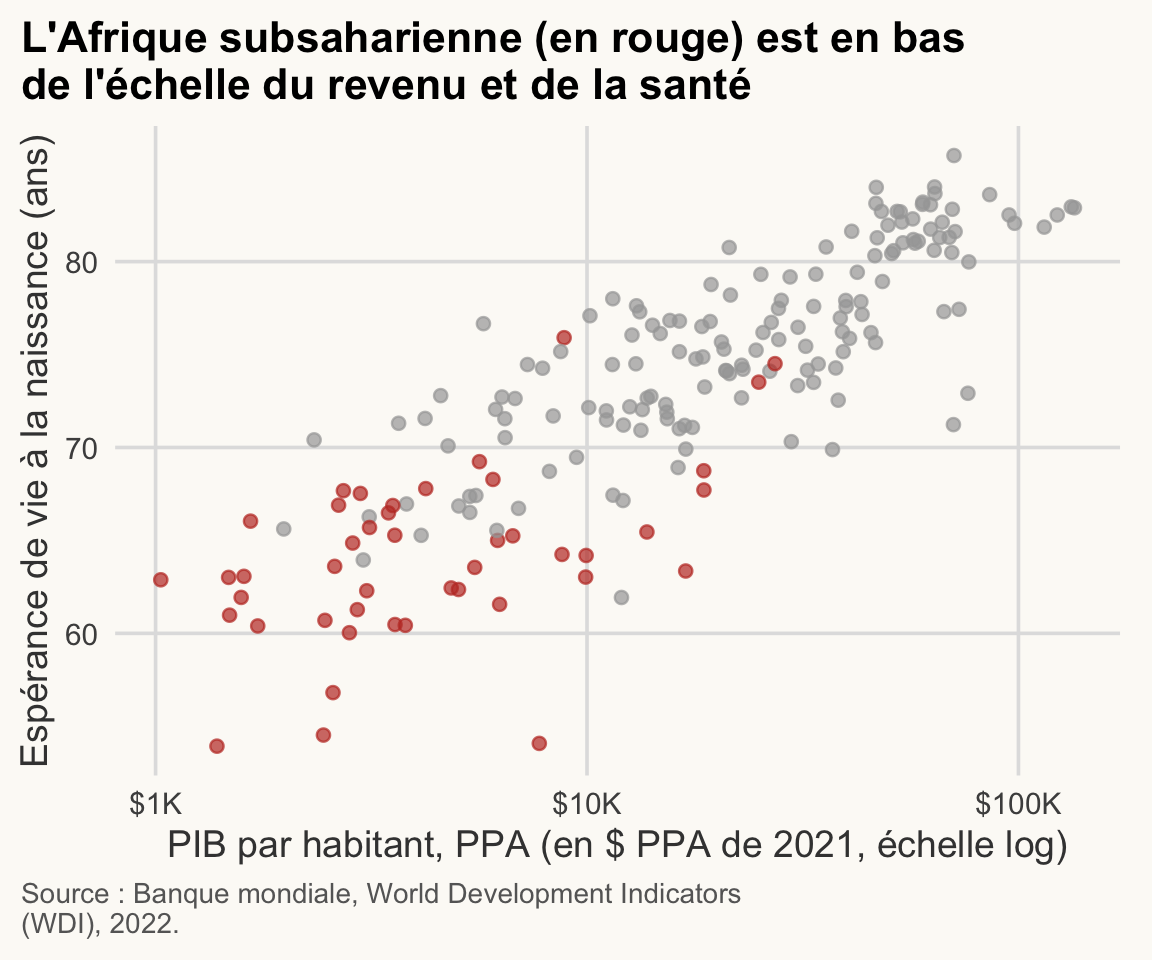
À gauche, un graphique avec les réglages par défaut de ggplot. À droite, les mêmes données après les techniques de cette séance : un titre-message, des unités, un groupe mis en évidence, une source. Les données et la géométrie sont identiques ; seule la communication a changé.
# Avant : réglages par défaut uniquement
ggplot(wdi_2022, aes(x = gdp_pc_ppp, y = life_exp)) +
  geom_point() +
  theme_gray()
# Après : titre-message, unités, mise en évidence, source
wdi_2022 |>
  mutate(focus = region == "Sub-Saharan Africa") |>
  ggplot(aes(x = gdp_pc_ppp, y = life_exp, colour = focus)) +
  geom_point(alpha = 0.7) +
  scale_colour_manual(values = c("FALSE" = pal_cours[["gris"]],
                                 "TRUE"  = pal_cours[["accent"]]),
                      guide = "none") +
  scale_x_log10(labels = label_dollar(scale_cut = cut_short_scale())) +
  labs(
    title = str_wrap("L'Afrique subsaharienne (en rouge) est en bas de l'échelle du revenu et de la santé", 45),
    x = "PIB par habitant, PPA (en $ PPA de 2021, échelle log)",
    y = "Espérance de vie à la naissance (ans)",
    caption = str_wrap("Source : Banque mondiale, World Development Indicators (WDI), 2022.", 55)
  )
ImportantIdée clé
Un thème contrôle l’apparence d’un graphique ; le titre, les unités et la mise en évidence contrôlent ce qu’il dit. Une bonne figure a besoin des deux, et aucun ne modifie les données.
Construire un petit thème personnalisé (Facultatif : pour aller plus loin, ≈ 10 min)
Un thème personnalisé est une fonction qui renvoie un thème. Construisez-le à partir de theme_cours() et ne modifiez que le nécessaire. Ne fixez pas de family = pour les polices à moins d’être sûr que la police existe sur toutes les machines : une police indisponible retombe silencieusement sur une police par défaut ou déclenche des avertissements. Les familles génériques "sans", "serif" et "mono" existent toujours.
theme_cours_dark <- function(base_size = 14) {
  theme_cours(base_size = base_size) +
    theme(
      plot.background  = element_rect(fill = "#1b2733", colour = NA),
      panel.background = element_rect(fill = "#1b2733", colour = NA),
      text             = element_text(colour = "grey90"),
      plot.title       = element_text(colour = "white"),
      plot.subtitle    = element_text(colour = "grey80"),
      plot.caption     = element_text(colour = "grey70"),
      axis.text        = element_text(colour = "grey80"),
      axis.title       = element_text(colour = "grey85"),
      panel.grid.major = element_line(colour = "grey30")
    )
}

p_base + geom_point(colour = "#56B4E9", alpha = 0.7) + theme_cours_dark()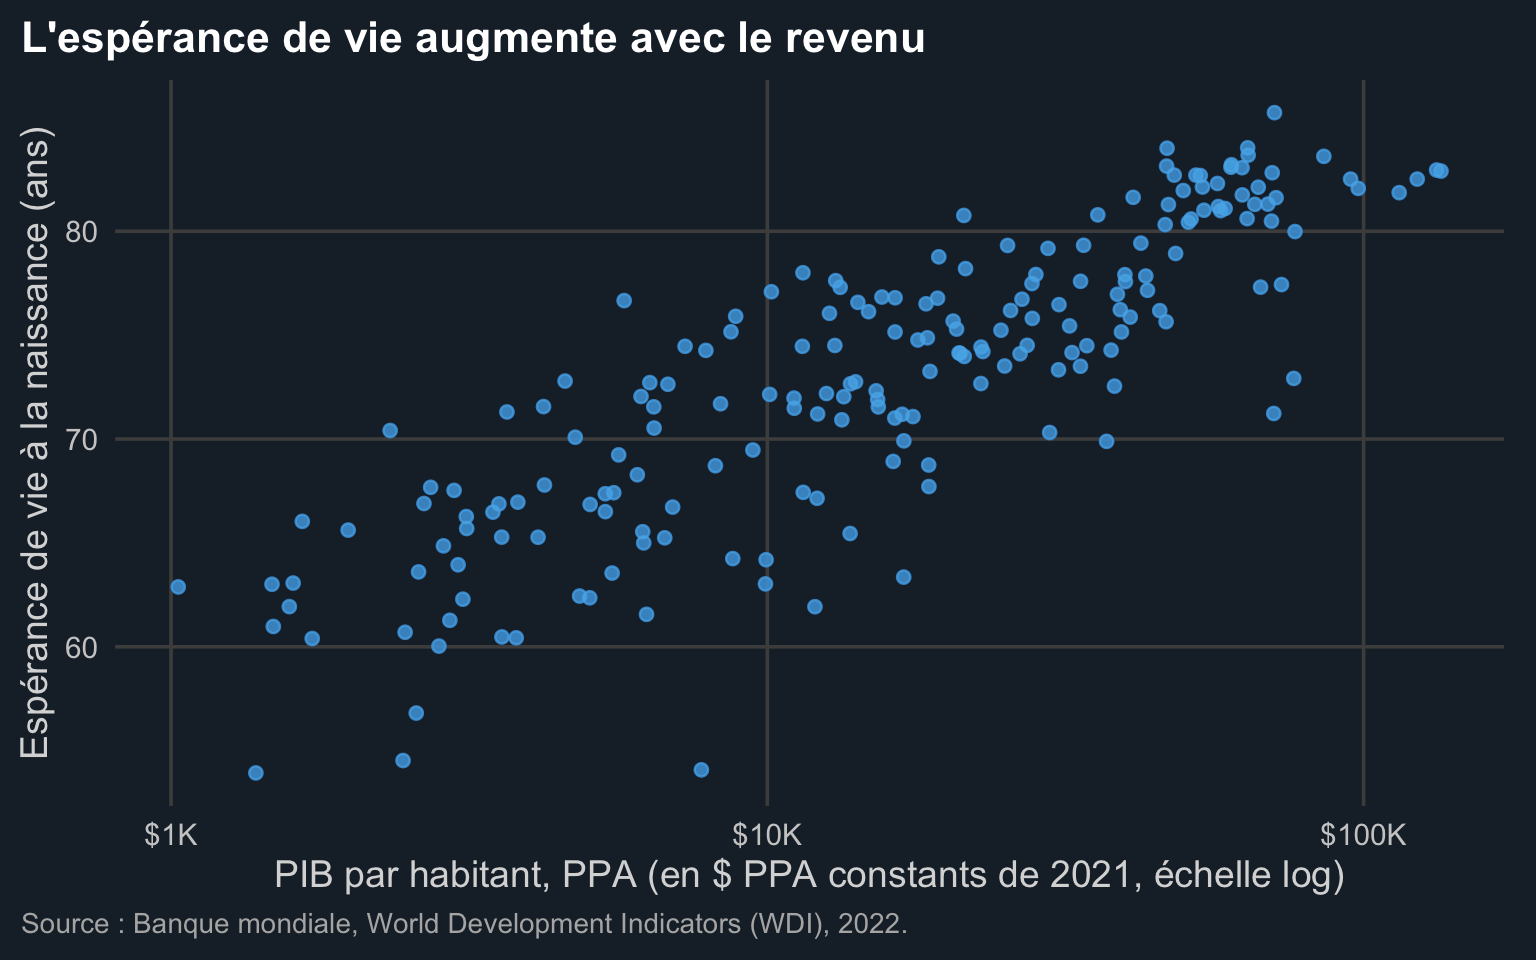
Note
Un fond sombre convient à des diapositives projetées dans une salle sombre. Pour une note imprimée, préférez le blanc. Cet exemple porte sur la manière de construire un thème, pas sur une recommandation de design.
Le thème du cours : définir un thème une fois pour toutes
Ouvrez R/theme_cours.R dans le projet. Il fait trois choses :
- il définit les palettes
pal_cours(couleurs nommées) etpal_regions(une couleur fixe par région de la Banque mondiale) ; - il définit
theme_cours(), une fonction qui part detheme_minimal()et règle la position du titre, les titres en gras, la note de source en gris, la grille claire, la légende en bas ; - il se termine par
theme_set(theme_cours()), qui en fait le thème par défaut de chaque graphique tracé ensuite dans la session.
Cette dernière ligne explique pourquoi les graphiques de cette page n’ont pas besoin de + theme_...(). Dans vos propres projets, placez un fichier de thème dans R/, chargez-le avec source() en haut de chaque script, et toutes vos figures partageront la même apparence. Modifier le style plus tard revient à modifier un seul endroit.
# Quel est le thème par défaut actuel ? (un thème est une liste de réglages : affichons-en un)
theme_get()$legend.position
[1] "bottom"Vous pouvez définir un thème pour un seul graphique avec + theme_minimal(), ou restaurer le thème par défaut de ggplot2 avec theme_set(theme_grey()).
AstuceExercice 6.2 (Facultatif : pour aller plus loin)
Écrivez une fonction theme_cours_print() basée sur theme_cours() qui (i) utilise base_size = 12, (ii) place la légende en haut, et (iii) supprime toutes les lignes de grille sauf les lignes principales horizontales. Appliquez-la au nuage de points p_base coloré par région (utilisez pal_regions).
NoteAfficher la solution
theme_cours_print <- function(base_size = 12) {
  theme_cours(base_size = base_size) +
    theme(
      legend.position    = "top",
      panel.grid.major.x = element_blank(),
      panel.grid.minor   = element_blank()
    )
}

ggplot(wdi_2022, aes(x = gdp_pc_ppp, y = life_exp, colour = region)) +
  geom_point(alpha = 0.7) +
  scale_colour_manual(values = pal_regions, name = NULL) +
  scale_x_log10(labels = label_dollar(scale_cut = cut_short_scale())) +
  guides(colour = guide_legend(nrow = 3)) +
  labs(
    title = "L'espérance de vie augmente avec le revenu dans chaque région",
    x = "PIB par habitant, PPA (en $ PPA constants de 2021, échelle log)",
    y = "Espérance de vie à la naissance (ans)",
    caption = "Source : Banque mondiale, World Development Indicators (WDI), 2022."
  ) +
  theme_cours_print() +
  theme(legend.text = element_text(size = 9))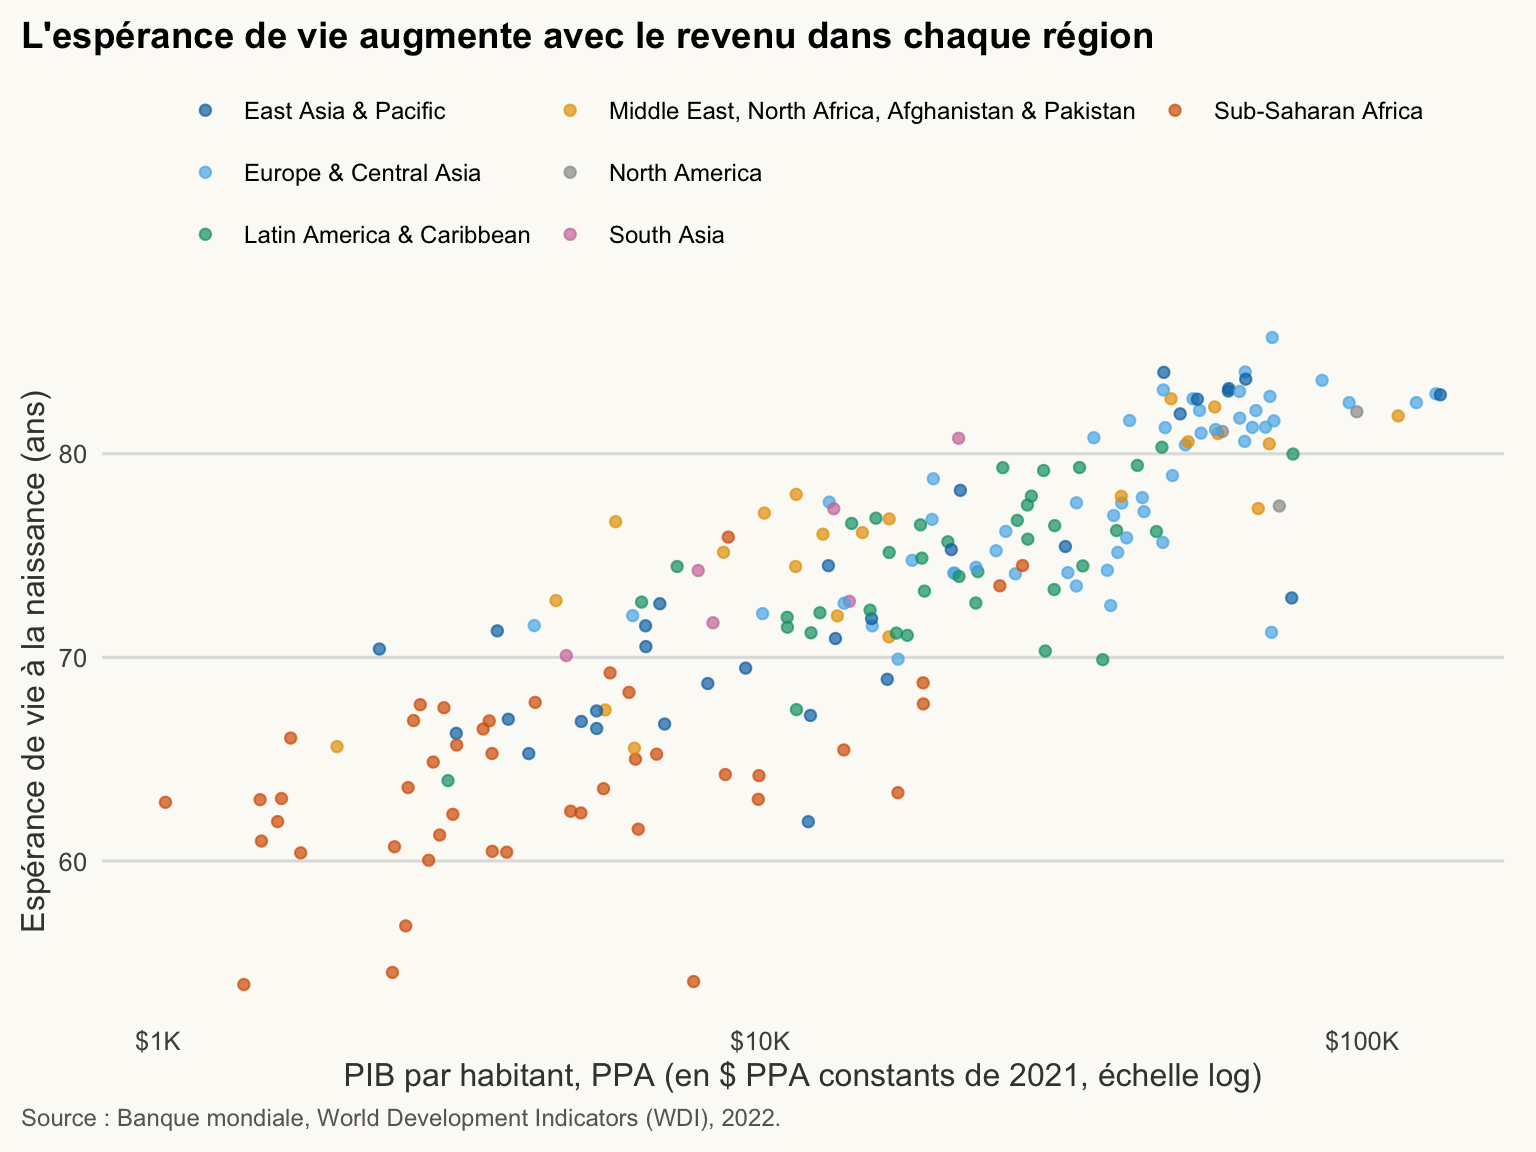
Annotations et lignes de référence
≈ 15 min Après cette section, vous saurez guider le lecteur vers le résultat avec des lignes, des étiquettes et des zones colorées.
Un graphique qui porte un message le dit. Les annotations orientent le lecteur vers l’essentiel. Trois outils :
-
geom_vline()/geom_hline(): des lignes de référence à un x ou un y donné ; -
annotate("text", x, y, label): une étiquette de texte à des coordonnées exprimées en unités de données ; -
annotate("rect", ...)ouannotate("segment", ...): des zones colorées et des flèches.
Exemple : l’espérance de vie mondiale autour de la pandémie de COVID-19. Nous utilisons la moyenne mondiale pondérée par la population, car une moyenne non pondérée des pays compte Tuvalu comme l’Inde.
life_world <- wdi |>
  drop_na(life_exp, population) |>
  summarise(life_exp = weighted.mean(life_exp, w = population), .by = year)

le_2019_2021 <- life_world |>
  filter(year %in% c(2019, 2021, 2023)) |>
  arrange(year) |>
  pull(life_exp)

ggplot(life_world, aes(x = year, y = life_exp)) +
  annotate("rect", xmin = 2019.5, xmax = 2021.5, ymin = -Inf, ymax = Inf,
           fill = pal_cours[["accent"]], alpha = 0.08) +
  geom_line(linewidth = 1.1, colour = pal_cours[["principal"]]) +
  geom_vline(xintercept = 2020, linetype = "dashed", colour = pal_cours[["accent"]]) +
  annotate("text", x = 2019.3, y = min(life_world$life_exp) + 0.5,
           label = "COVID-19\n(2020-21)", hjust = 1,
           colour = pal_cours[["accent"]], fontface = "bold") +
  labs(
    title = str_wrap("L'espérance de vie mondiale a reculé après 2019 et s'est rétablie en 2023", 60),
    x = NULL, y = "Espérance de vie à la naissance (ans)",
    caption = str_wrap("Source : Banque mondiale, World Development Indicators (WDI), 2000-2023. Moyenne des pays pondérée par la population.", 95)
  )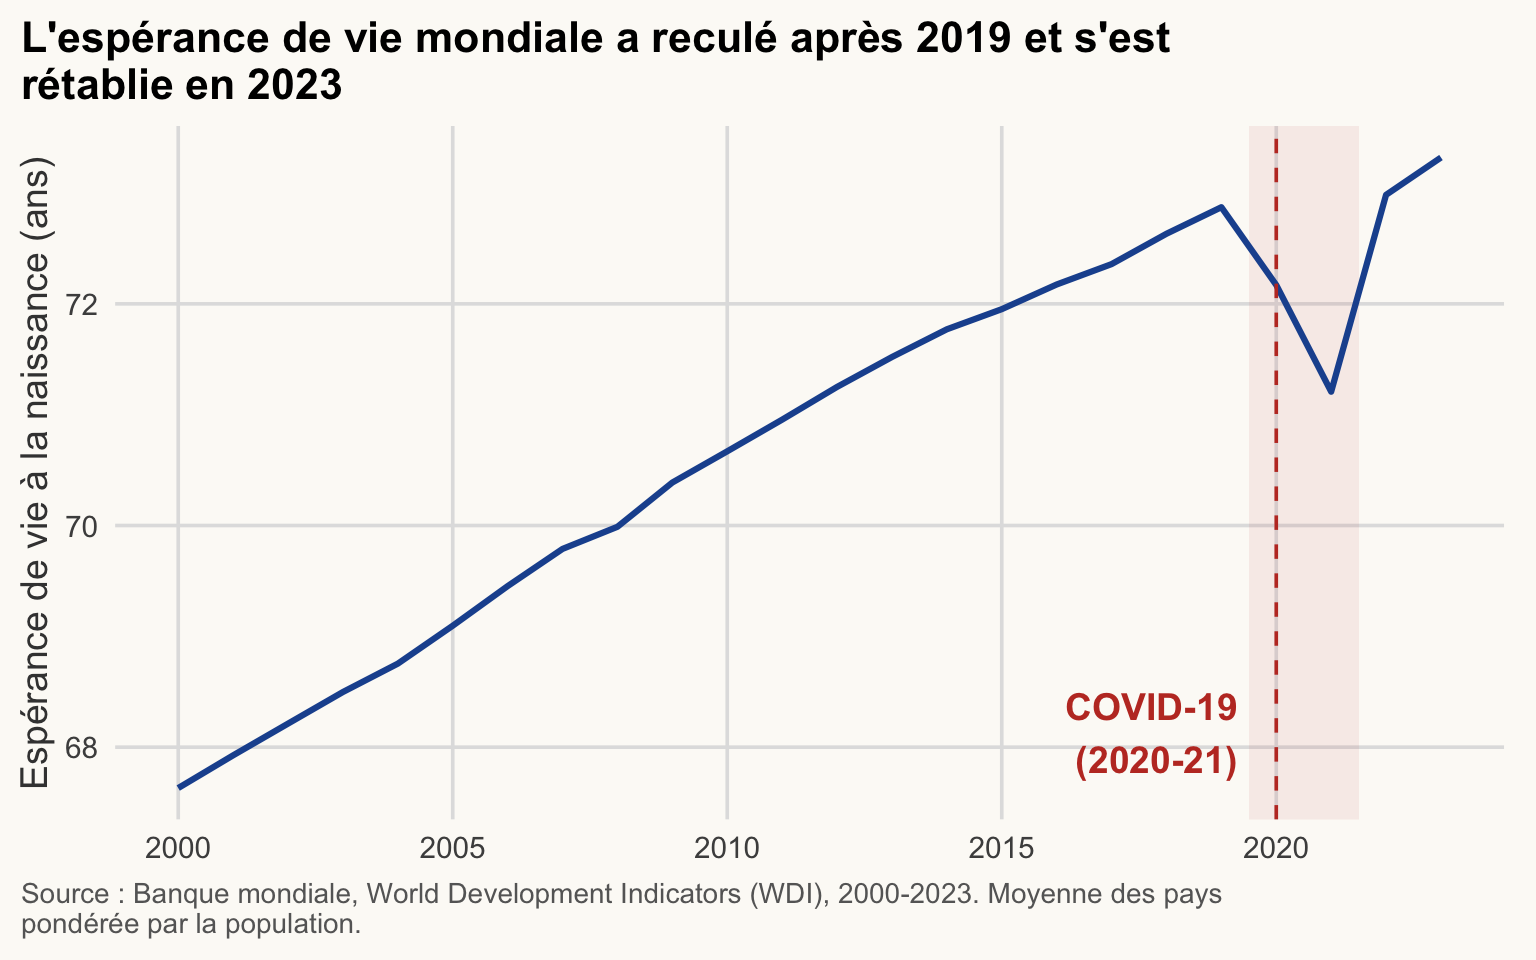
NoteComment lire ce graphique
- La ligne bleue est l’espérance de vie mondiale pondérée par la population, année après année.
- La bande colorée et la ligne en pointillés marquent les années de pandémie (2020-21).
- Regardez l’ampleur du recul par rapport à la longue tendance à la hausse qui le précède : le niveau de 2021 est proche de celui de 2011, la pandémie a donc effacé une dizaine d’années de progrès ; la courbe repasse au-dessus de son niveau de 2019 dès 2022.
Entre 2019 et 2021, la moyenne pondérée est passée de 72,9 à 71,2 ans ; en 2023, elle atteignait 73,3 ans.
AvertissementErreur fréquente
Des axes malhonnêtes. Un graphique en courbe n’a pas besoin de commencer à zéro, mais sachez que l’étendue de l’axe des y change l’impression visuelle de la baisse. Ici, l’axe suit les données ; indiquez les chiffres (comme dans la phrase ci-dessus) pour que les lecteurs ne soient pas trompés par la seule pente.
Combiner des graphiques avec patchwork
≈ 25 min Après cette section, vous saurez combiner plusieurs graphiques en une seule figure étiquetée.
patchwork assemble plusieurs objets ggplot avec des opérateurs arithmétiques :
| Opérateur | Signification |
|---|---|
p1 \| p2 |
côte à côte |
p1 / p2 |
empilés |
(p1 \| p2) / p3 |
regroupement avec des parenthèses |
Ensuite, plot_annotation() ajoute un titre global, une note de source et des étiquettes de panneaux, et plot_layout() contrôle les largeurs, les hauteurs et les légendes. (Il existe aussi cowplot ; un seul outil suffit, nous n’utilisons que patchwork.)
p_scatter <- ggplot(wdi_2022, aes(x = gdp_pc_ppp, y = life_exp, colour = region)) +
  geom_point(alpha = 0.7) +
  scale_colour_manual(values = pal_regions, name = NULL) +
  scale_x_log10(labels = label_dollar(scale_cut = cut_short_scale())) +
  labs(x = "PIB par habitant, PPA ($ PPA de 2021, log)", y = "Esp. de vie (ans)")

p_box <- wdi_2022 |>
  ggplot(aes(x = fct_reorder(region, life_exp), y = life_exp, fill = region)) +
  geom_boxplot(show.legend = FALSE) +
  scale_fill_manual(values = pal_regions) +
  coord_flip() +
  labs(x = NULL, y = "Espérance de vie (ans)")

p_hist <- ggplot(wdi_2022, aes(x = life_exp)) +
  geom_histogram(binwidth = 2, fill = pal_cours[["principal"]], colour = "white") +
  labs(x = "Espérance de vie (ans)", y = "Effectif")

((p_scatter | p_box) / p_hist) +
  plot_layout(guides = "collect", heights = c(2, 1)) +
  plot_annotation(
    title = "Espérance de vie en 2022 : en hausse avec le revenu, avec de grands écarts régionaux",
    caption = "Source : Banque mondiale, World Development Indicators (WDI), 2022. Une observation = un pays.",
    tag_levels = "A"
  ) &
  theme(legend.position = "bottom", legend.text = element_text(size = 9))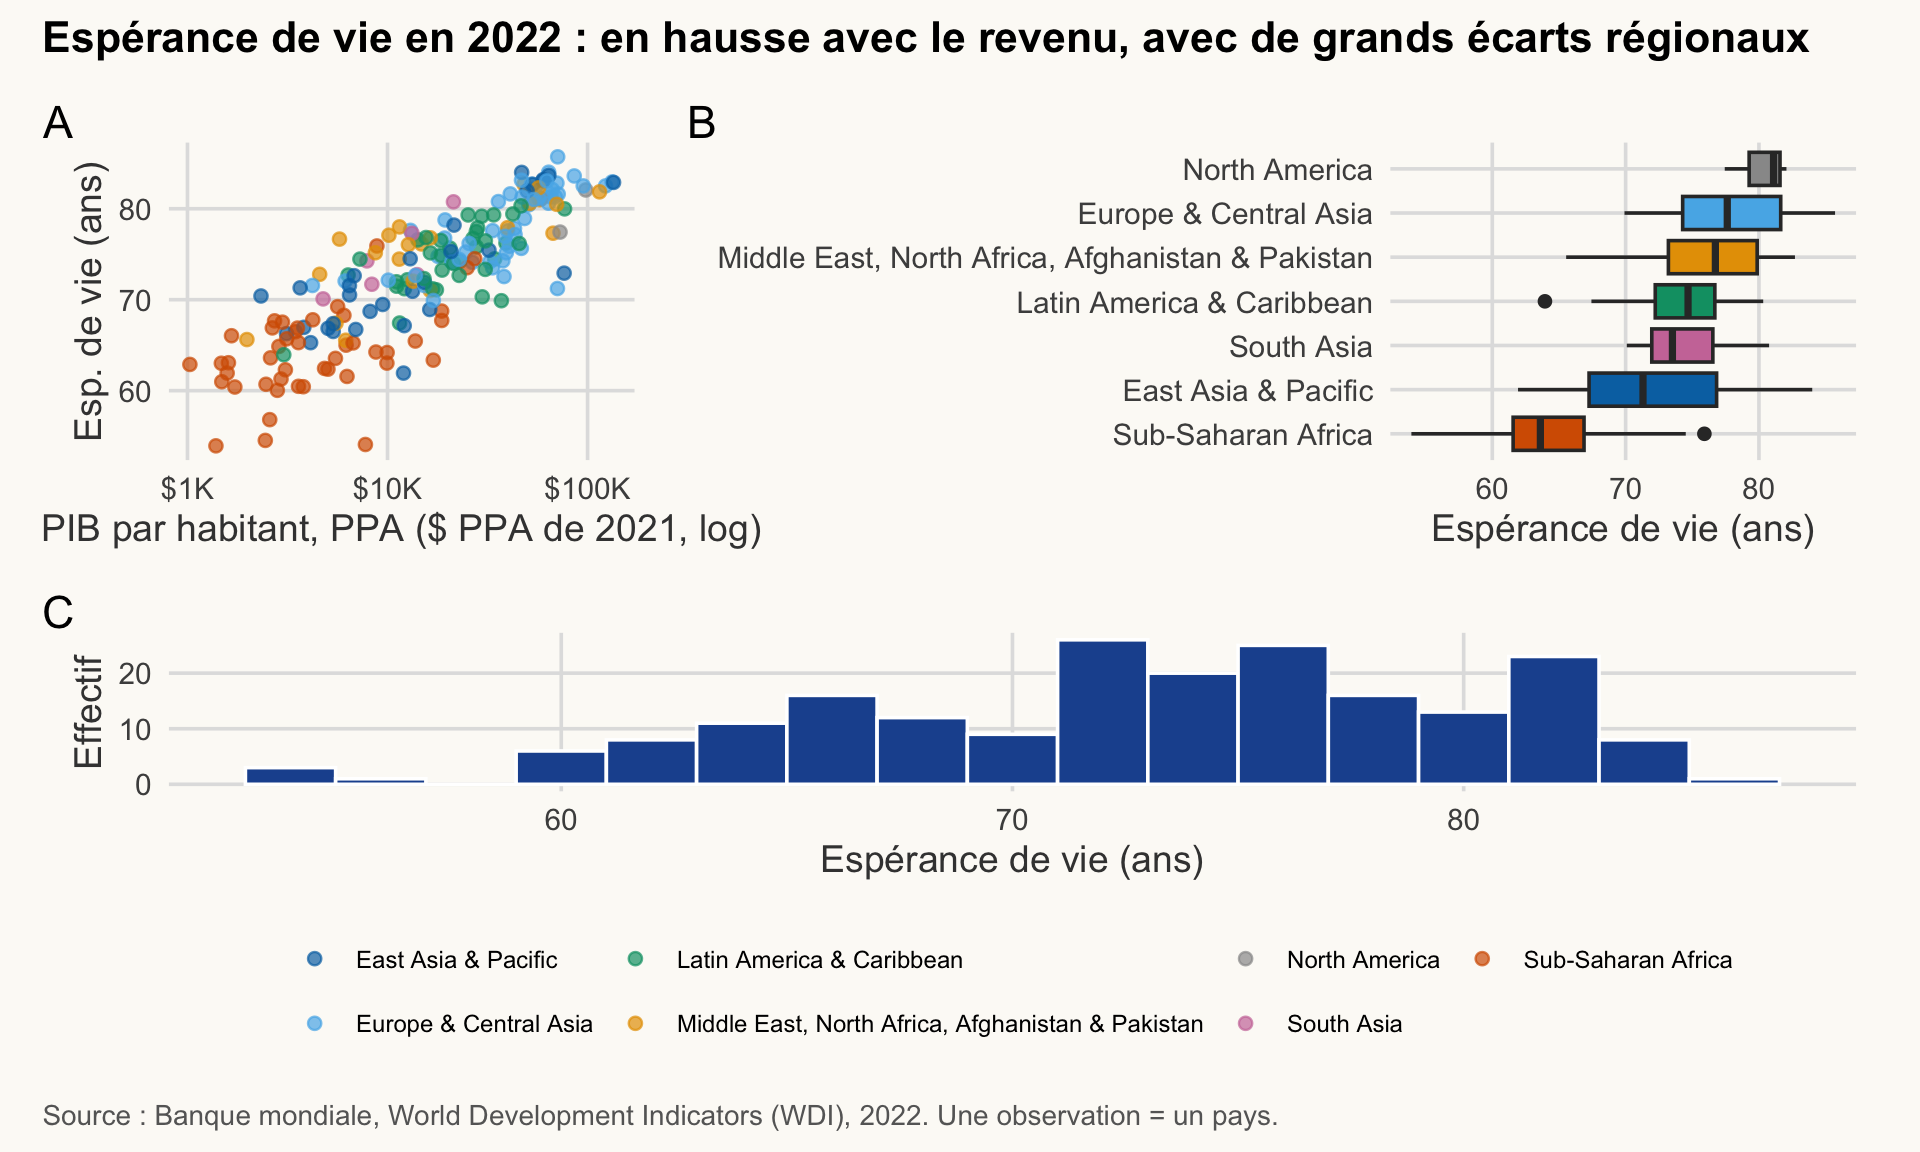
NoteComment lire ce graphique
- A (nuage de points) : la relation revenu-santé, un point par pays.
- B (boîtes à moustaches) : le même résultat par région, ordonné par médiane ; les boîtes montrent à quel point les régions diffèrent et se recoupent.
- C (histogramme) : la distribution d’ensemble de l’espérance de vie entre les pays.
- Ensemble : la forme de la relation (A), la position des régions (B) et la dispersion globale (C).
-
plot_layout(guides = "collect")fusionne les légendes identiques en une seule ; -
plot_annotation(tag_levels = "A")étiquette les panneaux A, B, C (pour s’y référer dans le texte) ; -
&applique un réglage à tous les sous-graphiques (+ne toucherait que le dernier).
Dans un rapport, vous écrivez « La figure 1B montre… » et le lecteur la trouve immédiatement.
ImportantIdée clé
Une figure, un message. Patchwork combine des panneaux qui soutiennent le même message ; ce n’est pas un moyen de faire tenir sur une page des graphiques sans rapport.
AstuceExercice 6.3
Construisez une figure à deux panneaux côte à côte : (A) la série temporelle de l’espérance de vie par région (trend_region, une ligne colorée par région avec pal_regions), (B) un nuage de points de elec_access en fonction de gdp_pc_ppp en 2021 (x en échelle logarithmique). Rassemblez la légende (à droite, avec des étiquettes renvoyées à la ligne), étiquetez les panneaux et ajoutez un titre.
NoteAfficher la solution
# Seul le panneau B garde une légende : les deux panneaux utilisent les mêmes couleurs
pA <- ggplot(trend_region, aes(x = year, y = life_exp, colour = region)) +
  geom_line(linewidth = 1, show.legend = FALSE) +
  scale_colour_manual(values = pal_regions) +
  labs(x = NULL, y = "Espérance de vie (ans)")

pB <- wdi |>
  filter(year == 2021) |>
  drop_na(elec_access, gdp_pc_ppp, region) |>
  ggplot(aes(x = gdp_pc_ppp, y = elec_access, colour = region)) +
  geom_point(alpha = 0.7) +
  scale_colour_manual(values = pal_regions, name = NULL,
                      labels = label_wrap(24)) +
  scale_x_log10(breaks = c(1e3, 1e4, 1e5),
                labels = label_dollar(scale_cut = cut_short_scale())) +
  labs(x = "PIB par habitant, PPA ($ PPA de 2021, log)",
       y = "Accès à l'électricité (% de la population)")

(pA | pB) +
  plot_layout(guides = "collect") +
  plot_annotation(
    title = "La santé s'est améliorée partout ; l'accès à l'électricité dépend du revenu",
    caption = str_wrap("Source : Banque mondiale, World Development Indicators (WDI). A : moyennes régionales simples, 2000-2023 ; B : pays, 2021.", 100),
    tag_levels = "A"
  ) &
  theme(legend.position = "right", legend.text = element_text(size = 9))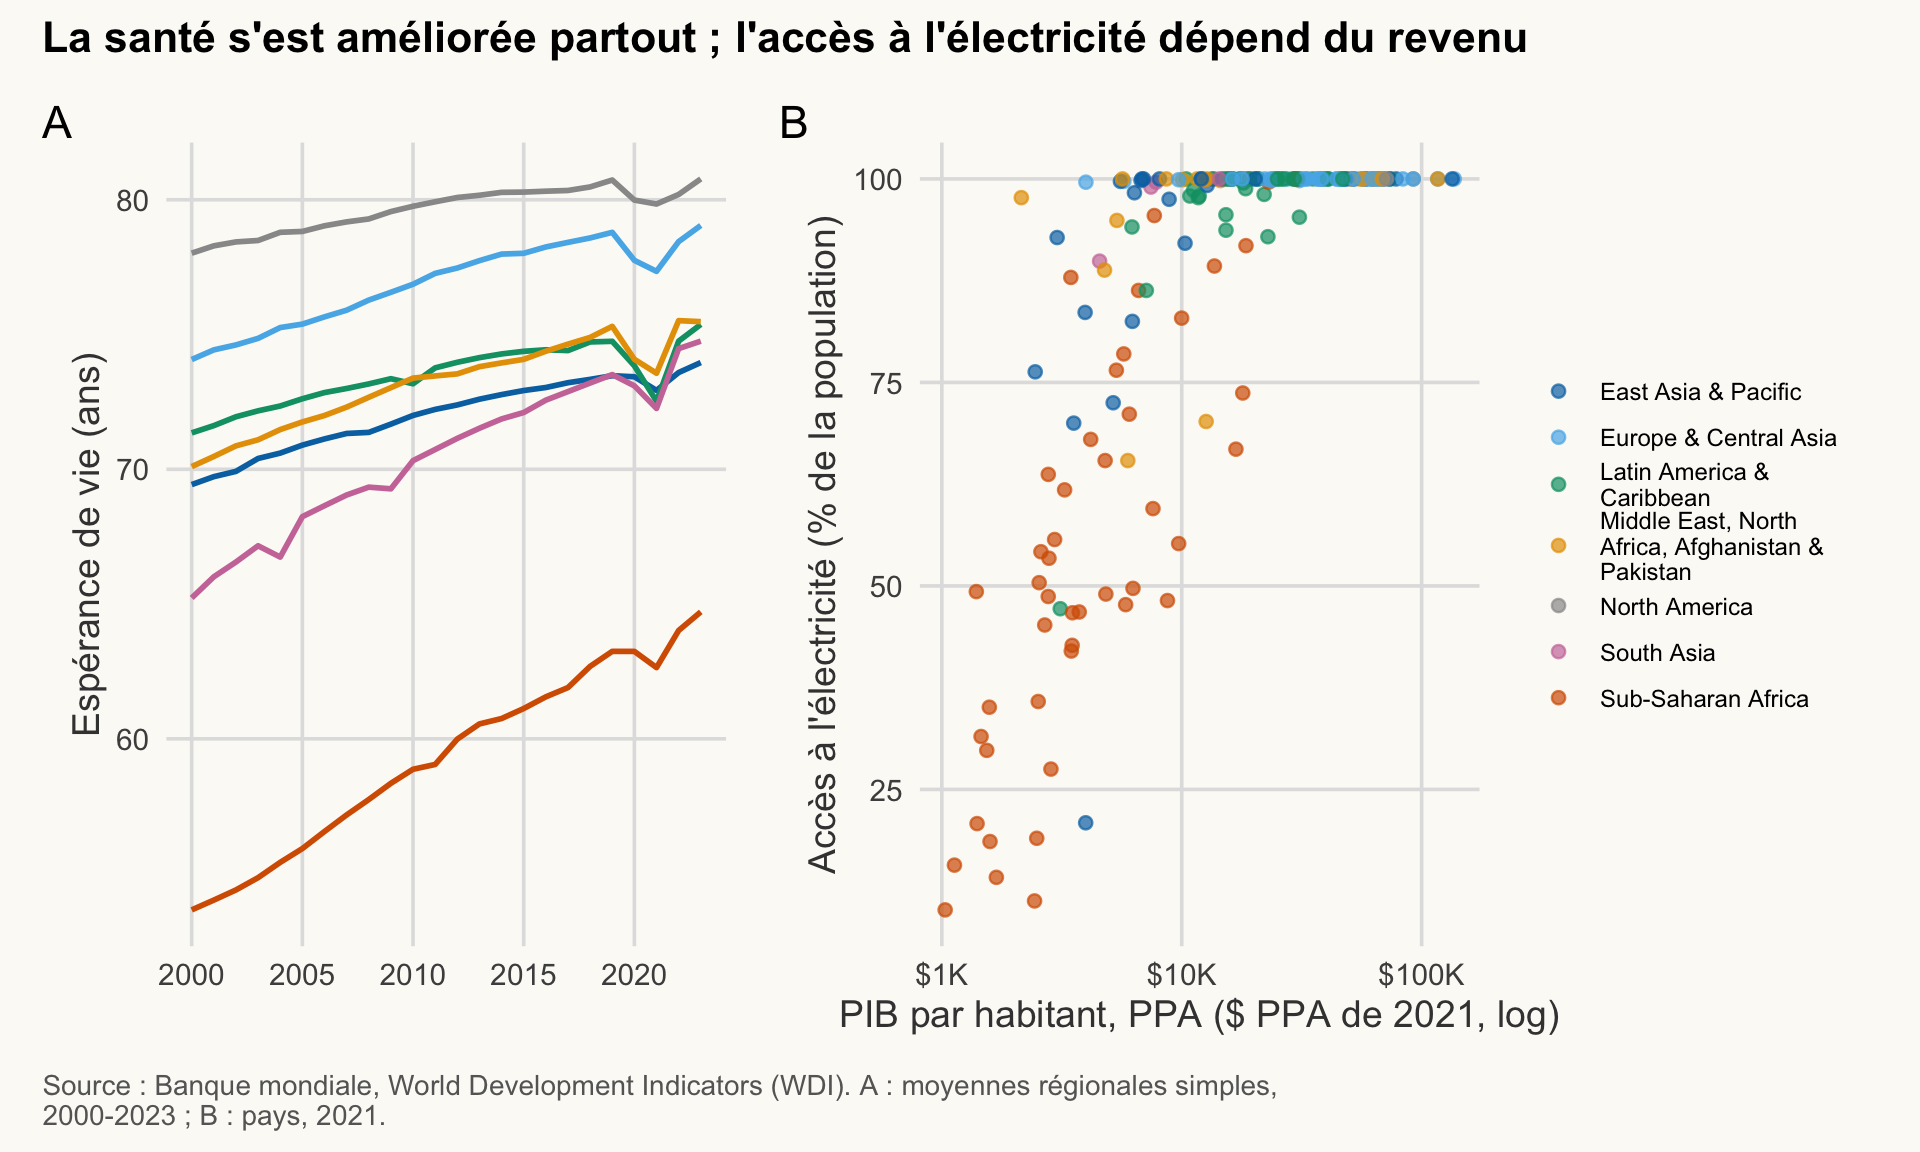
Exporter des figures avec ggsave()
≈ 5 min Après cette section, vous saurez exporter une figure depuis le code, exactement à la taille voulue.
N’exportez jamais par capture d’écran. ggsave() écrit un fichier à une taille et une résolution exactes, depuis le code, de sorte que la figure est reproductible.
dir.create(here("output"), showWarnings = FALSE)

fig <- p_scatter + labs(title = "L'espérance de vie augmente avec le revenu",
                        caption = "Source : Banque mondiale, World Development Indicators (WDI), 2022.")

# Raster pour Word / le web : PNG à 300 dpi
ggsave(here("output", "life_exp_income.png"), plot = fig,
       width = 16, height = 10, units = "cm", dpi = 300)

# Vectoriel pour LaTeX / l'impression : PDF (sans flou à l'agrandissement)
ggsave(here("output", "life_exp_income.pdf"), plot = fig,
       width = 16, height = 10, units = "cm")
Repères pour les tailles :
| Destination | Taille | Format | Taille du texte |
|---|---|---|---|
| Word / note PDF (page portrait) | 14–16 cm de large, 9–11 cm de haut | PNG 300 dpi ou PDF |
base_size 11–12 |
| Diapositives (16:9) | 24–25 cm de large, 13–14 cm de haut | PNG 300 dpi |
base_size 16–20 |
AvertissementErreur fréquente
Exporter à 25 cm puis réduire à 15 cm dans Word : le texte devient illisible. Règle : à la taille finale, titres et titres d’axes d’au moins 11 pt, et aucun texte (graduations, note de source) sous 8 pt. Avec theme_cours(base_size = 11) exporté à la taille finale, c’est exactement ce que vous obtenez : titre d’environ 13 pt, titres d’axes de 11 pt, graduations d’environ 9 pt. Exportez à la taille finale, puis vérifiez le texte.
Le dimensionnement est une décision de conception : si vous exportez un graphique à 25 cm et le réduisez à 15 cm dans Word, le texte devient illisible. Exportez à la taille finale imprimée, avec un base_size adapté (theme_cours(base_size = 11)).
Ces blocs de code utilisent eval: false : les exécuter sur cette page écrirait des fichiers. Exécutez-les dans votre propre projet ; les fichiers apparaissent dans output/.
Interactivité avec plotly
≈ 15 min, exercice 6.4 inclus Après cette section, vous saurez rendre un graphique interactif pour le web, et savoir quand ne pas le faire.
ggplotly() convertit un ggplot en widget HTML interactif : survol, zoom, clic sur la légende pour masquer un groupe. Il fonctionne dans les pages HTML et dans le Viewer de RStudio, pas dans Word ni en PDF.
L’infobulle est contrôlée par une esthétique qui porte son texte, ici label. Nous construisons une étiquette avec le nom du pays et les valeurs, nous l’associons avec label = tip, puis nous la sélectionnons avec tooltip = "label".
wdi_hover <- wdi_2022 |>
  mutate(
    tip = paste0(
      "<b>", country, "</b><br>",
      "GDP per capita: ", label_dollar()(round(gdp_pc_ppp)), "<br>",
      "Life expectancy: ", round(life_exp, 1), " years"
    )
  )

p_int <- ggplot(wdi_hover, aes(x = gdp_pc_ppp, y = life_exp,
                               colour = region, label = tip)) +
  geom_point(alpha = 0.7) +
  scale_colour_manual(values = pal_regions, name = NULL) +
  scale_x_log10(labels = label_dollar(scale_cut = cut_short_scale())) +
  labs(
    title = "Survolez un point pour identifier le pays",
    x = "PIB par habitant, PPA (en $ PPA de 2021, échelle log)",
    y = "Espérance de vie à la naissance (ans)"
  )

ggplotly(p_int, tooltip = "label") |>
  layout(height = 520, legend = list(orientation = "h", x = 0, y = -0.25),
         margin = list(b = 140, t = 60), font = list(family = "IBM Plex Sans"),
         paper_bgcolor = "#fcfaf6", plot_bgcolor = "#fcfaf6")
Remarques :
-
label = tiptransporte le texte de l’infobulle (plotly accepte les balises HTML comme<b>et<br>). L’esthétiquetextfonctionne aussi, mais déclenche un avertissement ggplot2 « unknown aesthetic », d’où l’usage delabel. -
tooltip = "label"n’affiche que ce champ, au lieu des x, y et couleur par défaut. - La légende et le titre sont rendus par plotly : la note de source n’est pas reprise, placez donc la source dans le texte environnant de la page.
Graphiques liés avec crosstalk (Facultatif : pour aller plus loin, ≈ 10 min)
crosstalk relie des widgets qui partagent les mêmes données. Ci-dessous, un menu déroulant filtre deux graphiques à la fois, et sélectionner des points dans l’un les met en évidence dans l’autre.
shared_wdi <- SharedData$new(wdi_hover, key = ~iso3c)

p_left <- plot_ly(shared_wdi, x = ~gdp_pc_ppp, y = ~life_exp,
                  color = ~region, colors = unname(pal_regions),
                  text = ~tip, hoverinfo = "text",
                  type = "scatter", mode = "markers") |>
  layout(xaxis = list(title = "PIB par habitant, PPA ($ PPA de 2021)", type = "log"),
         yaxis = list(title = "Espérance de vie (ans)"),
         showlegend = FALSE)

p_right <- plot_ly(shared_wdi, x = ~elec_access, y = ~life_exp,
                   color = ~region, colors = unname(pal_regions),
                   text = ~tip, hoverinfo = "text",
                   type = "scatter", mode = "markers") |>
  layout(xaxis = list(title = "Accès à l'électricité (% de la population)"),
         yaxis = list(title = "Espérance de vie (ans)"),
         showlegend = FALSE)

bscols(
  widths = c(12, 6, 6),
  filter_select("region", "Region", shared_wdi, ~region),
  p_left, p_right
)SharedData$new() enveloppe les données ; key identifie chaque pays d’un graphique à l’autre ; filter_select() crée le menu déroulant ; bscols() dispose les éléments sur une grille de 12 colonnes. (Utilisez l’outil de sélection par rectangle de la barre d’outils plotly pour sélectionner plusieurs pays : ils restent en surbrillance dans l’autre graphique.)
AvertissementErreur fréquente
Interactif ne veut pas dire meilleur. Les graphiques interactifs sont un complément, pas un remplacement. Une note de politique publique se lit sur papier ou dans Word : elle a besoin d’une bonne figure statique. Réservez l’interactivité à l’exploration et aux tableaux de bord web.
NotePourquoi c’est important en économie du développement
Les publics institutionnels lisent des notes sur papier, mais les analystes qui explorent 200 pays ont besoin de se demander « quel est ce point ? ». Utilisez le survol pour explorer, puis publiez une figure statique qui énonce le message.
AstuceExercice 6.4
Transformez le graphique à facettes de l’espérance de vie en fonction du PIB par habitant (section « Facettes », facet_wrap(~ region)) en graphique interactif avec plotly. L’infobulle doit afficher le nom du pays, le PIB par habitant et l’espérance de vie.
NoteAfficher la solution
p_facet_int <- ggplot(wdi_hover, aes(x = gdp_pc_ppp, y = life_exp,
                                     colour = region, label = tip)) +
  geom_point(alpha = 0.7, show.legend = FALSE) +
  scale_colour_manual(values = pal_regions) +
  scale_x_log10(breaks = c(1e3, 1e4, 1e5),
                labels = label_dollar(scale_cut = cut_short_scale())) +
  facet_wrap(~ region, ncol = 3, labeller = label_wrap_gen(20)) +
  labs(x = "PIB par habitant, PPA (en $ PPA de 2021, échelle log)",
       y = "Espérance de vie (ans)")

ggplotly(p_facet_int, tooltip = "label")
Shiny : une application est une fonction de ses entrées (Facultatif : pour aller plus loin, ≈ 15 min)
Après cette section, vous saurez lire une application Shiny et dire ce que fait chaque partie.
Shiny construit des applications web en R. Une application comporte deux parties : une ui (ce que voit l’utilisateur : menus, curseurs, zone de graphique) et un server (du code R qui recalcule les sorties quand une entrée change).
flowchart LR
  A[L'utilisateur déplace un contrôle] --> B[input$year, input$region]
  B --> C[le serveur recalcule]
  C --> D[output$scatter se redessine]
  D --> A
ImportantIdée clé
Une application Shiny a besoin d’un processus R en cours d’exécution derrière elle. Elle ne peut pas tourner sur cette page, qui est du HTML statique. Le bloc ci-dessous est affiché mais non exécuté : copiez-le pour l’essayer sur votre ordinateur.
Pour l’exécuter en local : installez Shiny (install.packages("shiny"), une seule fois, dans la console : Shiny n’est pas installé avec le tidyverse), enregistrez le code ci-dessous dans un fichier nommé app.R à la racine de votre projet (à côté du dossier data/), ouvrez app.R dans RStudio et cliquez sur Run App.
library(shiny)
library(tidyverse)
library(here)

wdi <- read_csv(here("data", "wdi_panel.csv"), show_col_types = FALSE)

num_vars <- c(
  "GDP per capita (PPP)"         = "gdp_pc_ppp",
  "Life expectancy (years)"      = "life_exp",
  "Gini index"                   = "gini",
  "Access to electricity (%)"    = "elec_access"
)

ui <- fluidPage(
  titlePanel("WDI explorer"),
  sidebarLayout(
    sidebarPanel(
      selectInput("xvar", "X-axis", choices = num_vars, selected = "gdp_pc_ppp"),
      selectInput("yvar", "Y-axis", choices = num_vars, selected = "life_exp"),
      selectInput("region", "Region",
                  choices = c("All", sort(unique(wdi$region)))),
      sliderInput("year", "Year", min = 2000, max = 2023, value = 2022,
                  step = 1, sep = "")
    ),
    mainPanel(plotOutput("scatter"))
  )
)

server <- function(input, output) {

  # Réactif : recalculé seulement quand la région ou l'année change
  wdi_sel <- reactive({
    wdi |>
      filter(year == input$year,
             input$region == "All" | region == input$region)
  })

  output$scatter <- renderPlot({
    # .data[[ ]] lit une colonne dont le NOM est stocké dans une chaîne
    # (cela remplace aes_string(), déprécié)
    ggplot(wdi_sel(), aes(x = .data[[input$xvar]], y = .data[[input$yvar]])) +
      geom_point(colour = "#1f4e79", alpha = 0.7, na.rm = TRUE) +
      labs(
        title = paste(names(num_vars)[num_vars == input$yvar], "vs",
                      names(num_vars)[num_vars == input$xvar]),
        x = names(num_vars)[num_vars == input$xvar],
        y = names(num_vars)[num_vars == input$yvar],
        caption = "Source : Banque mondiale, WDI."
      ) +
      theme_minimal(base_size = 14)
  })
}

shinyApp(ui = ui, server = server)
Ce qu’il faut lire dans ce code :
-
selectInput(),sliderInput()créent les contrôles ; leurs valeurs arrivent dansinput$xvar,input$year, etc. -
reactive()définit un data frame qui n’est recalculé que lorsque les entrées qu’il utilise changent ; vous l’appelez comme une fonction :wdi_sel(). -
renderPlot()redessine le graphique quand une entrée change ;plotOutput("scatter")dans l’interface l’affiche. -
aes(x = .data[[input$xvar]])est la manière moderne d’associer une colonne choisie par son nom.
Les applications Shiny se déploient sur un serveur (shinyapps.io, Posit Connect) pour être partagées : hors du périmètre de cette séance.
Rapports reproductibles avec Quarto
Pourquoi un document dynamique ?
≈ 25 min Après cette section, vous saurez écrire un rapport qui régénère lui-même ses chiffres et ses figures.
Sans cela, la démarche est la suivante : exécuter un script, copier une figure dans Word, retaper les chiffres. Quand les données ou le code changent, tout est à refaire à la main, et un chiffre obsolète se glisse dans le rapport. Dans un document dynamique (literate document), texte, code, figures et chiffres vivent dans le même fichier : vous le générez, et tout est régénéré à partir des données. Le rapport est sa propre piste d’audit.
Quarto (.qmd) combine trois éléments :
- un en-tête YAML (titre, auteur, format de sortie) ;
- du texte en Markdown ;
- des blocs de code et du code en ligne, exécutés à la génération.
Le site web de ce cours est lui-même construit avec Quarto.
flowchart LR
  A[".qmd file"] --> B["knitr exécute le code R"]
  B --> C["Markdown avec résultats"]
  C --> D["pandoc convertit"]
  D --> E["HTML, PDF ou Word"]
ImportantIdée clé
La génération ré-exécute tout le code. Les chiffres du texte viennent des données, donc le rapport ne peut pas contredire l’analyse.
Anatomie d’un fichier .qmd
En-tête YAML : le bloc entre deux lignes --- en haut du fichier. Il contient le titre, l’auteur, la date et les formats de sortie.
Texte : du Markdown ordinaire (titres ##, gras, listes). Le code en ligne (voir plus bas) insère une valeur calculée.
Bloc de code (chunk) : du code R entre des délimiteurs ```{r}, avec des options comme #| fig-cap:. Les sorties (tableaux, figures) apparaissent juste en dessous.
Un rapport minimal
Créez un nouveau fichier avec File > New File > Quarto Document, enregistrez-le sous le nom report.qmd dans votre projet, et collez le modèle ci-dessous. Le bloc markdown ci-dessous ne fait que montrer le fichier, il n’est pas exécuté.
---
title: "Life expectancy and income: a note"
author: "Your name"
date: today
format:
  html: default
  docx: default
execute:
  echo: false
  warning: false
---

```{r}
#| label: setup
library(tidyverse)
library(here)

wdi <- read_csv(here("data", "wdi_panel.csv"), show_col_types = FALSE)
# CAF life expectancy is unreliable in this WDI release (14.7 in 2009, 18.8 in 2022): exclude every year
wdi <- wdi |> mutate(life_exp = if_else(iso3c == "CAF", NA_real_, life_exp))
wdi_2022 <- wdi |> filter(year == 2022) |> drop_na(gdp_pc_ppp, life_exp)
```

## Main result

In 2022, the average life expectancy across 198 countries was
73.1 years. Figure @fig-income shows its
relationship with income.

```{r}
#| label: fig-income
#| fig-cap: "Life expectancy rises with income (log scale). Source: World Bank, WDI (2022)."
#| fig-width: 7
#| fig-height: 4.5
ggplot(wdi_2022, aes(x = gdp_pc_ppp, y = life_exp)) +
  geom_point(alpha = 0.6) +
  scale_x_log10() +
  labs(x = "GDP per capita, PPP (log scale)", y = "Life expectancy (years)")
```
À remarquer :
-
format:liste les sorties :html(web) etdocx(Word).pdffonctionne aussi si LaTeX est installé (tinytex::install_tinytex()). -
198est du code en ligne : R calcule la valeur à la génération, donc le texte ne peut jamais contredire les données. -
#| fig-cap:donne le titre de la figure, affiché sous celle-ci ;#| label: fig-...permet de s’y référer avec@fig-income. -
execute: echo: falsemasque le code dans la sortie, comme dans une note pour un lecteur non technique. Gardezecho: truepour une annexe méthodologique. - Utilisez
here()pour les chemins, comme dans le reste du cours ; le rapport est généré depuis le dossier du projet.
Générer le rapport
- Dans RStudio : cliquez sur Render. Le fichier de sortie apparaît à côté du
.qmd. - Depuis la console ou le terminal :
quarto render report.qmd(tous les formats), ouquarto render report.qmd --to docx.
AvertissementErreur fréquente
Générer le rapport depuis le mauvais dossier, si bien que here() ou les chemins relatifs échouent. Solution : gardez report.qmd dans le projet (à côté de data/) et générez-le depuis là.
AstuceExercice 6.5
Créez report.qmd à partir du modèle ci-dessus. Générez-le en HTML et en Word. Puis changez l’année en 2010, générez-le à nouveau, et vérifiez que le nombre de pays et l’espérance de vie moyenne dans le texte ont changé d’eux-mêmes.
Projet final : la figure de la « note au ministre »
≈ 45 min Après cette section, vous saurez produire une figure prête pour un public décisionnel et la vérifier à l’aide d’une liste de six points.
L’atelier de dataviz en français (Atelier dataviz) prépare une note de politique publique à un ministre (« note au ministre »). Votre tâche ici est d’en produire la figure principale.
AstuceExercice 6.6 (projet final)
Choisissez un indicateur et une comparaison qui comptent pour un sujet de développement de votre choix (pays, régions ou groupes de revenu ; une année, ou l’évolution dans le temps). Tracez une figure qui satisfait cette liste de contrôle (issue de l’atelier) :
Enregistrez-la avec ggsave() à une taille adaptée à une note Word (16 × 10 cm, 300 dpi). Écrivez deux phrases en dessous : ce que le lecteur doit retenir, et une limite.
NoteAfficher la solution (une réponse possible)
Sujet : l’accès à l’énergie en Afrique subsaharienne. Indicateur : accès à l’électricité. Comparaison : 2000 contre 2022, pour les 12 pays ayant aujourd’hui le plus faible accès.
elec_ssa <- wdi |>
  filter(region == "Sub-Saharan Africa", year %in% c(2000, 2022)) |>
  select(country, year, elec_access) |>
  pivot_wider(names_from = year, values_from = elec_access,
              names_prefix = "y") |>
  drop_na(y2000, y2022)

lowest12 <- elec_ssa |>
  slice_min(y2022, n = 12, with_ties = FALSE) |>
  mutate(country = fct_reorder(country, y2022),
         gain = y2022 - y2000)

mean_gain <- round(mean(lowest12$gain))

fig_note <- ggplot(lowest12, aes(y = country)) +
  geom_segment(aes(x = y2000, xend = y2022, yend = country),
               colour = pal_cours[["gris"]], linewidth = 1.2) +
  geom_point(aes(x = y2000, colour = "2000"), size = 3) +
  geom_point(aes(x = y2022, colour = "2022"), size = 3) +
  scale_colour_manual(
    values = c("2000" = pal_cours[["gris"]], "2022" = pal_cours[["accent"]]),
    name = NULL
  ) +
  scale_x_continuous(limits = c(0, 100), labels = label_percent(scale = 1)) +
  labs(
    title = str_wrap(paste0("Là où l'accès est le plus faible, la couverture a tout de même progressé de ",
                            mean_gain, " points en moyenne depuis 2000"), 60),
    subtitle = str_wrap("Population ayant accès à l'électricité, les 12 pays d'Afrique subsaharienne au plus faible accès en 2022", 75),
    x = "Population ayant accès à l'électricité (%)", y = NULL,
    caption = str_wrap(paste("Source : Banque mondiale, World Development Indicators (WDI), 2000 et 2022.",
                             "Pays disposant de données pour les deux années ; sans pondération par la population."), 90)
  )

fig_note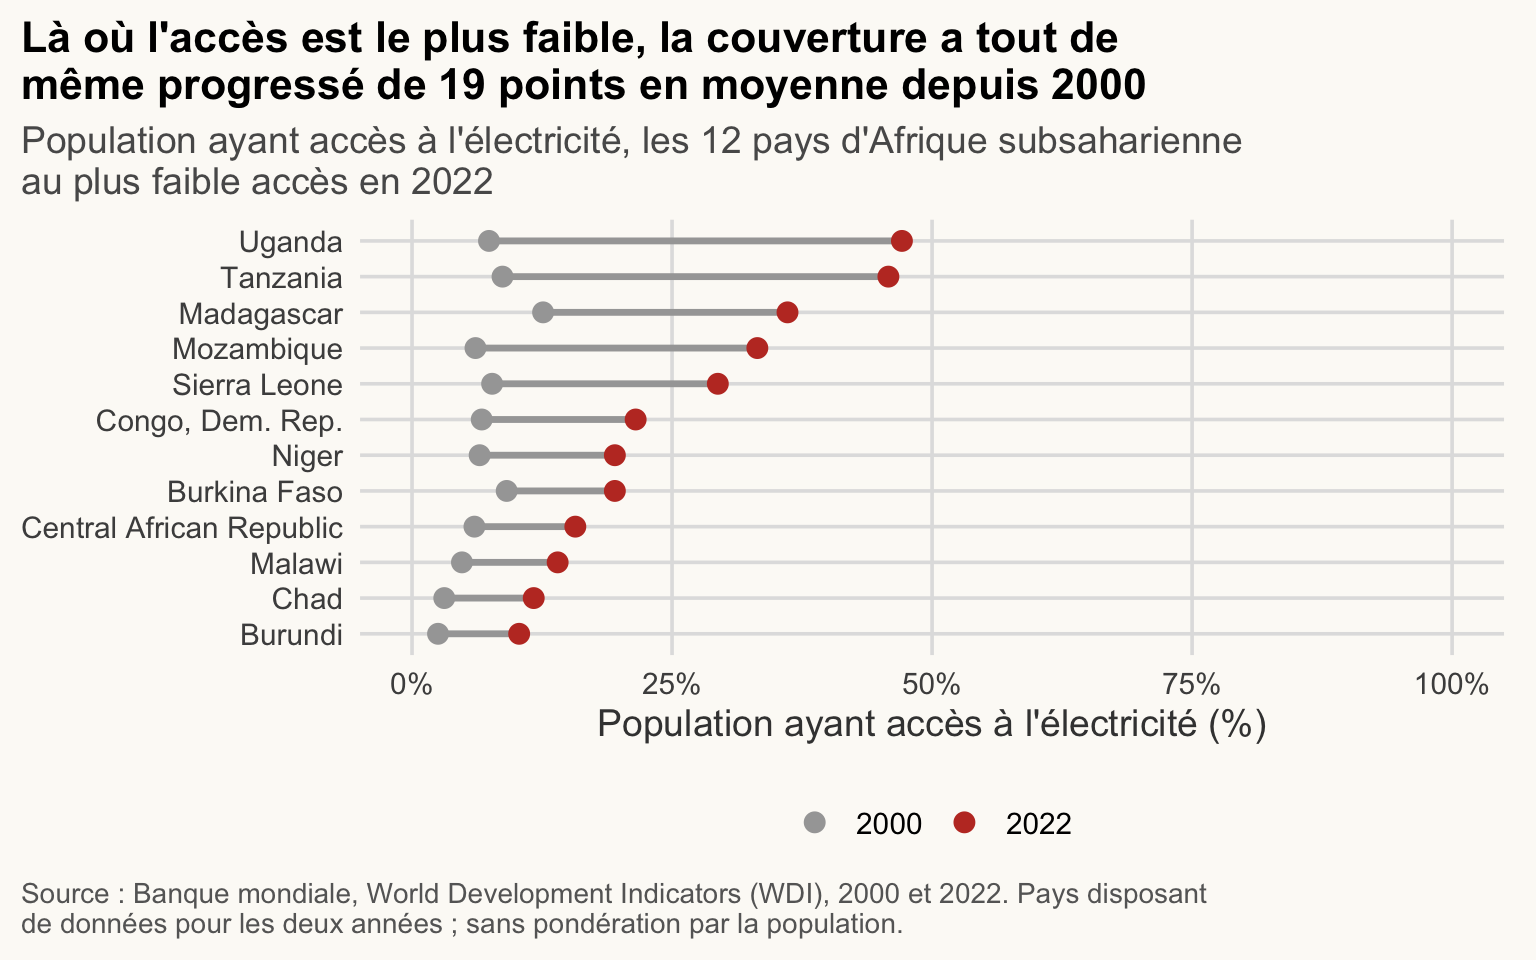
NoteComment lire ce graphique
- Chaque ligne est un pays ; le point gris est 2000 et le point rouge est 2022.
- La longueur du segment est le gain en points : plus long signifie un progrès plus rapide.
- Les pays sont classés par couverture en 2022, donc le bas du graphique est l’endroit où l’accès est le plus faible.
dir.create(here("output"), showWarnings = FALSE)
ggsave(here("output", "note_ministre_electricity.png"), plot = fig_note,
       width = 16, height = 11, units = "cm", dpi = 300)
Ce que le lecteur retient : l’accès a progressé dans les douze pays, mais dans plusieurs il reste très inférieur à une couverture universelle. Limite : les moyennes nationales masquent l’écart urbain-rural, et la sélection (les 12 plus bas en 2022) est définie sur l’année finale, elle ne dit donc rien des pays qui se sont améliorés le plus vite.
Liste de contrôle : titre-message (1) ; un indicateur et une comparaison (2) ; unités en % (3) ; source et années (4) ; couleur uniquement pour l’année focale, pays ordonnés (5) ; règle de sélection et absence de pondération indiquées (6).
Conclusion
NotePourquoi c’est important en économie du développement
Un résultat que le ministre ne peut pas lire ne change rien. La figure est la dernière étape de l’analyse, et souvent la seule qu’un décideur voit.
Vous avez commencé ce cours sans savoir ce qu’est une console. Vous savez maintenant importer et nettoyer des données de développement, les joindre correctement, les décrire et les modéliser en étant honnête sur leurs limites, les cartographier et les représenter, et envelopper le tout dans un rapport qui se régénère à partir du code. Les habitudes comptent plus que les fonctions : du code dans des scripts, des chemins relatifs, un seul thème, des chiffres calculés et non tapés, et un titre qui énonce le résultat.
Pour aller plus loin
- Livres (gratuits en ligne) : R for Data Science (2e éd., Wickham, Çetinkaya-Rundel, Grolemund) sur r4ds.hadley.nz (en anglais) ; ggplot2: Elegant Graphics for Data Analysis sur ggplot2-book.org ; la documentation de Quarto sur quarto.org.
-
Prochains thèmes : régressions sur données de panel avec
fixest, différences de différences et analyse de texte. - Pratique : choisissez une question, trouvez les données et rédigez une note de deux pages dans Quarto. C’est ainsi qu’on apprend vraiment.
Les liens vers d’autres livres, communautés et outils sont rassemblés dans la page Ressources.
À retenir
-
facet_wrap()etfacet_grid()produisent des petits multiples ; gardez les échelles fixes, sauf si vous ne comparez que des formes. -
theme()modifie les éléments non liés aux données avecelement_text/line/rect/blank; un thème complet vient avant vos retouches, ettheme_set()définit le thème par défaut une fois pour toutes. - Un message a besoin d’annotations : un titre qui énonce le résultat, des lignes de référence et de courtes étiquettes.
- Avec patchwork,
|et/assemblent les graphiques,plot_layout(guides = "collect")fusionne les légendes,plot_annotation(tag_levels = "A")étiquette les panneaux. - Exportez avec
ggsave()à la taille finale imprimée : PNG 300 dpi pour Word et les diapositives, PDF pour LaTeX. - plotly (survol, avec une infobulle
label) et, facultativement, crosstalk (filtres liés) ne fonctionnent qu’en HTML ; Shiny (facultatif) a besoin d’une session R en cours d’exécution, il ne peut donc pas tourner sur une page statique. - Un rapport Quarto régénère texte, figures et chiffres en ligne à partir des données : c’est la reproductibilité en pratique.
C’est la dernière séance. Revenez à n’importe quelle séance précédente depuis le menu Séances, et essayez l’atelier dataviz pour vous entraîner au projet final.
Comment fonctionne
theme()Un thème est une liste de réglages pour chaque élément non lié aux données : texte, axes, grille, légende, arrière-plan. Vous modifiez un élément avec
theme(element = element_*(...)), où le constructeur dépend du type d’élément :element_text()plot.title = element_text(face = "bold")element_line()panel.grid.major = element_line(colour = "grey90")element_rect()panel.background = element_rect(fill = "white")element_blank()panel.grid.minor = element_blank()Les réglages sont hérités :
axis.titlecontrôleaxis.title.xetaxis.title.y, ettextcontrôle tout. Deux règles utiles :theme_minimal(),theme_cours()) doit venir avant vos propres retouchestheme(), sinon il les efface.Ajouter
theme_minimal()outheme_cours()après vos propres retouchestheme(): le thème complet les écrase et vos changements semblent ignorés. Solution : le thème complet d’abord, les retouches en dernier.