Sys.setenv(LANGUAGE = "en")   # messages de R en anglais
library(tidyverse)   # dplyr, tidyr, forcats, ggplot2, readr...
library(here)
source(here("R", "theme_cours.R"))

wdi <- read_csv(here("data", "wdi_panel.csv"), show_col_types = FALSE)
# L'espérance de vie de la RCA n'est pas fiable dans cette version des WDI (14,7 en 2009, 18,8 en 2022) : on l'exclut pour toutes les années
wdi <- wdi |> mutate(life_exp = if_else(iso3c == "CAF", NA_real_, life_exp))Séance 3 : Manipuler les données (dplyr, tidyr, jointures)
dplyr, tidyr et jointures : de la table brute à la table dont vous avez besoin
Objectifs de la séance
- Enchaîner les opérations avec le pipe
|>et utiliser les principaux verbes dedplyr:filter,select,arrange,mutate,rename,summarise. - Créer des variables avec
case_when()etif_else(); ordonner des catégories avec des facteurs. - Traiter explicitement les valeurs manquantes et toujours indiquer le nombre d’observations (N).
- Passer une table du format large au format long (et inversement) avec
tidyr. - Combiner des tables avec des jointures, et repérer une jointure qui perd silencieusement des observations.
- Trouver l’étape défaillante d’une chaîne en l’exécutant une étape à la fois.
- Écrire une fonction simple.
- Réparer un fichier désordonné dans un script, puis relancer toute l’analyse dans une session R neuve.
Préparer votre session R
Packages utilisés aujourd’hui : tidyverse, here. S’il en manque un : install.packages(c("tidyverse", "here")).
Script de la séance : télécharger seance-3.R, tout le code de cette page dans un seul fichier.
Le fil rouge du cours : « Croissance, santé et inégalités : que disent les données sur les pays en développement ? » Aujourd’hui, nous utilisons le panel de la Banque mondiale (tous les pays, 2000-2023) et apprenons à le découper en morceaux utiles.
glimpse(wdi)Rows: 5,208
Columns: 11
$ country <chr> "Afghanistan", "Afghanistan", "Afghanistan", "Afghanistan"…
$ iso3c <chr> "AFG", "AFG", "AFG", "AFG", "AFG", "AFG", "AFG", "AFG", "A…
$ year <dbl> 2000, 2001, 2002, 2003, 2004, 2005, 2006, 2007, 2008, 2009…
$ region <chr> "Middle East, North Africa, Afghanistan & Pakistan", "Midd…
$ income <chr> "Low income", "Low income", "Low income", "Low income", "L…
$ gdp <dbl> 3521418060, 2813571754, 3825701439, 4520946819, 5224896719…
$ gdp_pc_ppp <dbl> 1617.826, 1454.111, 1774.309, 1815.928, 1776.918, 1908.115…
$ population <dbl> 20130327, 20284307, 21378117, 22733049, 23560654, 24404567…
$ life_exp <dbl> 55.005, 55.511, 56.225, 57.171, 57.810, 58.247, 58.553, 58…
$ gini <dbl> NA, NA, NA, NA, NA, NA, NA, NA, NA, NA, NA, NA, NA, NA, NA…
$ elec_access <dbl> 4.4, 9.3, 14.1, 19.0, 23.8, 28.7, 33.5, 38.4, 42.4, 48.3, …Chaque ligne est un pays-année : 217 pays, 24 années, 5 208 lignes.
Le bloc de préparation applique déjà une correction : l’espérance de vie de la République centrafricaine (CAF) est mise à manquante (NA) pour toutes les années, car cette version de la série n’est pas fiable (la séance 4 le montre). Les résumés de life_exp ci-dessous utilisent donc na.rm = TRUE, qui ignore les valeurs manquantes ; nous l’expliquons dans la section sur les valeurs manquantes.
Rythme. Le parcours principal dure environ 190 minutes, exercices compris. Les exercices 3.3 à 3.7 sont marqués Facultatif : pour aller plus loin et ajoutent environ 45 minutes : faites-les si le temps le permet, ou chez vous.
Le pipe et les principaux verbes
≈ 35 min Après cette section, vous saurez écrire une chaîne de verbes dplyr qui filtre, sélectionne, trie et crée des variables.
Le pipe |>
Le pipe prend ce qui se trouve à sa gauche et le transmet comme premier argument de la fonction à sa droite. Lisez-le comme « et ensuite ».
flowchart LR
  A[wdi] --> B["filter(year == 2020)"]
  B --> C["select(country, life_exp)"]
  C --> D["arrange(desc(life_exp))"]
  D --> E[Table résultat]
Pipe (|>) : un opérateur qui envoie le résultat à sa gauche dans le premier argument de la fonction à sa droite. x |> f(y) équivaut à f(x, y).
# Sans le pipe : on lit de l'intérieur vers l'extérieur
head(arrange(filter(wdi, year == 2020), desc(life_exp)), 3)
# A tibble: 3 × 11
country iso3c year region income gdp gdp_pc_ppp population life_exp gini
<chr> <chr> <dbl> <chr> <chr> <dbl> <dbl> <dbl> <dbl> <dbl>
1 Monaco MCO 2020 Europ… High … 6.73e 9 NA 38050 86.1 NA
2 Hong K… HKG 2020 East … High … 3.45e11 61329. 7481000 85.5 NA
3 Japan JPN 2020 East … High … 5.19e12 44213. 126261000 84.6 32.3
# ℹ 1 more variable: elec_access <dbl># Avec le pipe : on lit de haut en bas
wdi |>
filter(year == 2020) |>
arrange(desc(life_exp)) |>
head(3)# A tibble: 3 × 11
country iso3c year region income gdp gdp_pc_ppp population life_exp gini
<chr> <chr> <dbl> <chr> <chr> <dbl> <dbl> <dbl> <dbl> <dbl>
1 Monaco MCO 2020 Europ… High … 6.73e 9 NA 38050 86.1 NA
2 Hong K… HKG 2020 East … High … 3.45e11 61329. 7481000 85.5 NA
3 Japan JPN 2020 East … High … 5.19e12 44213. 126261000 84.6 32.3
# ℹ 1 more variable: elec_access <dbl>
ImportantIdée clé
Chaque verbe de dplyr prend une table et renvoie une table. C’est pourquoi ils s’enchaînent : un verbe par ligne, à lire de haut en bas comme « et ensuite ».
Note
Les anciens codes que l’on trouve en ligne utilisent le pipe %>% du package magrittr. Il fait presque la même chose. Les deux fonctionnent ; dans ce cours, nous utilisons le pipe natif |>.
filter() : garder des lignes
filter() garde les lignes pour lesquelles la condition est TRUE. Plusieurs conditions séparées par une virgule signifient « et » ; utilisez | pour « ou » et %in% pour « parmi ».
wdi |>
  filter(year == 2020, region == "South Asia") |>
  select(country, life_exp, gdp_pc_ppp)
# A tibble: 6 × 3
country life_exp gdp_pc_ppp
<chr> <dbl> <dbl>
1 Bangladesh 71.4 7015.
2 Bhutan 72.3 12980.
3 India 70.2 7187.
4 Maldives 78.7 14243.
5 Nepal 69.1 4413.
6 Sri Lanka 76.9 13887.wdi |>
filter(year == 2020, iso3c %in% c("FRA", "DEU", "ESP")) |>
select(country, life_exp)# A tibble: 3 × 2
country life_exp
<chr> <dbl>
1 France 82.2
2 Germany 81.0
3 Spain 82.2Opérateurs de comparaison : == (égal ; jamais un seul =), !=, <, <=, >, >=.
select() : garder des colonnes
AvertissementErreur fréquente
Confondre les deux : filter() agit sur les lignes (conditions sur les valeurs), select() agit sur les colonnes (noms). Si R affiche « object not found » (« objet introuvable ») dans un filter(), vérifiez que vous n’avez pas supprimé la colonne avec un select() antérieur.
wdi |> select(country, year, life_exp) |> head(3)# A tibble: 3 × 3
country year life_exp
<chr> <dbl> <dbl>
1 Afghanistan 2000 55.0
2 Afghanistan 2001 55.5
3 Afghanistan 2002 56.2# Aides : sélectionner des colonnes par motif ou par type
wdi |> select(country, starts_with("gdp")) |> head(3)# A tibble: 3 × 3
country gdp gdp_pc_ppp
<chr> <dbl> <dbl>
1 Afghanistan 3521418060. 1618.
2 Afghanistan 2813571754. 1454.
3 Afghanistan 3825701439. 1774.wdi |> select(contains("_")) |> head(3)# A tibble: 3 × 3
gdp_pc_ppp life_exp elec_access
<dbl> <dbl> <dbl>
1 1618. 55.0 4.4
2 1454. 55.5 9.3
3 1774. 56.2 14.1wdi |> select(where(is.numeric)) |> names()[1] "year" "gdp" "gdp_pc_ppp" "population" "life_exp"
[6] "gini" "elec_access"select(-gini) supprime une colonne. select() peut aussi réordonner : select(iso3c, country, everything()).
arrange() : trier les lignes
wdi |>
  filter(year == 2020) |>
  arrange(desc(gdp_pc_ppp)) |>   # desc() = du plus grand au plus petit
  select(country, gdp_pc_ppp) |>
  head(5)
# A tibble: 5 × 2
country gdp_pc_ppp
<chr> <dbl>
1 Luxembourg 129866.
2 Singapore 116684.
3 Qatar 103062.
4 Ireland 101793.
5 Norway 89012.
mutate() et rename() : créer et renommer des colonnes
wdi |>
  filter(year == 2020) |>
  mutate(gdp_bn = gdp / 1e9,                      # PIB en milliards de US$
         pop_m  = population / 1e6) |>            # population en millions
  select(country, gdp_bn, pop_m) |>
  arrange(desc(gdp_bn)) |>
  head(3)
# A tibble: 3 × 3
country gdp_bn pop_m
<chr> <dbl> <dbl>
1 United States 21375. 332.
2 China 14996. 1411.
3 Japan 5189. 126.rename(nouveau_nom = ancien_nom) change le nom d’une colonne :
wdi |> rename(life_expectancy = life_exp) |> names() [1] "country" "iso3c" "year" "region"
[5] "income" "gdp" "gdp_pc_ppp" "population"
[9] "life_expectancy" "gini" "elec_access"
if_else() et case_when() : variables conditionnelles
if_else(condition, valeur_si_vrai, valeur_si_faux) gère deux cas ; case_when() en gère autant que vous voulez. Les conditions sont testées dans l’ordre ; le premier TRUE l’emporte ; .default récupère le reste.
wdi_2020 <- wdi |>
  filter(year == 2020) |>
  mutate(
    high_life = if_else(life_exp >= 75, "75+ years", "under 75"),
    elec_level = case_when(
      elec_access >= 99 ~ "universal (99%+)",
      elec_access >= 80 ~ "high (80-99%)",
      elec_access >= 50 ~ "medium (50-80%)",
      elec_access <  50 ~ "low (<50%)",
      .default = "no data"
    )
  )

wdi_2020 |> count(elec_level)
# A tibble: 5 × 2
elec_level n
<chr> <int>
1 high (80-99%) 31
2 low (<50%) 26
3 medium (50-80%) 23
4 no data 2
5 universal (99%+) 135Afficher le code du graphique (vu en séance 5)
wdi_2020 |>
  count(elec_level) |>
  ggplot(aes(x = n, y = fct_reorder(elec_level, n))) +
  geom_col(fill = pal_cours[["principal"]]) +
  labs(title = "La plupart des pays ont un accès quasi universel à l'électricité",
       x = "Nombre de pays, 2020", y = NULL,
       caption = "Source : Banque mondiale, World Development Indicators (WDI), 2020.")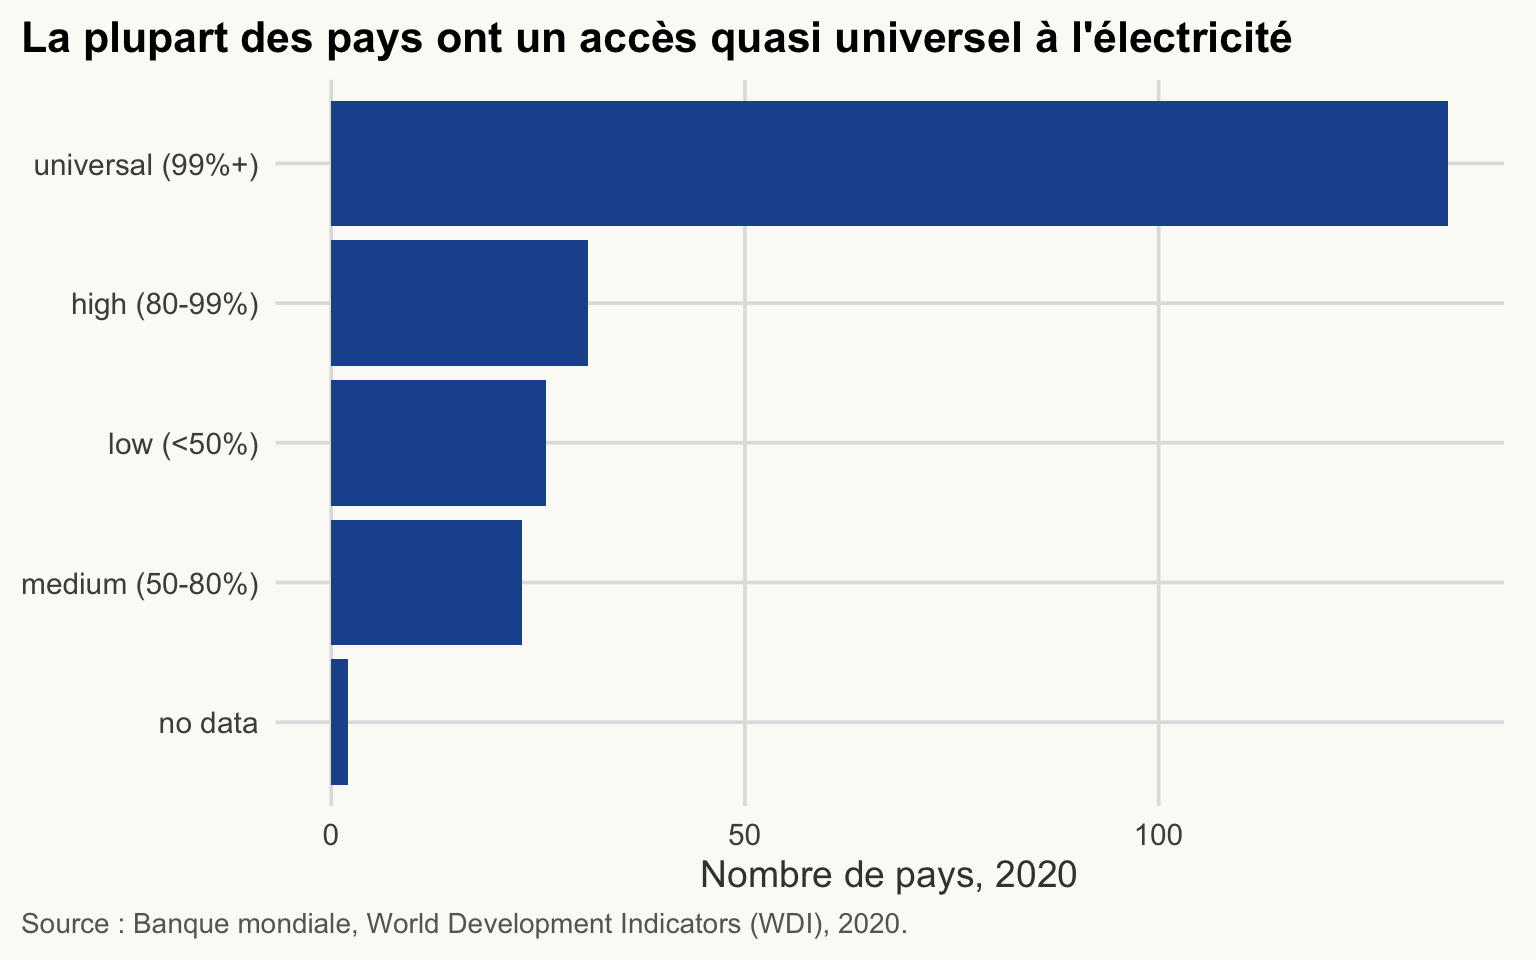
NoteEn clair
case_when() est une machine à trier : chaque pays passe par les questions de haut en bas et s’arrête au premier « oui ». C’est pourquoi l’ordre des conditions compte.
count() est un raccourci pour « regrouper et compter les lignes ». Nous y revenons plus bas.
Déboguer une chaîne, une étape à la fois
≈ 15 min Après cette section, vous saurez trouver l’étape défaillante d’une chaîne en l’exécutant morceau par morceau, et lire ce que dit un message d’erreur.
Une chaîne échoue en bloc, mais elle casse à une étape précise. Celle-ci devrait lister les pays d’Afrique subsaharienne en 2020 avec leur espérance de vie et leur PIB par habitant. Elle contient trois erreurs :
wdi |>
  filter(year = 2020, region == "Sub-Saharan africa") |>
  select(country, life_exp, gdp_pc) |>
  arrange(desc(life_exp))
Error in `filter()`:
! We detected a named input.
ℹ This usually means that you've used `=` instead of `==`.
ℹ Did you mean `year == 2020`?Lire le message d’erreur
Lisez le message depuis le haut. La première ligne nomme le verbe qui a échoué (filter()). La ligne qui commence par ! dit ce qui ne va pas. Les lignes qui commencent par ℹ suggèrent souvent la correction : ici, R devine même que nous voulions écrire year == 2020.
R s’arrête à la première erreur. Corrigez-la et relancez :
wdi |>
  filter(year == 2020, region == "Sub-Saharan africa") |>
  select(country, life_exp, gdp_pc) |>
  arrange(desc(life_exp))
Error in `select()`:
! Can't select columns that don't exist.
✖ Column `gdp_pc` doesn't exist.C’est maintenant select() qui échoue : la colonne gdp_pc n’existe pas (« Column gdp_pc doesn’t exist »). names(wdi) donne les noms exacts ; la colonne s’appelle gdp_pc_ppp.
wdi |>
  filter(year == 2020, region == "Sub-Saharan africa") |>
  select(country, life_exp, gdp_pc_ppp) |>
  arrange(desc(life_exp))
# A tibble: 0 × 3
# ℹ 3 variables: country <chr>, life_exp <dbl>, gdp_pc_ppp <dbl>Plus d’erreur cette fois, et pourtant la table a 0 ligne. C’est le type de bogue le plus dangereux, car R ne se plaint pas.
Exécuter la chaîne une étape à la fois
Pour trouver un bogue silencieux, exécutez la chaîne jusqu’à un |> à la fois et regardez ce qui en sort. Dans RStudio, sélectionnez les lignes jusqu’à un |> (sans l’inclure) et appuyez sur Ctrl + Enter (Cmd + Enter sur Mac). Terminer un morceau par nrow() ou glimpse() montre combien de lignes survivent :
wdi |> nrow() # départ : tous les pays-années[1] 5208wdi |> filter(year == 2020) |> nrow() # une année : une ligne par pays[1] 217wdi |> filter(year == 2020, region == "Sub-Saharan africa") |> nrow() # 0 : le problème est ici[1] 0Le compte tombe à zéro à la condition sur la région. Regardez les valeurs qui existent vraiment :
wdi |> distinct(region)# A tibble: 7 × 1
region
<chr>
1 Middle East, North Africa, Afghanistan & Pakistan
2 Europe & Central Asia
3 East Asia & Pacific
4 Sub-Saharan Africa
5 Latin America & Caribbean
6 South Asia
7 North America Les données écrivent "Sub-Saharan Africa", avec un A majuscule, et == compare le texte exactement. La chaîne réparée, vérifiée avec glimpse() :
wdi |>
  filter(year == 2020, region == "Sub-Saharan Africa") |>
  select(country, life_exp, gdp_pc_ppp) |>
  arrange(desc(life_exp)) |>
  glimpse()
Rows: 48
Columns: 3
$ country <chr> "Seychelles", "Mauritius", "Cabo Verde", "Sao Tome and Prin…
$ life_exp <dbl> 77.23659, 74.17707, 73.81800, 67.97900, 67.64300, 67.49600,…
$ gdp_pc_ppp <dbl> 30056.199, 22272.540, 7207.869, 5742.947, 16289.391, 4018.0…48 pays, comme attendu.
ImportantIdée clé
Une erreur est une amie : elle indique quelle étape a échoué, et souvent comment la corriger. Un résultat vide ou trop petit est silencieux. Après chaque filter() ou jointure, vérifiez nrow(), et copiez les libellés des catégories depuis distinct() au lieu de les taper de mémoire.
AstuceExercice 3.1 : réparer une chaîne
Cette chaîne devrait lister les pays à revenu faible en 2019, avec leur PIB par habitant (PPA) en milliers de dollars et leur espérance de vie, du plus riche au plus pauvre. Elle contient deux bogues. Exécutez-la, trouvez-les étape par étape, corrigez-les, et dites combien de pays contient la table.
wdi |>
  filter(year == 2019, income == "Low Income") |>
  mutate(gdp_pc_k = gdp_pc_ppp / 1000) |>
  select(country, gdp_pc_k, life_expectancy) |>
  arrange(desc(gdp_pc_k))
NoteAfficher la solution
# Bogue 1 (erreur dans select) : la colonne s'appelle life_exp, pas life_expectancy
names(wdi)
[1] "country" "iso3c" "year" "region" "income"
[6] "gdp" "gdp_pc_ppp" "population" "life_exp" "gini"
[11] "elec_access"# Bogue 2 (silencieux) : aucune ligne ne survit au filtre
wdi |> filter(year == 2019, income == "Low Income") |> nrow()[1] 0wdi |> distinct(income) # le libellé est "Low income", avec un i minuscule# A tibble: 4 × 1
income
<chr>
1 Low income
2 Upper middle income
3 High income
4 Lower middle incomelow_2019 <- wdi |>
filter(year == 2019, income == "Low income") |>
mutate(gdp_pc_k = gdp_pc_ppp / 1000) |>
select(country, gdp_pc_k, life_exp) |>
arrange(desc(gdp_pc_k))
nrow(low_2019) # N[1] 25low_2019# A tibble: 25 × 3
country gdp_pc_k life_exp
<chr> <dbl> <dbl>
1 Syrian Arab Republic 4.93 71.0
2 Sudan 3.63 65.8
3 Afghanistan 2.93 62.9
4 Mali 2.92 59.2
5 Sierra Leone 2.85 59.6
6 Rwanda 2.75 66.7
7 Gambia, The 2.75 64.4
8 Uganda 2.69 66.4
9 Chad 2.60 53.0
10 Guinea-Bissau 2.44 62.2
# ℹ 15 more rowsLa table contient 25 pays à revenu faible. Si vous corrigez seulement le nom de colonne, la chaîne tourne sans aucune erreur et renvoie une table vide : le second bogue ne se trouve qu’en vérifiant nrow() étape par étape.
Résumer par groupe, et valeurs manquantes
≈ 30 min Après cette section, vous saurez calculer une statistique par groupe, et dire sur combien d’observations elle repose.
group_by() + summarise()
summarise() condense plusieurs lignes en une seule. Combiné à group_by(), il donne une ligne par groupe. n() compte les lignes de chaque groupe.
flowchart LR
  A["wdi, 2020 (une ligne par pays)"] --> B["group_by(region)"]
  B --> C["summarise(mean_life = mean(life_exp))"]
  C --> D["une ligne par région"]
wdi |>
  filter(year == 2020) |>
  group_by(region) |>
  summarise(
    n_countries = n(),
    median_life = median(life_exp, na.rm = TRUE),
    median_gdp_pc = median(gdp_pc_ppp)
  )
# A tibble: 7 × 4
region n_countries median_life median_gdp_pc
<chr> <int> <dbl> <dbl>
1 East Asia & Pacific 37 72.4 NA
2 Europe & Central Asia 58 78.4 NA
3 Latin America & Caribbean 42 73.4 NA
4 Middle East, North Africa, Afghanistan … 23 75.0 NA
5 North America 3 81.5 67407.
6 South Asia 6 71.8 10083.
7 Sub-Saharan Africa 48 62.7 NA Voici la même logique avec la moyenne, enregistrée pour pouvoir la représenter :
life_by_region <- wdi |>
  filter(year == 2020) |>
  group_by(region) |>
  summarise(mean_life = mean(life_exp, na.rm = TRUE), n_countries = sum(!is.na(life_exp)))

life_by_region
# A tibble: 7 × 3
region mean_life n_countries
<chr> <dbl> <int>
1 East Asia & Pacific 73.4 37
2 Europe & Central Asia 77.8 58
3 Latin America & Caribbean 73.8 42
4 Middle East, North Africa, Afghanistan & Pakistan 74.1 23
5 North America 80.0 3
6 South Asia 73.1 6
7 Sub-Saharan Africa 63.2 47Afficher le code du graphique (vu en séance 5)
life_by_region |>
  ggplot(aes(x = mean_life, y = fct_reorder(region, mean_life))) +
  geom_col(fill = pal_cours[["principal"]]) +
  geom_text(aes(label = paste0("n = ", n_countries)), hjust = 1.1, colour = "white") +
  labs(title = str_wrap("L'Afrique subsaharienne accuse 17 ans de retard sur l'Amérique du Nord", 60),
       x = "Espérance de vie moyenne, 2020 (ans)", y = NULL,
       caption = str_wrap("Source : Banque mondiale, World Development Indicators (WDI), 2020. Moyenne non pondérée entre pays.", 95))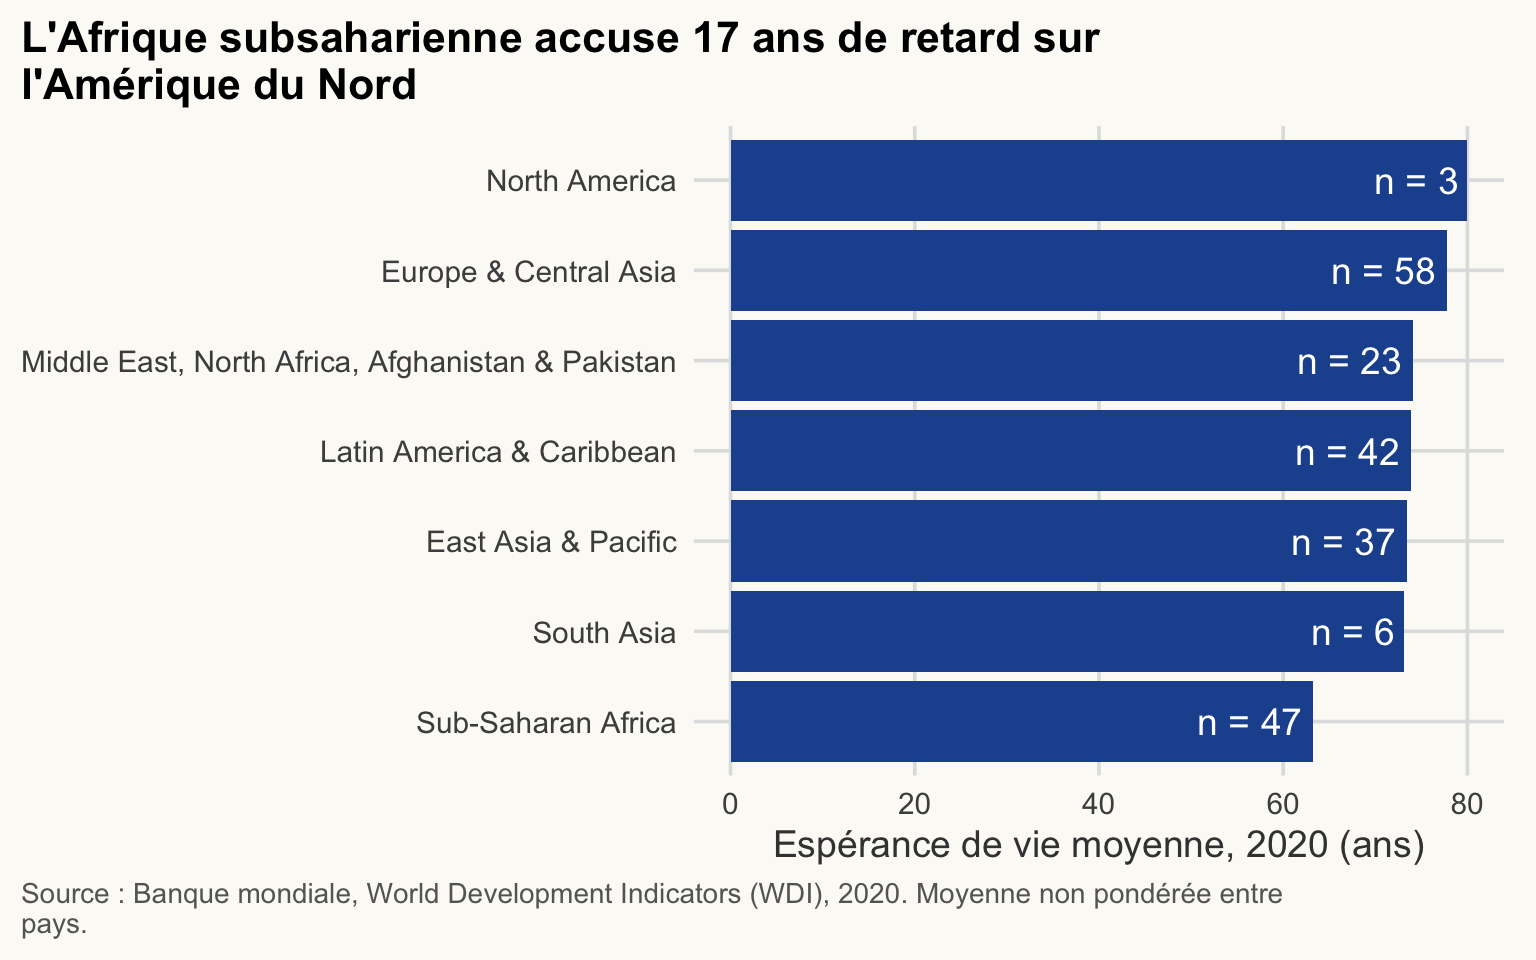
Regardez maintenant median_gdp_pc dans la table précédente : NA pour cinq des sept régions. Une seule valeur manquante suffit pour que median() renvoie NA. Il faut parler des valeurs manquantes.
Valeurs manquantes
NA signifie « valeur inconnue ». Elle est contagieuse : tout calcul impliquant un NA renvoie NA.
mean(c(70, 75, NA))[1] NAmean(c(70, 75, NA), na.rm = TRUE) # ignorer les NA[1] 72.5Combien de NA par colonne dans notre panel ?
wdi |> summarise(across(everything(), \(x) sum(is.na(x))))# A tibble: 1 × 11
country iso3c year region income gdp gdp_pc_ppp population life_exp gini
<int> <int> <int> <int> <int> <int> <int> <int> <int> <int>
1 0 0 0 0 0 166 487 0 24 3372
# ℹ 1 more variable: elec_access <int>gini est manquant pour 65 % des pays-années : les inégalités sont mesurées par des enquêtes auprès des ménages, qui n’ont pas lieu chaque année. Trois outils :
-
is.na(x)renvoieTRUElà oùxest manquante. Utilisez-le dansfilter(). -
drop_na(var)supprime les lignes oùvarest manquante (sans argument : n’importe quelle variable). -
na.rm = TRUEdansmean(),median(),sum()… ignore lesNAdans le calcul.
AvertissementSupprimer les NA change votre N, et peut-être votre conclusion
Supprimer les valeurs manquantes n’est pas neutre : les pays sans Gini ne forment pas un échantillon aléatoire (ils sont souvent plus pauvres ou moins bien couverts par les statistiques). Indiquez toujours sur combien d’observations repose chaque chiffre.
wdi |>
  filter(year == 2020) |>
  summarise(
    n_countries   = n(),
    n_with_gdp_pc = sum(!is.na(gdp_pc_ppp)),
    n_with_gini   = sum(!is.na(gini)),
    median_gdp_pc = median(gdp_pc_ppp, na.rm = TRUE),
    median_gini   = median(gini, na.rm = TRUE)
  )
# A tibble: 1 × 5
n_countries n_with_gdp_pc n_with_gini median_gdp_pc median_gini
<int> <int> <int> <dbl> <dbl>
1 217 199 70 15631. 34.4Le Gini médian est calculé sur les seuls n_with_gini pays, pas sur tous. Reprenons maintenant la table par groupe, cette fois avec N :
gdp_n_region <- wdi |>
  filter(year == 2020) |>
  group_by(region) |>
  summarise(
    n_countries   = n(),
    n_gdp_pc      = sum(!is.na(gdp_pc_ppp)),
    median_gdp_pc = median(gdp_pc_ppp, na.rm = TRUE),
    .groups = "drop"
  ) |>
  arrange(desc(median_gdp_pc))

gdp_n_region
# A tibble: 7 × 4
region n_countries n_gdp_pc median_gdp_pc
<chr> <int> <int> <dbl>
1 North America 3 3 67407.
2 Europe & Central Asia 58 53 36852.
3 Latin America & Caribbean 42 38 19163.
4 Middle East, North Africa, Afghanistan & P… 23 22 13511.
5 East Asia & Pacific 37 31 11306.
6 South Asia 6 6 10083.
7 Sub-Saharan Africa 48 46 3424.Supprimer les NA n’est pas gratuit. Le graphique montre combien de pays chaque région perd :
Afficher le code du graphique (vu en séance 5)
gdp_n_region |>
  mutate(lost = n_countries - n_gdp_pc) |>
  select(region, `Kept` = n_gdp_pc, `Lost (NA)` = lost) |>
  pivot_longer(-region, names_to = "status", values_to = "countries") |>
  mutate(status = factor(status, levels = c("Lost (NA)", "Kept"))) |>
  ggplot(aes(x = countries, y = fct_reorder(region, countries, sum), fill = status)) +
  geom_col() +
  scale_fill_manual(values = c(Kept = pal_cours[["principal"]], `Lost (NA)` = pal_cours[["accent"]]),
                    labels = c(Kept = "Conservés", `Lost (NA)` = "Perdus (NA)")) +
  labs(title = "Supprimer les NA retire des pays de façon inégale selon les régions",
       x = "Nombre de pays, 2020", y = NULL, fill = NULL,
       caption = "Source : Banque mondiale, World Development Indicators (WDI), 2020. PIB par habitant (PPA).") +
  theme(legend.position = "top")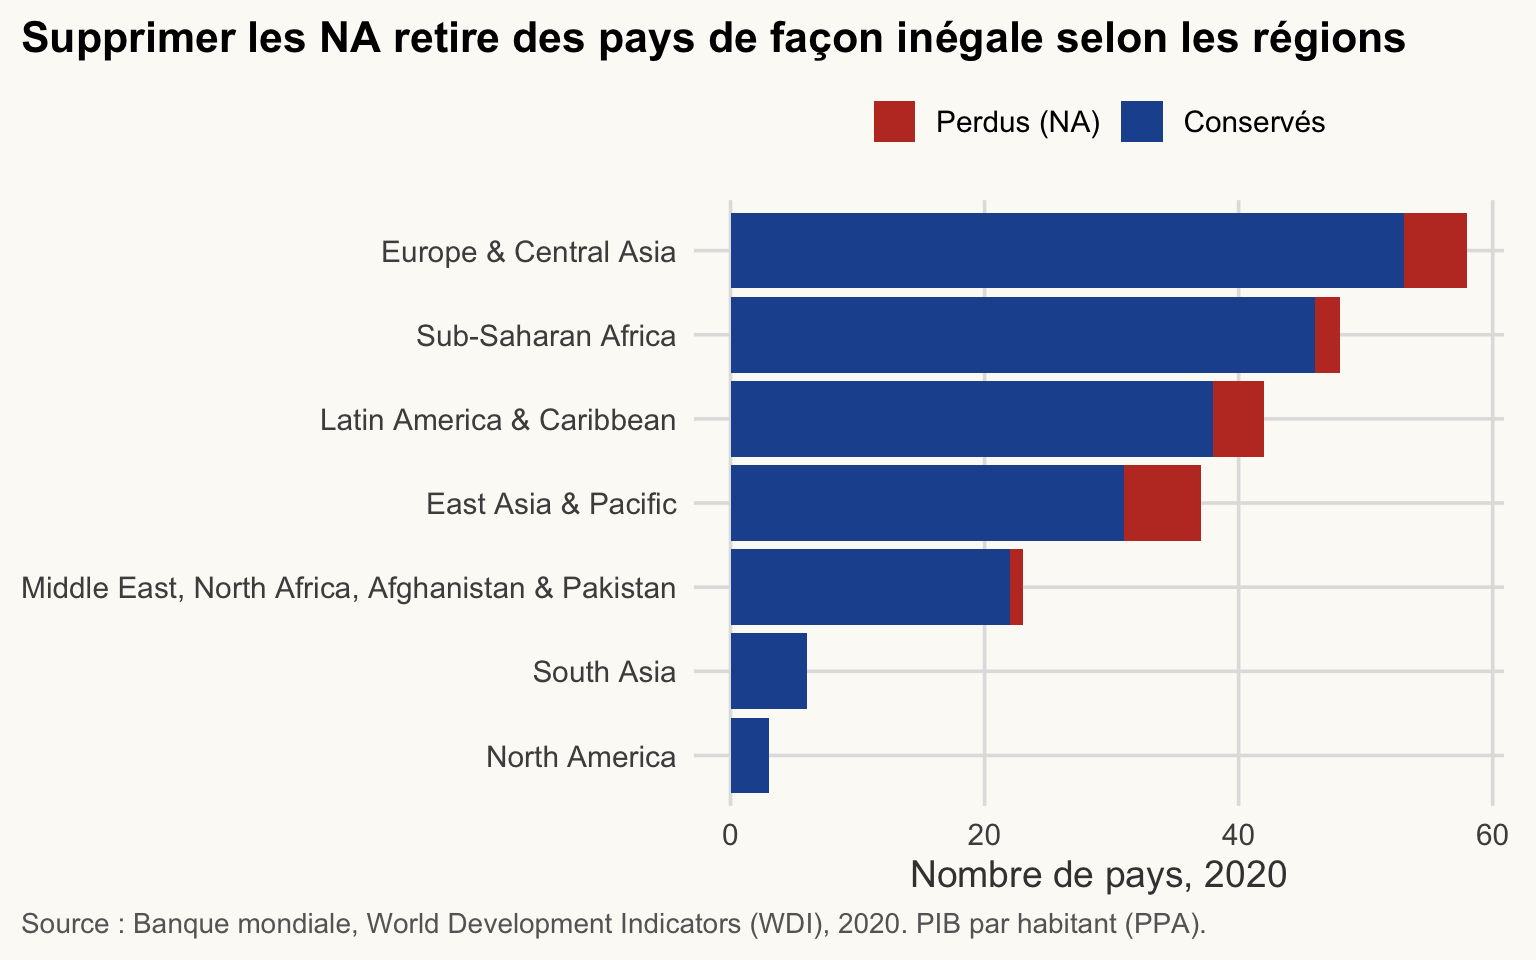
ImportantIdée clé
na.rm = TRUE permet au calcul de s’exécuter, mais la statistique décrit désormais un groupe de pays plus petit, et peut-être différent. Affichez N à côté de chaque chiffre.
Deux détails. .groups = "drop" retire le regroupement du résultat (sinon il reste groupé, ce qui peut vous surprendre plus tard). Et depuis dplyr 1.1, .by est une alternative plus courte à group_by(), sans regroupement résiduel :
wdi |>
  filter(year == 2020) |>
  summarise(mean_life = mean(life_exp, na.rm = TRUE), n = n(), .by = income)
# A tibble: 4 × 3
income mean_life n
<chr> <dbl> <int>
1 Low income 62.9 25
2 Upper middle income 72.3 59
3 High income 78.9 86
4 Lower middle income 66.5 47count() est le moyen le plus rapide de tabuler une variable catégorielle (sort = TRUE place le plus grand effectif en premier) :
wdi |> filter(year == 2020) |> count(income, sort = TRUE)# A tibble: 4 × 2
income n
<chr> <int>
1 High income 86
2 Upper middle income 59
3 Lower middle income 47
4 Low income 25Facteurs : donner un ordre aux catégories
≈ 10 min Après cette section, vous saurez contrôler l’ordre dans lequel les catégories apparaissent dans les tables et les graphiques.
R trie le texte par ordre alphabétique, ce qui est rarement ce que nous voulons. Les groupes de revenu ont un ordre naturel. Notez que income est la classification actuelle de la Banque mondiale, appliquée à toutes les années : un pays qui a changé de groupe depuis 2000 apparaît dans son groupe d’aujourd’hui, même en 2000.
Facteur : une variable dotée d’une liste fixe et ordonnée de catégories autorisées (ses levels). L’ordre des niveaux est celui utilisé dans les tables et les graphiques.
unique(wdi$income) # vérifier les libellés exacts avant de les utiliser[1] "Low income" "Upper middle income" "High income"
[4] "Lower middle income"income_levels <- c("Low income", "Lower middle income",
"Upper middle income", "High income")
wdi <- wdi |>
mutate(income = factor(income, levels = income_levels))
wdi |> filter(year == 2020) |> count(income)# A tibble: 4 × 2
income n
<fct> <int>
1 Low income 25
2 Lower middle income 47
3 Upper middle income 59
4 High income 86Désormais, la table suit l’ordre économique et non l’alphabet. Autres outils de forcats (chargé avec tidyverse) :
-
fct_relevel(x, "High income")place un niveau en tête sans avoir à retaper tous les autres. -
fct_reorder(x, y)ordonne les niveaux dexselon les valeurs dey. C’est ce qui rend les diagrammes en barres lisibles (séance 5).
Aperçu : ggplot est enseigné en séance 5. Pour l’instant, recopiez simplement le modèle.
wdi |>
  filter(year == 2020) |>
  summarise(median_life = median(life_exp, na.rm = TRUE), .by = region) |>
  ggplot(aes(x = median_life, y = fct_reorder(region, median_life))) +
  geom_col(fill = pal_cours[["principal"]]) +
  labs(title = str_wrap("L'espérance de vie est la plus faible en Afrique subsaharienne", 60),
       x = "Espérance de vie médiane, 2020 (ans)",
       y = NULL,
       caption = str_wrap("Source : Banque mondiale, WDI. Médiane entre les pays de chaque région.", 95))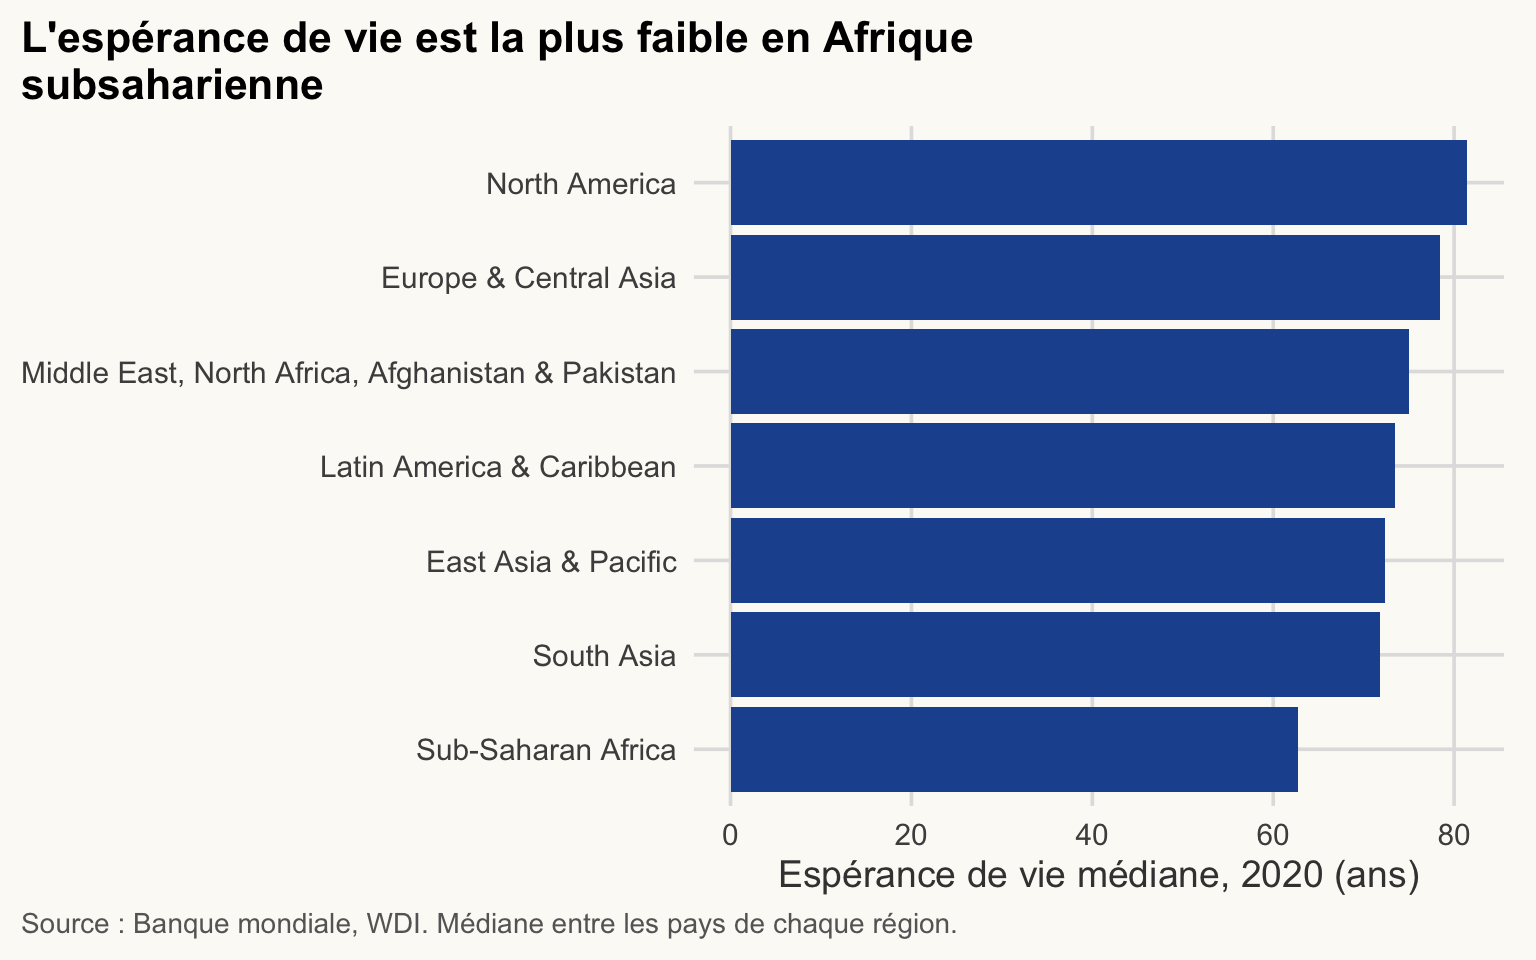
Sans fct_reorder(), les barres seraient en ordre alphabétique et le message serait plus difficile à lire.
AvertissementErreur fréquente
Saisir un niveau avec une orthographe légèrement différente ("Low Income" au lieu de "Low income") : R le transforme silencieusement en NA. C’est pourquoi nous avons d’abord exécuté unique(wdi$income). Après factor(), vérifiez avec count() qu’aucun NA n’est apparu.
Remodeler avec tidyr : format large et format long
≈ 25 min Après cette section, vous saurez passer une table du format large au format long (et inversement) avec pivot_wider() et pivot_longer().
Les données tidy en trois règles
Données tidy (rangées) : une table est tidy quand (1) chaque variable est une colonne, (2) chaque observation est une ligne, (3) chaque valeur est une cellule.
Notre panel est tidy : une ligne par pays-année, une colonne par variable (year est une colonne, pas 24 colonnes). ggplot2 et dplyr attendent ce format long.
Mais les données téléchargées depuis le site de la Banque mondiale ou une feuille Excel arrivent généralement en format large : une colonne par année (2000, 2001, …). C’est pratique à lire, mais une année est une valeur, pas une variable. Avant d’analyser de telles données, il faut les remodeler.
flowchart LR
  L["Long : une ligne par pays-année"] -- "pivot_wider()" --> W["Large : une colonne par année"]
  W -- "pivot_longer()" --> L
Long (3 colonnes)
| country | year | value |
|---|---|---|
| A | 2000 | 70 |
| A | 2010 | 73 |
| B | 2000 | 55 |
| B | 2010 | 60 |
Large (une colonne par année)
| country | y2000 | y2010 |
|---|---|---|
| A | 70 | 73 |
| B | 55 | 60 |
ImportantIdée clé
Demandez-vous : « ce nom de colonne est-il en réalité une valeur ? » Les noms de colonnes 2000, 2010, … sont des valeurs de la variable year : faites-les pivoter en lignes avec pivot_longer().
pivot_wider() : du long au large
L’espérance de vie de cinq pays, une colonne par année :
life_long <- wdi |>
  filter(country %in% c("Algeria", "Brazil", "Ghana", "India", "Norway"),
         year %in% c(2000, 2010, 2020)) |>
  select(country, year, life_exp)

life_long
# A tibble: 15 × 3
country year life_exp
<chr> <dbl> <dbl>
1 Algeria 2000 70.6
2 Algeria 2010 74.1
3 Algeria 2020 73.3
4 Brazil 2000 69.6
5 Brazil 2010 73.8
6 Brazil 2020 74.5
7 Ghana 2000 58.1
8 Ghana 2010 61.3
9 Ghana 2020 64.3
10 India 2000 62.7
11 India 2010 67.2
12 India 2020 70.2
13 Norway 2000 78.6
14 Norway 2010 81.0
15 Norway 2020 83.2life_wide <- life_long |>
pivot_wider(names_from = year, values_from = life_exp, names_prefix = "y")
life_wide# A tibble: 5 × 4
country y2000 y2010 y2020
<chr> <dbl> <dbl> <dbl>
1 Algeria 70.6 74.1 73.3
2 Brazil 69.6 73.8 74.5
3 Ghana 58.1 61.3 64.3
4 India 62.7 67.2 70.2
5 Norway 78.6 81.0 83.2names_from indique la colonne qui devient les nouveaux noms de colonnes, values_from celle qui remplit les cellules.
pivot_longer() : du large au long
Le chemin inverse, celui que vous utiliserez le plus avec les téléchargements de type Excel :
life_back <- life_wide |>
  pivot_longer(cols = starts_with("y"),
               names_to = "year", names_prefix = "y",
               values_to = "life_exp") |>
  mutate(year = as.integer(year))   # year est revenue sous forme de texte

life_back
# A tibble: 15 × 3
country year life_exp
<chr> <int> <dbl>
1 Algeria 2000 70.6
2 Algeria 2010 74.1
3 Algeria 2020 73.3
4 Brazil 2000 69.6
5 Brazil 2010 73.8
6 Brazil 2020 74.5
7 Ghana 2000 58.1
8 Ghana 2010 61.3
9 Ghana 2020 64.3
10 India 2000 62.7
11 India 2010 67.2
12 India 2020 70.2
13 Norway 2000 78.6
14 Norway 2010 81.0
15 Norway 2020 83.2# Vérification : on retrouve exactement la table de départ
all.equal(as.data.frame(life_back), as.data.frame(life_long))[1] TRUE
AvertissementErreur fréquente
Après pivot_longer() avec names_prefix, la nouvelle colonne year est du texte, pas un nombre. Les graphiques et les filtres qui s’appuient dessus se comportent alors mal. Convertissez-la avec as.integer(), comme ci-dessus.
Jointures : combiner deux tables
≈ 35 min Après cette section, vous saurez combiner deux tables en toute sécurité et repérer les lignes qui n’ont pas trouvé de correspondance.
Les projets réels mobilisent plusieurs sources : le PIB de la Banque mondiale, les inégalités de la WID, le commerce de l’OCDE.
Jointure : ajoute à la table x les colonnes de la table y, en appariant les lignes sur une clé. Clé : la ou les colonnes qui identifient la même unité dans les deux tables, ici le code pays et l’année.
Un tout petit exemple
data1 <- tibble(country = c("US", "CN", "IN"), value1 = 1:3)
data2 <- tibble(country = c("US", "CN", "BR"), value2 = 4:6)

data1
# A tibble: 3 × 2
country value1
<chr> <int>
1 US 1
2 CN 2
3 IN 3data2# A tibble: 3 × 2
country value2
<chr> <int>
1 US 4
2 CN 5
3 BR 6« US » et « CN » figurent dans les deux tables, « IN » seulement à gauche, « BR » seulement à droite. Les quatre principales jointures diffèrent par les lignes qu’elles conservent :
left_join(data1, data2, by = "country") # toutes les lignes de data1# A tibble: 3 × 3
country value1 value2
<chr> <int> <int>
1 US 1 4
2 CN 2 5
3 IN 3 NAinner_join(data1, data2, by = "country") # seulement les lignes présentes dans les deux# A tibble: 2 × 3
country value1 value2
<chr> <int> <int>
1 US 1 4
2 CN 2 5full_join(data1, data2, by = "country") # toutes les lignes des deux# A tibble: 4 × 3
country value1 value2
<chr> <int> <int>
1 US 1 4
2 CN 2 5
3 IN 3 NA
4 BR NA 6anti_join(data1, data2, by = "country") # lignes de data1 SANS correspondance dans data2# A tibble: 1 × 2
country value1
<chr> <int>
1 IN 3flowchart LR
subgraph X["x: US, CN, IN"]
x1[US]
x2[CN]
x3[IN]
end
subgraph Y["y: US, CN, BR"]
y1[US]
y2[CN]
y3[BR]
end
X --> L["left_join conserve US, CN, IN"]
X --> I["inner_join conserve US, CN"]
X --> A["anti_join conserve IN"]
Y --> I
| Jointure | Conserve | Lignes ici | Valeurs sans correspondance |
|---|---|---|---|
left_join(x, y) |
toutes les lignes de x
|
3 (US, CN, IN) |
NA pour les colonnes de y
|
inner_join(x, y) |
les lignes présentes dans les deux | 2 (US, CN) | aucune |
full_join(x, y) |
toutes les lignes des deux | 4 (US, CN, IN, BR) |
NA d’un côté ou de l’autre |
anti_join(x, y) |
les lignes de x absentes de y
|
1 (IN) | aucune colonne de y
|
(right_join(x, y) équivaut à left_join(y, x) avec les colonnes dans un autre ordre ; vous pouvez l’ignorer.)
left_join() est le choix par défaut : vous partez de votre table principale et vous y ajoutez de l’information, sans jamais perdre une ligne de la table principale. anti_join() n’est pas une façon de fusionner mais un diagnostic : il liste les clés qui n’ont pas trouvé de correspondance.
Le piège du monde réel : joindre sur les noms de pays
Nous voulons ajouter les données d’inégalités de la World Inequality Database (WID) au PIB de la Banque mondiale, pour trois pays.
gdp3 <- read_csv(here("data", "wdi_3countries.csv"), show_col_types = FALSE)
wid  <- read_csv(here("data", "wid_gini.csv"), show_col_types = FALSE)

# première ligne de chaque pays
gdp3 |> arrange(country, year) |> distinct(country, .keep_all = TRUE)
# A tibble: 3 × 4
country iso3c year gdp
<chr> <chr> <dbl> <dbl>
1 China CHN 2000 1.22e12
2 India IND 2000 4.68e11
3 United States USA 2000 1.03e13wid |> arrange(country_wid, year) |> distinct(country_wid, .keep_all = TRUE)# A tibble: 3 × 4
iso3c country_wid year gini
<chr> <chr> <dbl> <dbl>
1 CHN China 2000 0.498
2 IND India 2000 0.509
3 USA USA 2000 0.550L’idée naturelle : les deux tables ont une colonne pays, donc on joint dessus. (La WID l’appelle country_wid, donc on indique à by que les deux noms sont équivalents.)
naive <- gdp3 |>
  left_join(wid, by = c("country" = "country_wid", "year"))

nrow(gdp3)
[1] 63nrow(naive)[1] 63naive |>
summarise(n_rows = n(), n_gini = sum(!is.na(gini)), .by = country)# A tibble: 3 × 3
country n_rows n_gini
<chr> <int> <int>
1 China 21 21
2 India 21 21
3 United States 21 0Aucune erreur, aucun avertissement, le bon nombre de lignes. Et pourtant les États-Unis n’ont aucun Gini :
Afficher le code du graphique (vu en séance 5)
naive |>
  summarise(n_gini = sum(!is.na(gini)), n_missing = sum(is.na(gini)), .by = country) |>
  pivot_longer(c(n_gini, n_missing), names_to = "status", values_to = "years") |>
  mutate(status = recode(status, n_gini = "Gini found", n_missing = "Gini missing (NA)")) |>
  ggplot(aes(x = years, y = country, fill = status)) +
  geom_col() +
  scale_fill_manual(values = c(`Gini found` = pal_cours[["principal"]],
                               `Gini missing (NA)` = pal_cours[["accent"]]),
                    labels = c(`Gini found` = "Gini disponible", `Gini missing (NA)` = "Gini manquant (NA)")) +
  labs(title = "La jointure sur les noms a perdu les États-Unis en silence",
       x = "Nombre d'années (2000-2020)", y = NULL, fill = NULL,
       caption = "Source : Banque mondiale (WDI) et World Inequality Database (WID).") +
  theme(legend.position = "top")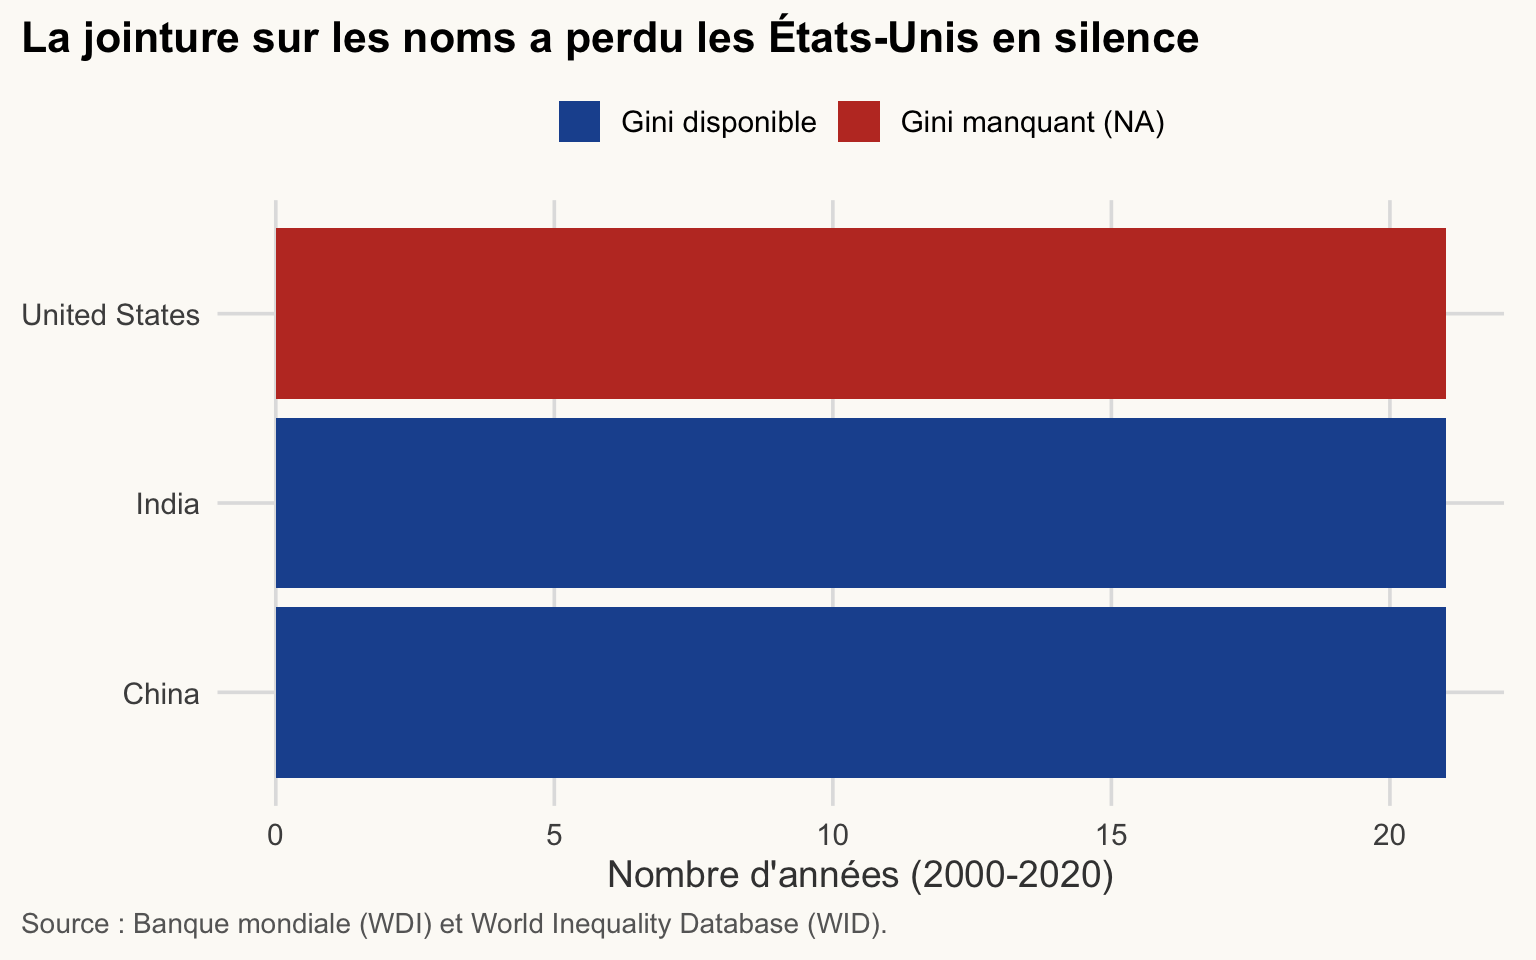
Pourquoi ? La WDI écrit « United States », la WID écrit « USA » : les deux chaînes diffèrent, donc aucune ligne ne correspond, et left_join() remplit avec des NA.
AvertissementErreur fréquente
Joindre deux sources par nom de pays : les États-Unis perdent silencieusement leur Gini et personne ne le remarque, car R ne signale rien. Une jointure ne se plaint jamais des clés sans correspondance. C’est à vous de vérifier.
Deux vérifications qui l’auraient détecté :
# 1. anti_join : quelles clés de la table de gauche n'ont pas de correspondance à droite ?
gdp3 |>
  anti_join(wid, by = c("country" = "country_wid", "year")) |>
  distinct(country)
# A tibble: 1 × 1
country
<chr>
1 United States# 2. compter les NA créés par la jointure
sum(is.na(naive$gini))[1] 21La solution : joindre sur un code standardisé, pas sur un nom. Le code ISO à 3 lettres (iso3c) est le même dans les deux sources. Les noms changent (« Turkey » / « Turkiye », « Korea, Rep. » / « South Korea ») ; les codes sont bien plus stables. Ils changent pourtant de temps en temps (la Roumanie est passée de ROM à ROU, la RD Congo de ZAR à COD) : lancez donc anti_join() quand même.
gdp_gini <- gdp3 |>
  left_join(select(wid, iso3c, year, gini), by = c("iso3c", "year"))

nrow(gdp3)
[1] 63nrow(gdp_gini)[1] 63sum(is.na(gdp_gini$gini))[1] 0gdp_gini |>
summarise(n_rows = n(), n_gini = sum(!is.na(gini)), .by = country)# A tibble: 3 × 3
country n_rows n_gini
<chr> <int> <int>
1 China 21 21
2 India 21 21
3 United States 21 21# Et la vérification par anti_join est maintenant vide
gdp3 |> anti_join(wid, by = c("iso3c", "year")) |> nrow()[1] 0Nous n’avons sélectionné que iso3c, year et gini dans wid : sinon country et country_wid seraient tous deux repris, ce qui prête à confusion.
Maintenant, les trois pays ont un Gini, et nous pouvons enfin comparer les inégalités avec le revenu :
Afficher le code du graphique (vu en séance 5)
gdp_gini |>
  ggplot(aes(x = year, y = gini, colour = country)) +
  geom_line(linewidth = 1) +
  scale_colour_manual(values = c(China = pal_cours[["accent"]],
                                 India = "#E69F00",
                                 `United States` = pal_cours[["principal"]])) +
  labs(title = str_wrap("Les inégalités ont augmenté dans les trois pays ; en Chine, surtout avant 2010", 60),
       x = "Année", y = "Coefficient de Gini (WID, 0-1)",
       colour = NULL,
       caption = str_wrap("Source : Banque mondiale (WDI, PIB) jointe à la World Inequality Database (WID, Gini) par iso3c et année.", 95))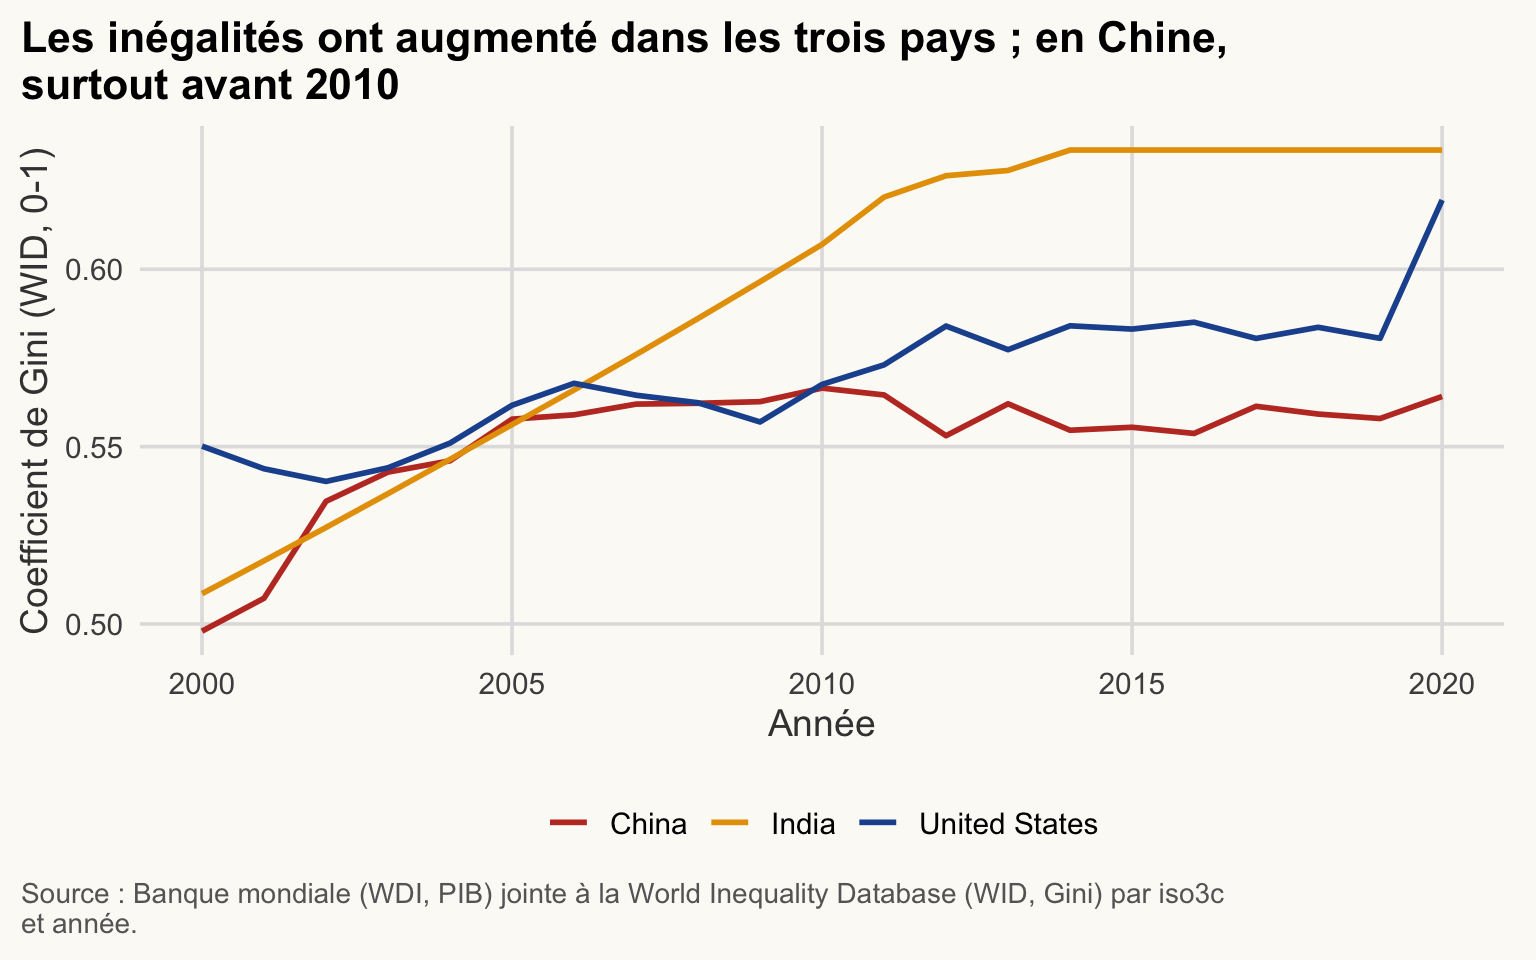
NoteDeux Gini qui ne sont pas comparables
La colonne gini de wdi et le Gini de wid ne mesurent pas la même chose :
- WDI (0-100) : enquêtes auprès des ménages, souvent sur la consommation plutôt que sur le revenu dans les pays à revenu faible et intermédiaire, dont l’Inde.
- WID (0-1) : revenu national avant impôt des adultes, qui combine enquêtes, données fiscales et comptabilité nationale.
Ils classent même l’Inde différemment. Dans la WID, l’Inde est le plus inégalitaire des trois pays en 2020 (0,63, contre 0,62 pour les États-Unis et 0,56 pour la Chine). Dans les WDI, le dernier Gini de l’Inde (23,0 en 2023) est très inférieur à celui des États-Unis (41,8 en 2023). Ne mettez jamais les deux dans la même colonne et ne comparez pas l’un à l’autre.
NotePourquoi c’est important en économie du développement
Les travaux entre pays combinent toujours des sources (croissance de la Banque mondiale, inégalités de la WID, commerce de l’OCDE). Une perte silencieuse comme celle des États-Unis ici fausse toutes les comparaisons qui suivent, généralement sans aucun symptôme visible.
Les bonnes habitudes pour chaque jointure
ImportantIdée clé
Une jointure ne se plaint jamais des clés sans correspondance. Le filet de sécurité est une routine : joindre sur des codes, compter les lignes, lancer anti_join().
-
Joignez sur des codes (
iso3c, pas sur des noms), et sur toutes les clés qui identifient une ligne : ici le pays et l’année. -
Comptez les lignes avant et après avec
nrow(). Après unleft_join(), le nombre de lignes doit être égal à celui de la table de gauche. -
Lancez
anti_join()dans les deux sens pour voir ce qui n’a pas trouvé de correspondance. -
Comptez les
NAdans les nouvelles colonnes.
Et si la clé n’est pas unique dans la table de droite ? Par exemple, en joignant sur iso3c seul alors que wid compte 21 années par pays : chaque ligne de gdp3 correspond à 21 lignes de wid, et le résultat gonfle jusqu’à compter bien plus de lignes. Depuis dplyr 1.1, *_join() avertit en cas de correspondances plusieurs-à-plusieurs inattendues, et vous pouvez énoncer votre attente avec l’argument relationship :
# Chaque (iso3c, year) doit apparaître au plus une fois dans wid, sinon : erreur
gdp3 |>
  left_join(wid, by = c("iso3c", "year"), relationship = "many-to-one")
Ne négligez pas cet avertissement : il signifie presque toujours que la clé est incomplète (ici, year a été oubliée).
Écrire une fonction simple
≈ 15 min Après cette section, vous saurez écrire une petite fonction et l’utiliser dans mutate().
Vous avez utilisé de nombreuses fonctions écrites par d’autres : mean(), filter(), read_csv(). Quand vous répétez le même calcul, vous pouvez écrire la vôtre. Celle-ci calcule le PIB par habitant :
gdp_per_capita <- function(gdp, population) {
  gdp / population
}
Fonction : une recette qui porte un nom. Ses arguments sont les entrées (ici gdp et population). Le corps, entre { }, est le calcul. La valeur de la dernière ligne est ce que la fonction renvoie.
Exécuter ce bloc crée la fonction (elle apparaît dans le panneau Environment) mais ne calcule encore rien. Appelez-la d’abord sur des nombres dont vous connaissez le résultat :
gdp_per_capita(gdp = 2e12, population = 50e6) # 2 000 milliards / 50 millions = 40 000[1] 40000Testez une nouvelle fonction sur un cas que vous pouvez vérifier à la main avant de lui confier de vraies données.
Les arguments sont locaux : dans la fonction, gdp et population valent ce que vous lui avez transmis, et ils disparaissent quand elle se termine. Seule la valeur renvoyée en sort.
Comme / fonctionne sur des colonnes entières, la fonction marche aussi dans mutate(). La table des trois pays gdp3 (de la section sur les jointures) contient le PIB mais pas la population : nous l’ajoutons depuis wdi, avec les bonnes habitudes de jointure de la section précédente :
gdp_pc_3 <- gdp3 |>
  filter(year == 2020) |>
  left_join(select(wdi, iso3c, year, population), by = c("iso3c", "year")) |>
  mutate(gdp_pc = gdp_per_capita(gdp, population))

nrow(gdp_pc_3)   # 3 lignes, comme dans la table de gauche
[1] 3gdp_pc_3# A tibble: 3 × 6
country iso3c year gdp population gdp_pc
<chr> <chr> <dbl> <dbl> <dbl> <dbl>
1 China CHN 2020 1.50e13 1411100000 10627.
2 India IND 2020 2.67e12 1402617695 1907.
3 United States USA 2020 2.14e13 331578104 64465.En 2020, le PIB par habitant était d’environ 64 465 $ aux États-Unis, 10 627 $ en Chine et 1 907 $ en Inde. Ce sont des dollars courants aux taux de change du marché : ils ne sont pas comparables avec la colonne gdp_pc_ppp de wdi, qui corrige les écarts de niveau des prix (PPA).
AvertissementErreur fréquente
could not find function "gdp_per_capita" (« fonction introuvable ») : le bloc qui définit la fonction n’a pas été exécuté dans cette session R, par exemple après un redémarrage. Exécutez-le d’abord ; dans un script, placez vos fonctions en haut, juste après les library().
Les séances suivantes définissent de petites fonctions utilitaires de la même façon : unmatched() à la séance 5 liste les pays sans correspondance dans la carte du monde, et la séance 6 construit sa propre fonction de thème pour les graphiques.
AstuceExercice 3.2 : une fonction de taux de croissance
Écrivez une fonction growth_pct(before, after) qui renvoie la variation en pourcentage de before à after. Testez-la : growth_pct(100, 110) doit donner 10. Utilisez-la ensuite pour calculer la croissance du PIB par habitant (PPA) entre 2000 et 2020 pour la Chine, l’Inde et les États-Unis. Indice : obtenez une colonne par année avec pivot_wider().
NoteAfficher la solution
growth_pct <- function(before, after) {
  100 * (after - before) / before
}

growth_pct(100, 110)   # vérification à la main : 10
[1] 10growth_3 <- wdi |>
filter(iso3c %in% c("CHN", "IND", "USA"), year %in% c(2000, 2020)) |>
select(country, year, gdp_pc_ppp) |>
pivot_wider(names_from = year, values_from = gdp_pc_ppp, names_prefix = "y") |>
mutate(growth = growth_pct(y2000, y2020))
growth_3# A tibble: 3 × 4
country y2000 y2020 growth
<chr> <dbl> <dbl> <dbl>
1 China 4066. 19215. 373.
2 India 3010. 7187. 139.
3 United States 55046. 67407. 22.5Entre 2000 et 2020, le PIB par habitant (PPA) a augmenté d’environ 373 % en Chine, 139 % en Inde et 22 % aux États-Unis (N = 3 pays).
Exercices (≈ 25 min, plus ≈ 45 min en option)
Les exercices suivants utilisent le panel wdi, sauf le dernier. L’exercice 3.8, l’exercice de synthèse, est le cœur de cette partie. Les exercices 3.3 à 3.7 sont un entraînement supplémentaire, un par thème du jour : faites ceux qui portent sur les thèmes où vous vous sentez le moins sûr, en séance si le temps le permet ou chez vous.
AstuceExercice 3.3 : filter, select, arrange (Facultatif : pour aller plus loin)
Prenez les pays d’Afrique subsaharienne en 2020. Gardez country, income, life_exp et elec_access, et triez-les par espérance de vie, de la plus faible à la plus élevée. Affichez les 10 plus faibles. Combien de pays le groupe compte-t-il ?
NoteAfficher la solution
ssa_2020 <- wdi |>
  filter(region == "Sub-Saharan Africa", year == 2020) |>
  select(country, income, life_exp, elec_access) |>
  arrange(life_exp)

nrow(ssa_2020)   # N
[1] 48head(ssa_2020, 10)# A tibble: 10 × 4
country income life_exp elec_access
<chr> <fct> <dbl> <dbl>
1 Nigeria Lower middle income 53.1 55.4
2 Chad Low income 53.1 10.9
3 Lesotho Lower middle income 55.1 47.5
4 Somalia, Fed. Rep. Low income 57.1 49.9
5 South Sudan Low income 57.6 7.3
6 Mali Low income 58.9 50.6
7 Guinea Lower middle income 59.4 44.7
8 Sierra Leone Low income 59.7 26.3
9 Eswatini Lower middle income 59.9 80
10 Niger Low income 59.9 18.7
AstuceExercice 3.4 : mutate (Facultatif : pour aller plus loin)
Ajoutez la colonne gdp_bn (PIB en milliards de US$) aux données 2020 et listez les 5 pays au PIB le plus élevé, avec leur PIB en milliards. Lesquels ne sont pas à revenu élevé ?
NoteAfficher la solution
wdi |>
  filter(year == 2020) |>
  mutate(gdp_bn = gdp / 1e9) |>
  arrange(desc(gdp_bn)) |>
  select(country, income, gdp_bn) |>
  head(5)
# A tibble: 5 × 3
country income gdp_bn
<chr> <fct> <dbl>
1 United States High income 21375.
2 China Upper middle income 14996.
3 Japan High income 5189.
4 Germany High income 3941.
5 United Kingdom High income 2724.La liste contient la Chine, que la Banque mondiale ne classe pas parmi les pays à revenu élevé.
AstuceExercice 3.5 : group_by et summarise (Facultatif : pour aller plus loin)
Pour chaque région et chacune des années 2000, 2010 et 2020, calculez le PIB par habitant (PPA) médian et le nombre de pays sur lequel il repose (hors valeurs manquantes). Présentez le résultat trié par année, puis par médiane.
NoteAfficher la solution
wdi |>
  filter(year %in% c(2000, 2010, 2020)) |>
  summarise(
    n_countries   = sum(!is.na(gdp_pc_ppp)),
    median_gdp_pc = median(gdp_pc_ppp, na.rm = TRUE),
    .by = c(region, year)
  ) |>
  arrange(year, desc(median_gdp_pc))
# A tibble: 21 × 4
region year n_countries median_gdp_pc
<chr> <dbl> <int> <dbl>
1 North America 2000 3 55046.
2 Europe & Central Asia 2000 51 21302.
3 Latin America & Caribbean 2000 34 14016.
4 Middle East, North Africa, Afghanistan & Pak… 2000 21 11643.
5 East Asia & Pacific 2000 31 5809.
6 South Asia 2000 6 4149.
7 Sub-Saharan Africa 2000 46 2597.
8 North America 2010 3 59797.
9 Europe & Central Asia 2010 53 30068.
10 Latin America & Caribbean 2010 38 18366.
# ℹ 11 more rowsLe N n’est pas constant selon les régions et les années : comparez les médianes en gardant cela à l’esprit.
AstuceExercice 3.6 : pivot (Facultatif : pour aller plus loin)
Construisez une table avec une ligne par région et une colonne par année (2000, 2010, 2020) contenant l’espérance de vie médiane. Puis remettez-la au format long.
NoteAfficher la solution
life_region <- wdi |>
  filter(year %in% c(2000, 2010, 2020)) |>
  summarise(median_life = median(life_exp, na.rm = TRUE), .by = c(region, year)) |>
  pivot_wider(names_from = year, values_from = median_life, names_prefix = "y")

life_region
# A tibble: 7 × 4
region y2000 y2010 y2020
<chr> <dbl> <dbl> <dbl>
1 Middle East, North Africa, Afghanistan & Pakistan 70.9 74.1 75.0
2 Europe & Central Asia 74.9 77.9 78.4
3 East Asia & Pacific 69.6 71.3 72.4
4 Sub-Saharan Africa 52.3 58.3 62.7
5 Latin America & Caribbean 72.2 73.7 73.4
6 South Asia 62.7 68.4 71.8
7 North America 78.3 79.4 81.5life_region |>
pivot_longer(starts_with("y"), names_to = "year", names_prefix = "y",
values_to = "median_life") |>
mutate(year = as.integer(year)) # year revient sous forme de texte# A tibble: 21 × 3
region year median_life
<chr> <int> <dbl>
1 Middle East, North Africa, Afghanistan & Pakistan 2000 70.9
2 Middle East, North Africa, Afghanistan & Pakistan 2010 74.1
3 Middle East, North Africa, Afghanistan & Pakistan 2020 75.0
4 Europe & Central Asia 2000 74.9
5 Europe & Central Asia 2010 77.9
6 Europe & Central Asia 2020 78.4
7 East Asia & Pacific 2000 69.6
8 East Asia & Pacific 2010 71.3
9 East Asia & Pacific 2020 72.4
10 Sub-Saharan Africa 2000 52.3
# ℹ 11 more rows
AstuceExercice 3.7 : jointure et vérification (Facultatif : pour aller plus loin)
À partir de wdi, construisez la table elec avec iso3c, year, elec_access pour 2020. Joignez-la ensuite à une table small qui contient iso3c = c("FRA", "GHA", "XXX") (le dernier code n’existe pas). Utilisez left_join(), vérifiez le nombre de lignes, puis utilisez anti_join() pour trouver le code sans correspondance.
NoteAfficher la solution
elec <- wdi |>
  filter(year == 2020) |>
  select(iso3c, year, elec_access)

small <- tibble(iso3c = c("FRA", "GHA", "XXX"))

joined <- small |> left_join(elec, by = "iso3c")

nrow(small)
[1] 3nrow(joined) # identique : left_join garde toutes les lignes de `small`[1] 3joined # XXX a des NA# A tibble: 3 × 3
iso3c year elec_access
<chr> <dbl> <dbl>
1 FRA 2020 100
2 GHA 2020 85.4
3 XXX NA NA small |> anti_join(elec, by = "iso3c") # le code sans correspondance# A tibble: 1 × 1
iso3c
<chr>
1 XXX
AstuceExercice 3.8 : réparer cette analyse (exercice de synthèse)
Un collègue vous envoie data/raw/repair_me.csv : de vraies valeurs de la Banque mondiale pour six pays (Afghanistan, Angola, Bangladesh, Bénin, Ghana, Kenya) en 2015 et 2019. La séance 2 a ouvert ce fichier et présenté les outils qui convertissent du texte en nombres ; ici, vous terminez le travail.
Consigne : calculez l’espérance de vie moyenne de chaque année sur les six pays, et indiquez le N sur lequel repose chaque moyenne.
Le fichier contient quatre problèmes placés exprès, plus un piège. Travaillez dans un nouveau script (File > New File > R Script), en trois étapes :
-
Inspecter avant de calculer quoi que ce soit :
glimpse(),count(country, year),distinct(country). - Réparer chaque problème par une ligne de code. Ne modifiez jamais le CSV à la main : le fichier brut reste tel qu’il est arrivé, et le script garde la trace de chaque changement.
-
Relancer tout le script dans une session R neuve :
Session > Restart R(Ctrl/Cmd + Shift + F10), puis exécutez le script de haut en bas, comme à la séance 1. S’il tourne sans vous et affiche les mêmes nombres, votre analyse est reproductible.
NoteAfficher l’indice
Une liste à cocher, dans l’ordre :
NoteAfficher la solution
Inspecter. Lisez d’abord tout comme du texte, puis regardez :
# 1. Lire : toutes les colonnes comme du texte, pour que R ne devine rien dans votre dos
repair_raw <- read_csv(here("data", "raw", "repair_me.csv"),
                       col_types = cols(.default = col_character()))

# 2. Inspecter
read_lines(here("data", "raw", "repair_me.csv"), n_max = 3)   # le fichier tel qu'il est stocké
[1] "country,iso_num,year,gdp_pc_ppp,life_exp"
[2] "Afghanistan,004,2015,\"2,967.7\",62.3"
[3] "Afghanistan,004,2019,\"2,927.2\",62.9" glimpse(repair_raw)Rows: 13
Columns: 5
$ country <chr> "Afghanistan", "Afghanistan", "Angola", "Angola", "Banglade…
$ iso_num <chr> "004", "004", "024", "024", "050", "050", "204", "204", "28…
$ year <chr> "2015", "2019", "2015", "2019", "2015", "2019", "2015", "20…
$ gdp_pc_ppp <chr> "2,967.7", "2,927.2", "11,389.8", "9,713.0", "5,352.7", "6,…
$ life_exp <chr> "62.3", "62.9", "61", "63.1", "70.5", "72.6", "n/a", "59.9"…repair_raw |> distinct(country)# A tibble: 7 × 1
country
<chr>
1 Afghanistan
2 Angola
3 Bangladesh
4 Benin
5 Ghana
6 kenya
7 KENYA repair_raw |> count(country, year) |> filter(n > 1)# A tibble: 1 × 3
country year n
<chr> <chr> <int>
1 Ghana 2019 2sort(unique(repair_raw$life_exp)) [1] "59.9" "61" "62.3" "62.9" "63.1" "63.2" "64.5" "70.5" "72.6" "n/a" Diagnostiquer. Les quatre problèmes et le piège :
-
Le PIB est stocké comme du texte, avec un séparateur de milliers (
"2,967.7") :as.numeric()renverraitNA;parse_number()sait le lire. -
Le Kenya a des libellés incohérents,
" kenya"et"KENYA "(espaces et majuscules) :distinct()affiche sept « pays » au lieu de six. - Ghana 2019 apparaît deux fois : il compterait deux fois dans la moyenne.
-
L’espérance de vie du Bénin en 2015 est écrite
"n/a": toute la colonne est du texte, etmean()ne peut pas l’utiliser. - Le piège :
iso_numest un code. Lu comme un nombre,"004"devient4, ce que font Excel ou la fonctionread.csv()de R de base. Gardez-le en texte.
Les versions récentes de read_csv() devinent seules certaines colonnes correctement (elles lisent "2,967.7" comme un nombre). Ne comptez pas dessus : la devinette dépend de la version du package et du fichier. Lire en texte puis convertir vous-même donne toujours le même résultat.
Réparer, une ligne par problème, puis vérifier :
# 3. Réparer
repaired <- repair_raw |>
  mutate(
    country    = str_to_title(str_trim(country)),     # " kenya", "KENYA " -> "Kenya"
    year       = as.integer(year),
    gdp_pc_ppp = parse_number(gdp_pc_ppp),            # "2,967.7" -> 2967.7
    life_exp   = as.numeric(na_if(life_exp, "n/a"))   # "n/a" -> NA, puis un nombre
  ) |>                                                # iso_num reste du texte : "004"
  distinct()                                          # supprime la seconde ligne Ghana 2019

# 4. Vérifier la réparation
glimpse(repaired)
Rows: 12
Columns: 5
$ country <chr> "Afghanistan", "Afghanistan", "Angola", "Angola", "Banglade…
$ iso_num <chr> "004", "004", "024", "024", "050", "050", "204", "204", "28…
$ year <int> 2015, 2019, 2015, 2019, 2015, 2019, 2015, 2019, 2015, 2019,…
$ gdp_pc_ppp <dbl> 2967.7, 2927.2, 11389.8, 9713.0, 5352.7, 6838.3, 2952.0, 32…
$ life_exp <dbl> 62.3, 62.9, 61.0, 63.1, 70.5, 72.6, NA, 59.9, 63.2, 64.5, 6…nrow(repaired) # 12 pays-années[1] 12repaired |> count(country, year) |> filter(n > 1) # vide : plus aucun doublon# A tibble: 0 × 3
# ℹ 3 variables: country <chr>, year <int>, n <int>Répondre, avec N :
# 5. Espérance de vie moyenne par année, avec N
life_by_year <- repaired |>
  summarise(
    n_countries = n(),
    n_life      = sum(!is.na(life_exp)),
    mean_life   = mean(life_exp, na.rm = TRUE),
    .by = year
  )

life_by_year
# A tibble: 2 × 4
year n_countries n_life mean_life
<int> <int> <int> <dbl>
1 2015 6 5 63.9
2 2019 6 6 64.3Espérance de vie moyenne sur les six pays : 63,86 ans en 2015 (N = 5 : le Bénin manque) et 64,32 ans en 2019 (N = 6).
Les deux moyennes ne reposent pas sur les mêmes pays. Pour comparer les années, gardez les pays observés les deux années :
# Les cinq mêmes pays les deux années : on retire le Bénin, manquant en 2015
life_same <- repaired |>
  filter(country != "Benin") |>
  summarise(n_countries = n(), mean_life = mean(life_exp), .by = year)

life_same
# A tibble: 2 × 3
year n_countries mean_life
<int> <int> <dbl>
1 2015 5 63.9
2 2019 5 65.2Sur les 5 mêmes pays, la moyenne passe de 63,86 à 65,20 ans. Avec le Bénin inclus en 2019 seulement, la hausse paraît plus faible, car le Bénin a l’espérance de vie la plus basse du groupe.
Relancer. Dernière étape : Session > Restart R, puis exécutez tout le script. Mêmes nombres ? Alors la réparation est terminée et documentée.
À retenir
- Le pipe
|>se lit « et ensuite » : un verbe par ligne, de haut en bas. -
filter()sélectionne des lignes,select()des colonnes,arrange()trie,mutate()crée des variables,summarise()(avecgroup_by()ou.by) condense en une ligne par groupe. - Les valeurs manquantes sont contagieuses :
na.rm = TRUEoudrop_na()règlent le calcul mais changent N. Indiquez toujours N. - Les facteurs donnent aux catégories un ordre qui a du sens (
factor(levels = ),fct_relevel(),fct_reorder()). - Données tidy : une variable par colonne, une observation par ligne, une valeur par cellule.
pivot_longer()etpivot_wider()permettent de passer d’un format à l’autre. - Une jointure ne se plaint jamais des clés sans correspondance. Joignez sur des codes (
iso3c), comptez les lignes avant et après, et lancezanti_join(). - Pour déboguer une chaîne, exécutez-la jusqu’à un
|>à la fois et vérifieznrow(). Les erreurs disent où ; les résultats vides, non. - Une fonction a des arguments (les entrées), un corps (le calcul) et renvoie sa dernière valeur. Testez-la sur un cas vérifiable à la main.
- Réparez un fichier désordonné dans un script, jamais à la main : inspecter, réparer, vérifier, puis tout relancer dans une session R neuve.