Sys.setenv(LANGUAGE = "en")   # messages de R en anglais

library(tidyverse)
library(scales)
library(ggrepel)
library(sf)
library(rnaturalearth)
library(here)

source(here("R", "theme_cours.R"))   # theme_cours(), pal_cours, pal_regions

wdi <- read_csv(here("data", "wdi_panel.csv"), show_col_types = FALSE)

# Une ligne par pays pour une année : la coupe transversale utilisée plus bas
wdi_2022 <- wdi |>
filter(year == 2022)Séance 5 : Visualiser avec ggplot2 (et cartes)
De la grammaire des graphiques à une carte choroplèthe du monde, avec les données de la Banque mondiale
Objectifs de la séance
- Lire n’importe quel ggplot comme un empilement de couches : données, esthétiques, geoms, échelles, libellés, thème.
- Construire le nuage de points « Gapminder » classique : espérance de vie en fonction du revenu, avec des échelles logarithmiques et des étiquettes lisibles.
- Choisir le bon graphique : ligne (évolution dans le temps), barres (comparaison), histogramme et boxplot (distribution).
- Appliquer le principe « signal contre contexte » : mettre en valeur une série, griser les autres.
- Dessiner une carte du monde avec
sf, la joindre sans risque aux données WDI et vérifier ce qui n’a pas été apparié. - Enregistrer une figure avec une taille et une résolution explicites.
Préparer votre session R
Packages utilisés aujourd’hui : tidyverse, scales, ggrepel, sf, rnaturalearth, rnaturalearthdata, here. Installez ceux qui manquent avec install.packages().
Script de la séance : télécharger seance-5.R, tout le code de cette page dans un seul fichier.
Tout au long de cette séance, nous utilisons le panel complet (wdi, environ 217 pays, 2000-2023). Quand un graphique demande un point par pays, nous retenons une seule année, 2022 (wdi_2022). Cela compte : une erreur fréquente consiste à tracer un histogramme sur des années empilées (par exemple 63 valeurs issues de trois pays). Un graphique ne vaut que par la question à laquelle ses données répondent.
Pourquoi 2022 ? C’est la dernière année bien couverte pour les variables que nous utilisons (2023 compte beaucoup plus de valeurs manquantes). La séance 4 utilisait 2019, dernière année d’avant la COVID-19, car elle étudiait une relation et non la situation actuelle.
Rythme. Le parcours principal dure environ 180 minutes, exercices compris. Les parties marquées Facultatif : pour aller plus loin (la partie annotation de l’exercice 5.5, et l’exercice 5.6) ajoutent environ 20 minutes : faites-les si le temps le permet, ou chez vous.
Vérifier les valeurs extrêmes avant de tracer (≈ 5 min)
Avant de dessiner quoi que ce soit, regardez les extrêmes : une seule valeur absurde étire un axe et masque tout le reste.
wdi_2022 |>
  drop_na(life_exp) |>
  slice_min(life_exp, n = 3) |>
  select(country, iso3c, life_exp)
# A tibble: 3 × 3
country iso3c life_exp
<chr> <chr> <dbl>
1 Central African Republic CAF 18.8
2 Somalia, Fed. Rep. SOM 53.9
3 Nigeria NGA 54.1La République centrafricaine affiche une espérance de vie de 18,8 ans en 2022. Le pays suivant est à environ 54 ans. Cette valeur est invraisemblable : c’est un artefact de données, pas un résultat. Comme l’a montré la séance 4, il ne s’agit pas d’une anomalie isolée : toute la série d’espérance de vie de la Centrafrique est peu fiable dans cette version des WDI (elle indique aussi 14,7 ans en 2009). Nous ne modifions jamais le fichier brut ; nous excluons la série explicitement, pour toutes les années, et nous le disons, avec la même ligne qu’à la séance 4. Mettre à NA uniquement life_exp conserve les autres variables du pays (par exemple l’accès à l’électricité, utilisé dans la carte plus bas).
# L'espérance de vie de la RCA n'est pas fiable dans cette version des WDI (14,7 en 2009, 18,8 en 2022) : on l'exclut pour toutes les années
wdi <- wdi |> mutate(life_exp = if_else(iso3c == "CAF", NA_real_, life_exp))

wdi_2022 <- filter(wdi, year == 2022)
La grammaire des graphiques
≈ 25 min Après cette section, vous saurez lire n’importe quel ggplot comme un empilement de couches et en construire un pas à pas.
Un ggplot n’est pas un « type de graphique ». C’est une recette aux ingrédients indépendants, ajoutés avec + :
| Ingrédient | Question à laquelle il répond | Code typique |
|---|---|---|
| data (données) | Quel tableau ? | ggplot(data = wdi_2022) |
| aesthétiques (« esthétiques ») | Quelle variable va vers quel canal visuel (x, y, couleur, taille) ? | aes(x = gdp_pc_ppp, y = life_exp) |
| geom | Quelle forme dessine les données ? | geom_point() |
| scales (échelles) | Comment une valeur est-elle traduite en position / couleur / taille ? |
scale_x_log10(), scale_colour_manual()
|
| labs (libellés) | Que lit le lecteur, en mots ? | labs(title = , x = , y = , caption = ) |
| theme (thème) | À quoi ressemble tout ce qui n’est pas donnée ? | theme_cours() |
Esthétique (aesthetic) : un canal visuel (x, y, couleur, remplissage, taille, forme) que vous reliez à une variable dans aes(). Geom : la forme qui dessine les données (point, ligne, barre…). Échelle (scale) : la règle qui traduit une valeur de donnée en une position ou une couleur. Facette (facet) : un petit multiple, le même graphique répété pour chaque groupe.
flowchart LR
  A[données] --> B[aes]
  B --> C[geom]
  C --> D[échelles]
  D --> E[libellés]
  E --> F[thème]
La règle à retenir : les esthétiques relient des variables, les arguments fixent des constantes. aes(colour = region) colorie selon les données ; colour = "red" en dehors de aes() peint tout en rouge.
ImportantIdée clé
Un ggplot se construit en ajoutant des couches avec +. On ne demande jamais « un nuage de points » : on fournit des données, on dit quelles variables vont où, et on choisit une forme. Tout le reste (échelles, libellés, thème) affine le résultat.
Construisons un graphique, un ingrédient à la fois. Les étapes 1 à 4 sont présentées côte à côte pour que vous voyiez ce qu’ajoute chaque + ; l’étape 5 est la figure finale.
wdi_2022_ok <- wdi_2022 |>
  drop_na(gdp_pc_ppp, life_exp)        # un point a besoin des deux coordonnées

ggplot(wdi_2022_ok, aes(x = gdp_pc_ppp, y = life_exp))
ggplot(wdi_2022_ok, aes(x = gdp_pc_ppp, y = life_exp)) +
  geom_point()
ggplot(wdi_2022_ok, aes(x = gdp_pc_ppp, y = life_exp)) +
  geom_point() +
  scale_x_log10(labels = label_dollar(scale_cut = cut_short_scale()))
ggplot(wdi_2022_ok, aes(x = gdp_pc_ppp, y = life_exp, colour = region)) +
  geom_point(alpha = 0.8) +
  scale_x_log10(labels = label_dollar(scale_cut = cut_short_scale())) +
  scale_colour_manual(values = pal_regions, guide = "none")
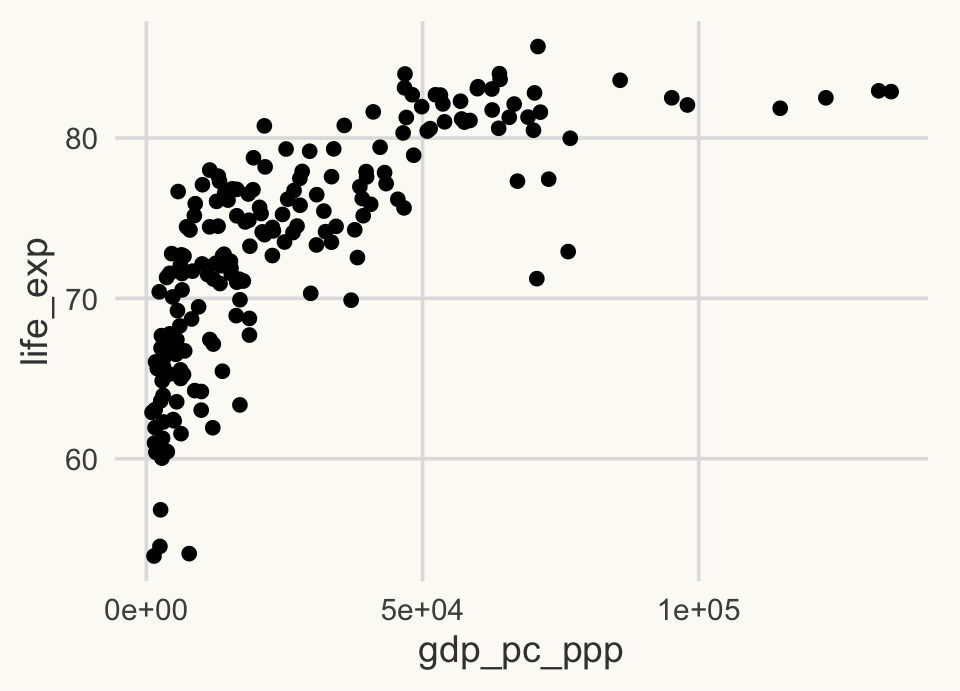
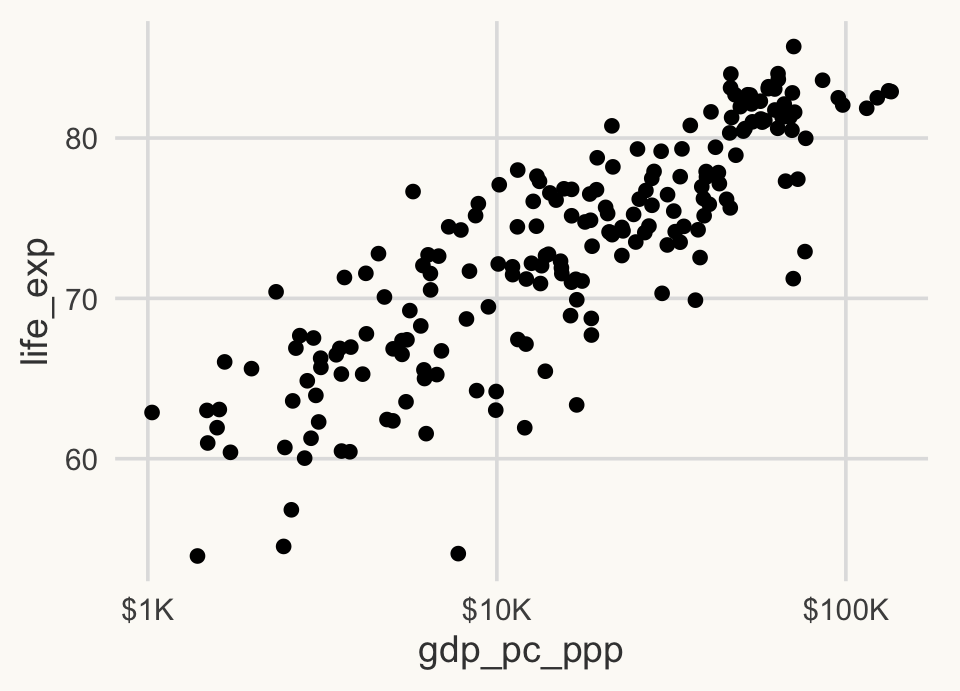
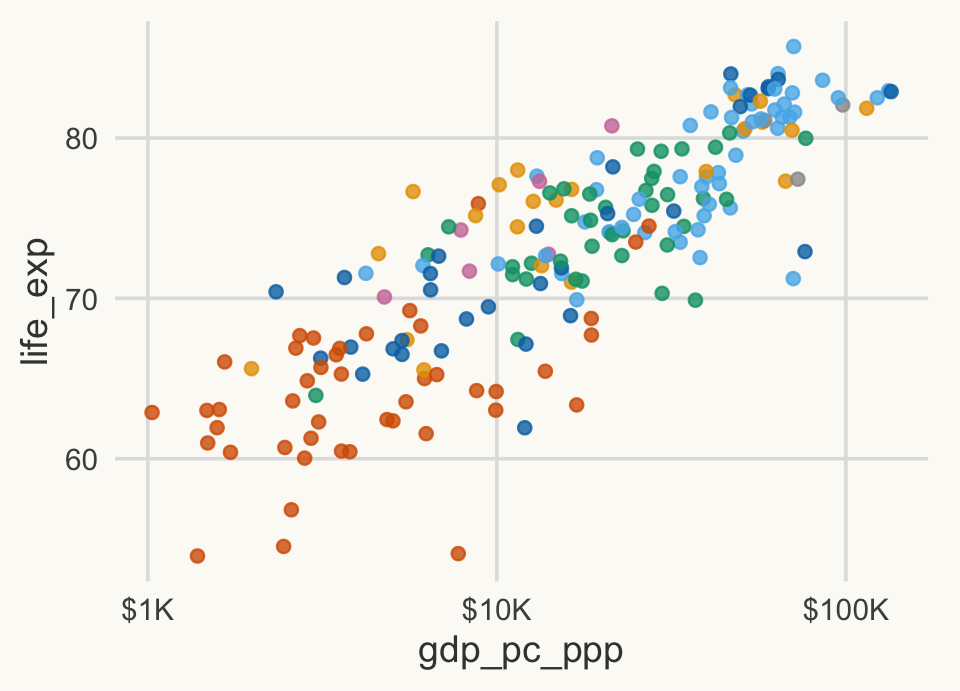
À l’étape 2, la plupart des pays sont écrasés à gauche : le revenu est très asymétrique, et une échelle logarithmique (étape 3) les répartit. À l’étape 4, la légende est masquée uniquement pour garder le petit panneau lisible ; l’étape 5 la rétablit.
Étape 5. Libellés et thème : le message dans le titre, les unités sur les axes, la source.
ggplot(wdi_2022_ok, aes(x = gdp_pc_ppp, y = life_exp, colour = region)) +
  geom_point(alpha = 0.8) +
  scale_x_log10(labels = label_dollar(scale_cut = cut_short_scale())) +
  scale_colour_manual(values = pal_regions) +
  guides(colour = guide_legend(nrow = 4, title.position = "top")) +
  labs(
    title = str_wrap("Les pays plus riches vivent plus longtemps, mais les gains s'aplatissent en haut", 60),
    x = "PIB par habitant, PPA (en $ internationaux constants de 2021, échelle log)",
    y = "Espérance de vie à la naissance (ans)",
    colour = "Région",
    caption = "Source : Banque mondiale, World Development Indicators (WDI), 2022."
  ) +
  theme_cours(base_size = 11)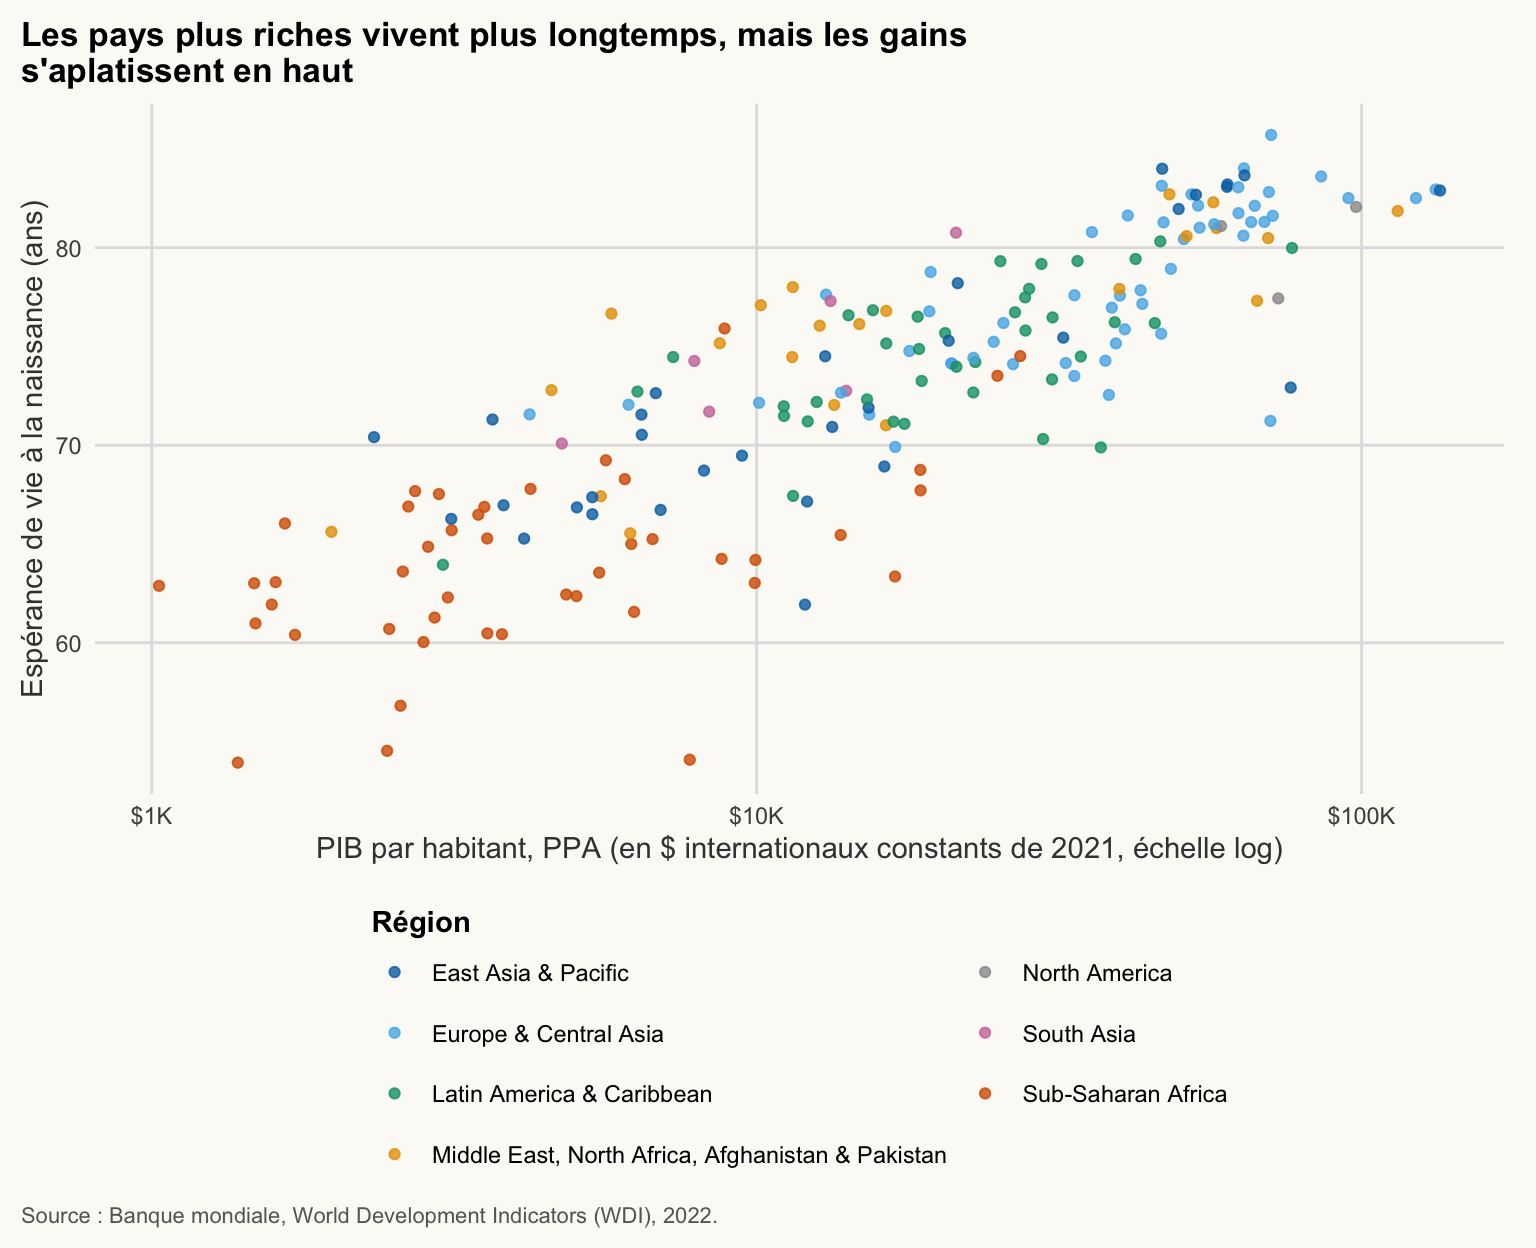
NotePourquoi
theme_cours() s’applique déjà
R/theme_cours.R appelle theme_set(theme_cours()), donc tous les graphiques utilisent le thème du cours par défaut. Écrire + theme_cours(base_size = 11) n’est nécessaire que pour changer un argument (ici, un texte plus petit pour les petites figures).
AvertissementErreur fréquente
Écrire aes(colour = "red") au lieu de colour = "red". Dans aes(), "red" est traité comme une variable à une seule valeur : ggplot invente donc une légende et choisit sa propre couleur (saumon, pas rouge). Couleur fixe : en dehors de aes(). Couleur selon les données : dans aes().
NoteEn clair
Pensez à un ggplot comme à un sandwich : les données sont le pain, chaque + ajoute une garniture. Vous pouvez ajouter ou retirer une garniture sans refaire tout le reste.
Le nuage de points Gapminder
≈ 25 min Après cette section, vous saurez combiner quatre variables sur un même graphique et étiqueter quelques points sans encombrement.
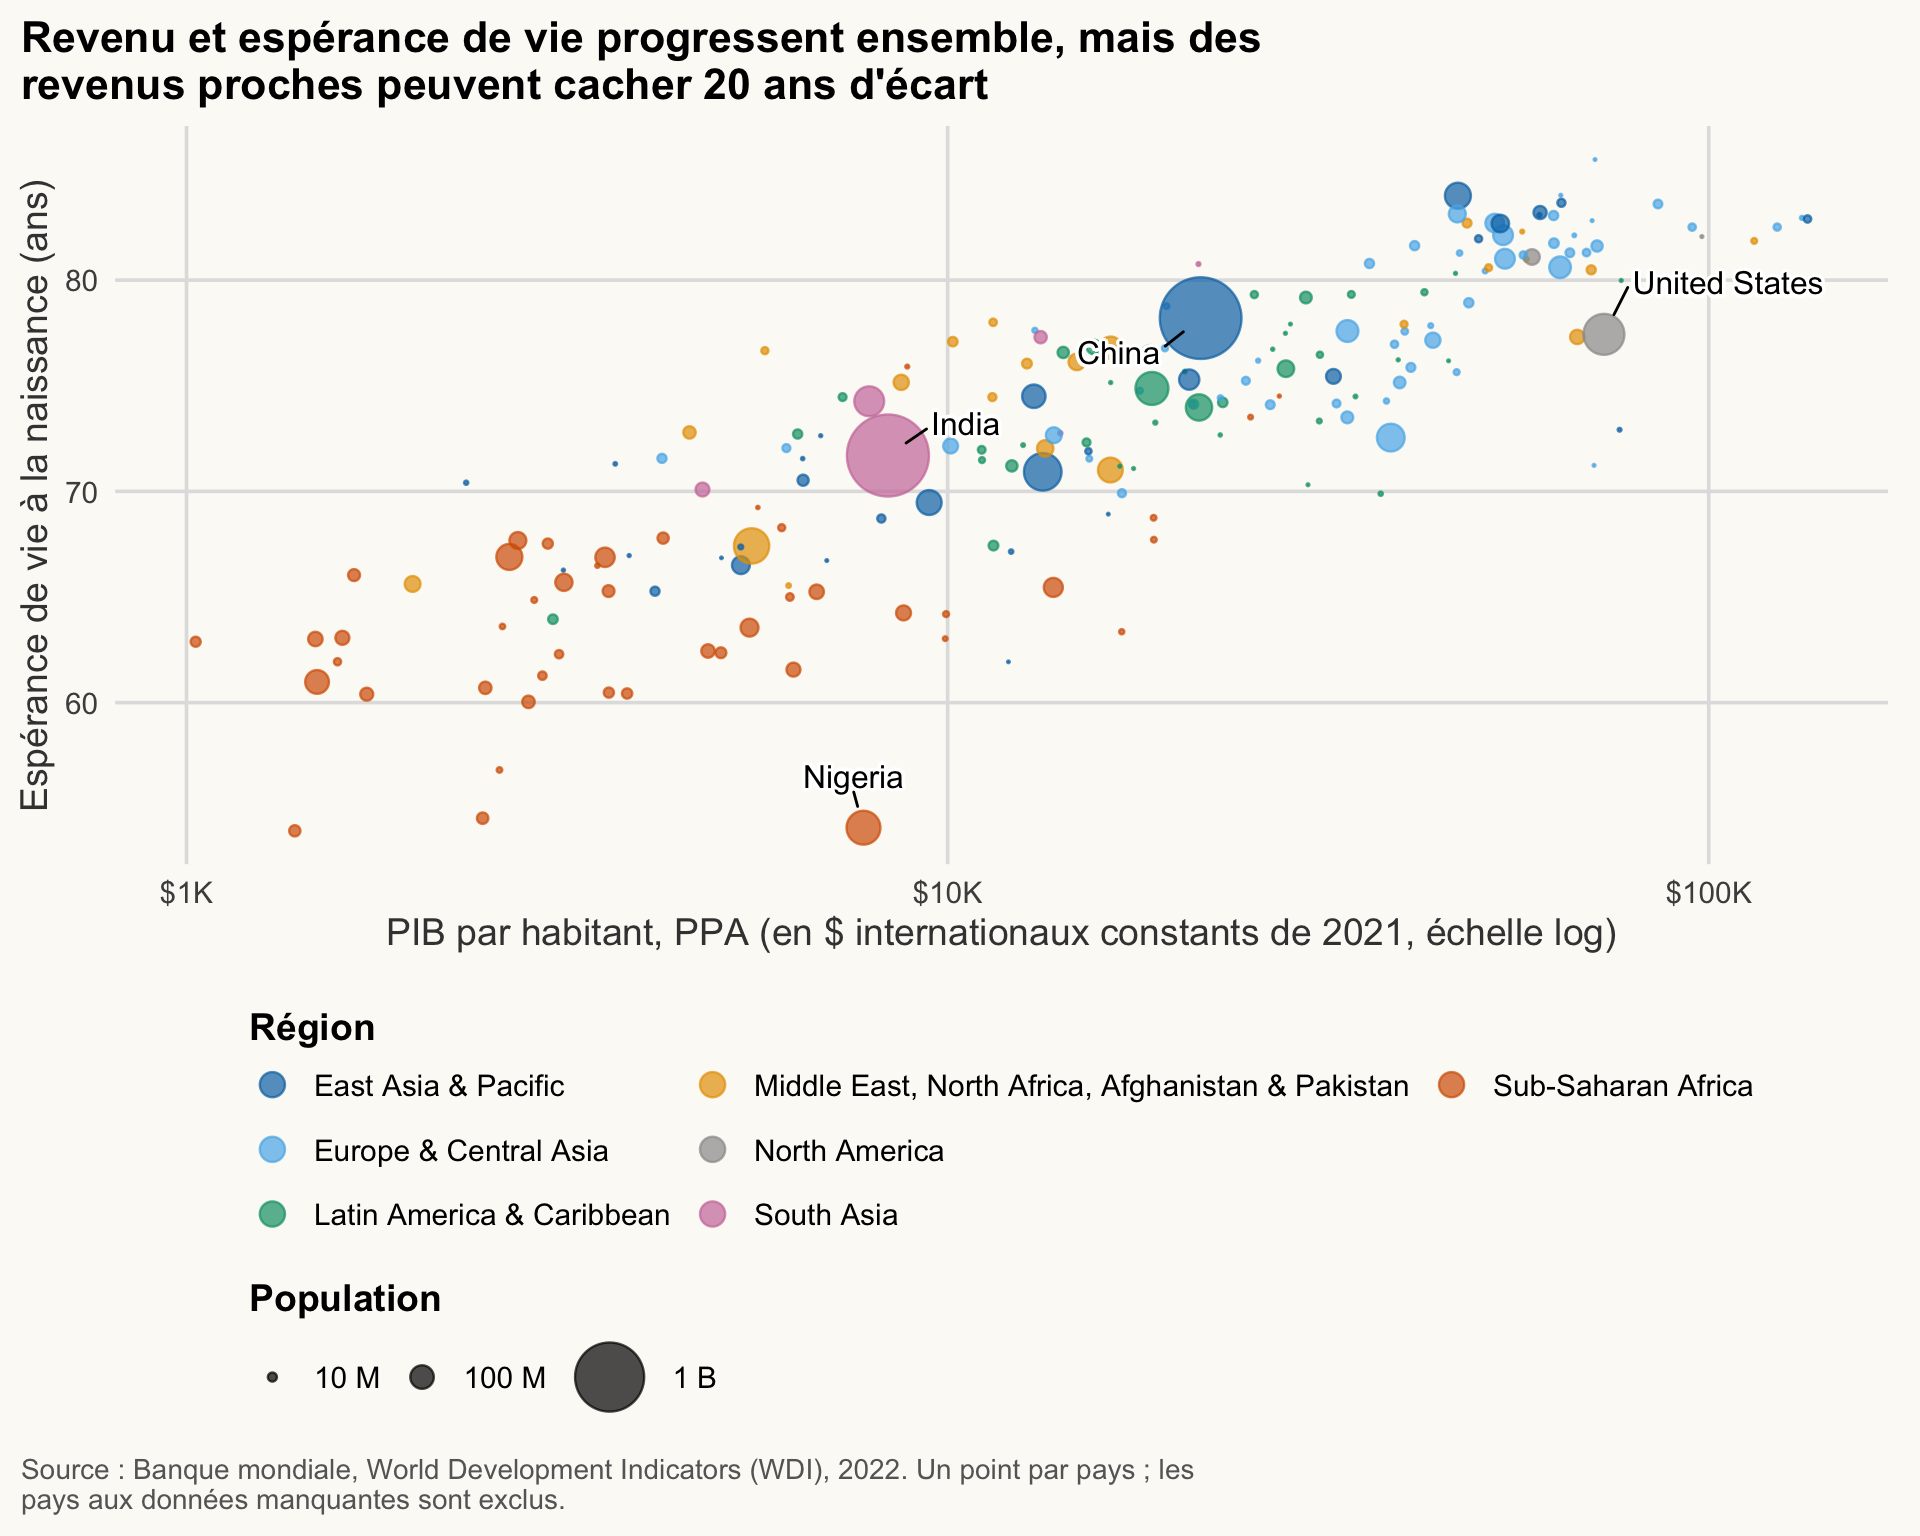
C’est la figure qui a rendu Hans Rosling célèbre : revenu, santé, population et région sur un seul graphique. Nous ajoutons une quatrième variable (la population, en taille des points) et étiquetons quelques pays avec ggrepel, qui déplace les étiquettes pour qu’elles ne se chevauchent pas.
focus <- c("China", "India", "Nigeria", "United States")

ggplot(wdi_2022_ok, aes(x = gdp_pc_ppp, y = life_exp)) +
  geom_point(aes(size = population, colour = region), alpha = 0.7) +
  geom_text_repel(
    data = filter(wdi_2022_ok, country %in% focus),
    aes(label = country),
    min.segment.length = 0, box.padding = 1, point.padding = 0.5, seed = 1, size = 4.2,
    bg.color = "white", bg.r = 0.15
  ) +
  scale_x_log10(labels = label_dollar(scale_cut = cut_short_scale())) +
  scale_size_area(max_size = 14, breaks = c(1e7, 1e8, 1e9),
                  labels = c("10 M", "100 M", "1 B")) +
  scale_colour_manual(values = pal_regions) +
  guides(colour = guide_legend(nrow = 3, title.position = "top", order = 1,
                               override.aes = list(size = 4)),
         size = guide_legend(title.position = "top", order = 2)) +
  theme(legend.position = "bottom", legend.box = "vertical",
        legend.box.just = "left", legend.spacing.y = unit(2, "pt")) +
  labs(
    title = str_wrap("Revenu et espérance de vie progressent ensemble, mais des revenus proches peuvent cacher 20 ans d'écart", 60),
    x = "PIB par habitant, PPA (en $ internationaux constants de 2021, échelle log)",
    y = "Espérance de vie à la naissance (ans)",
    colour = "Région", size = "Population",
    caption = str_wrap("Source : Banque mondiale, World Development Indicators (WDI), 2022. Un point par pays ; les pays aux données manquantes sont exclus.", 95)
  )
NoteComment lire ce graphique
- Chaque bulle est un pays. Plus haut signifie une vie plus longue, plus à droite signifie plus riche, plus gros signifie plus d’habitants.
- Le nuage monte vite à gauche et s’aplatit à droite : 10 000 $ de plus comptent beaucoup à 2 000 $, peu à 40 000 $.
- À revenu égal, les pays peuvent différer d’environ 20 ans : le revenu est loin de tout expliquer.
Conseils de lecture :
- L’axe x est logarithmique : des distances égales signifient des écarts en pourcentage égaux de revenu. Passer de 2 000 $ à 4 000 $ compte autant que passer de 20 000 $ à 40 000 $.
-
scale_size_area()rend l’aire proportionnelle à la population. L’échelle par défautscale_size()est elle aussi basée sur l’aire mais ne part pas de zéro, ce qui exagère les petits pays. -
geom_text_repel(data = ...)prend ses propres données : seuls les quatre pays retenus sont étiquetés, le reste du graphique est inchangé. C’est ainsi que l’on étiquette quelques points sans encombrement. - Une échelle est la règle qui va de la valeur au canal visuel ;
scale_size_area()est l’échelle de l’esthétiquesize,scale_x_log10()celle dex. - C’est une coupe transversale, pas un résultat causal : les pays riches diffèrent par bien d’autres aspects (institutions, climat, charge de morbidité). La courbe décrit, elle ne dit pas que l’argent cause la longévité.
AvertissementErreur fréquente
Colour contre fill. colour peint les contours et les points ; fill peint les surfaces (barres, boîtes, polygones). Utiliser colour = region sur geom_col() donne des contours colorés et des barres grises : passez à fill. Pour geom_point(), la forme par défaut n’a pas d’intérieur, donc colour est le bon choix.
AstuceExercice 5.1
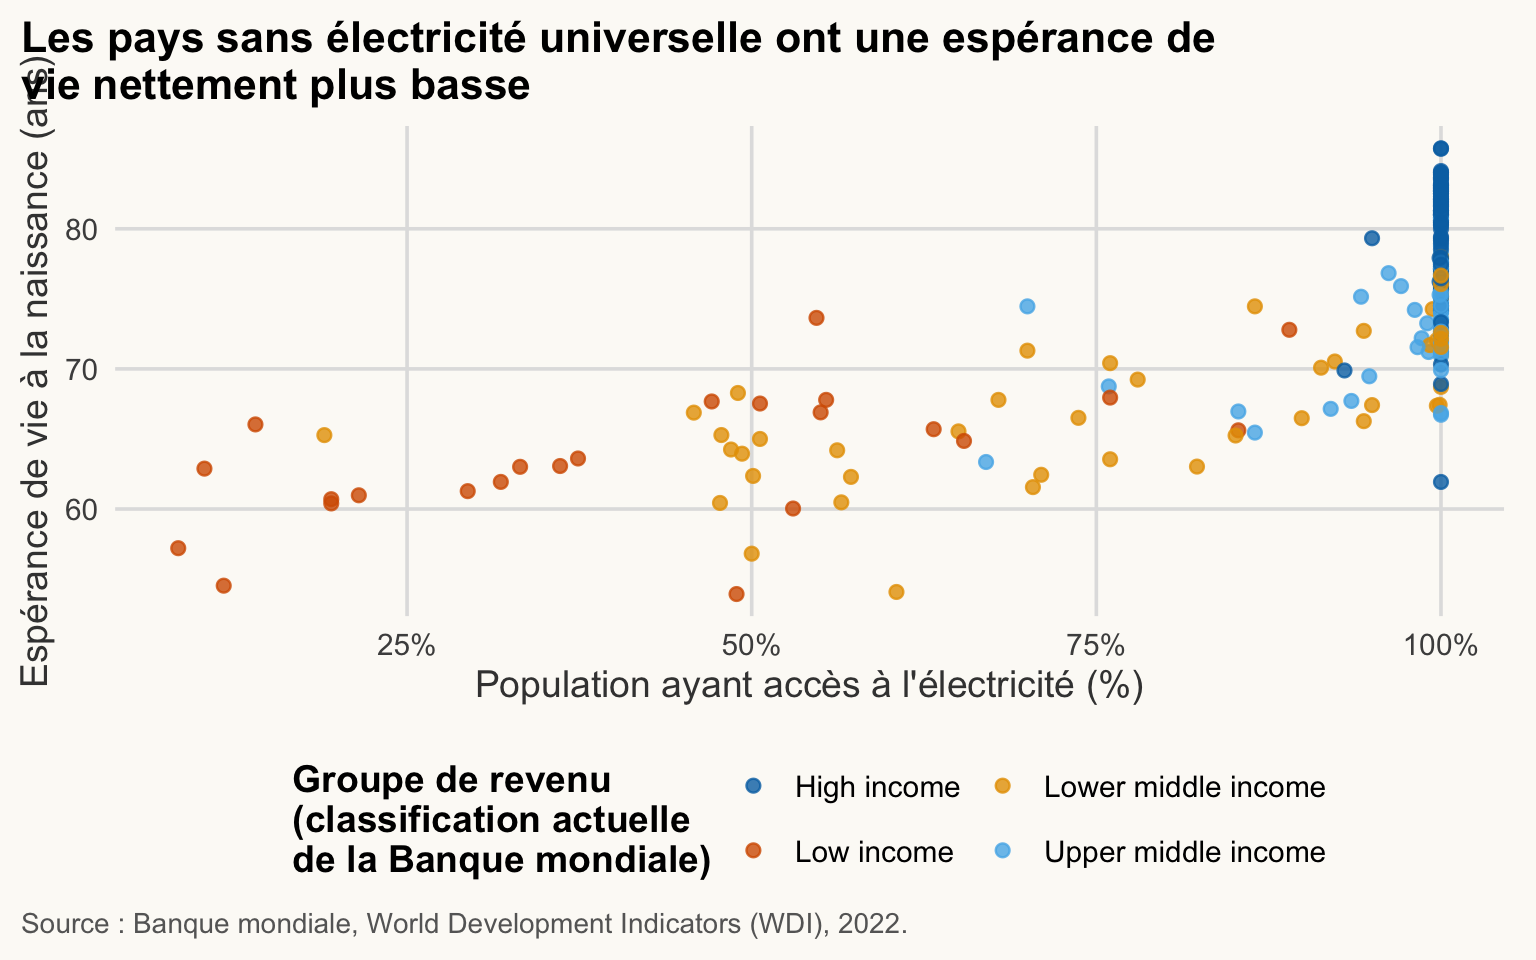
Avec wdi_2022_ok, tracez un nuage de points de l’espérance de vie (y) en fonction de l’accès à l’électricité (x, % de la population), colorié selon le groupe de income. Supprimez d’abord les valeurs manquantes, donnez-lui un titre qui énonce le message et des axes étiquetés.
NoteAfficher la solution
wdi_2022 |>
  drop_na(elec_access, life_exp, income) |>
  ggplot(aes(x = elec_access, y = life_exp, colour = income)) +
  geom_point(alpha = 0.8, size = 2) +
  scale_x_continuous(labels = label_number(suffix = "%")) +
  scale_colour_manual(values = c("Low income" = "#D55E00", "Lower middle income" = "#E69F00",
                                 "Upper middle income" = "#56B4E9", "High income" = "#0072B2")) +
  guides(colour = guide_legend(nrow = 2)) +
  labs(
    title = str_wrap("Les pays sans électricité universelle ont une espérance de vie nettement plus basse", 60),
    x = "Population ayant accès à l'électricité (%)",
    y = "Espérance de vie à la naissance (ans)",
    colour = str_wrap("Groupe de revenu (classification actuelle de la Banque mondiale)", 25),
    caption = str_wrap("Source : Banque mondiale, World Development Indicators (WDI), 2022.", 95)
  )
Lignes : l’évolution dans le temps
≈ 25 min Après cette section, vous saurez tracer une série temporelle qui met en valeur un pays et étiqueter directement les lignes.
Avant de choisir un geom, demandez-vous à quelle question vous répondez :
ImportantIdée clé : quel graphique pour quelle question ?
| Votre question | Graphique | Geom |
|---|---|---|
| Comparer des groupes ou des pays | barres |
geom_col(), geom_bar()
|
| Comment une variable se répartit-elle ? | histogramme, densité, boxplot |
geom_histogram(), geom_density(), geom_boxplot()
|
| Deux variables sont-elles liées ? | nuage de points | geom_point() |
| Comment évolue-t-elle dans le temps ? | ligne | geom_line() |
| Où se trouve-t-elle ? | carte | geom_sf() |
Une ligne relie des observations dans un ordre qui a un sens (ici, les années) pour la même unité (ici, un pays). Vous devez dire à ggplot quels points vont ensemble avec group (ou avec colour, qui regroupe implicitement).
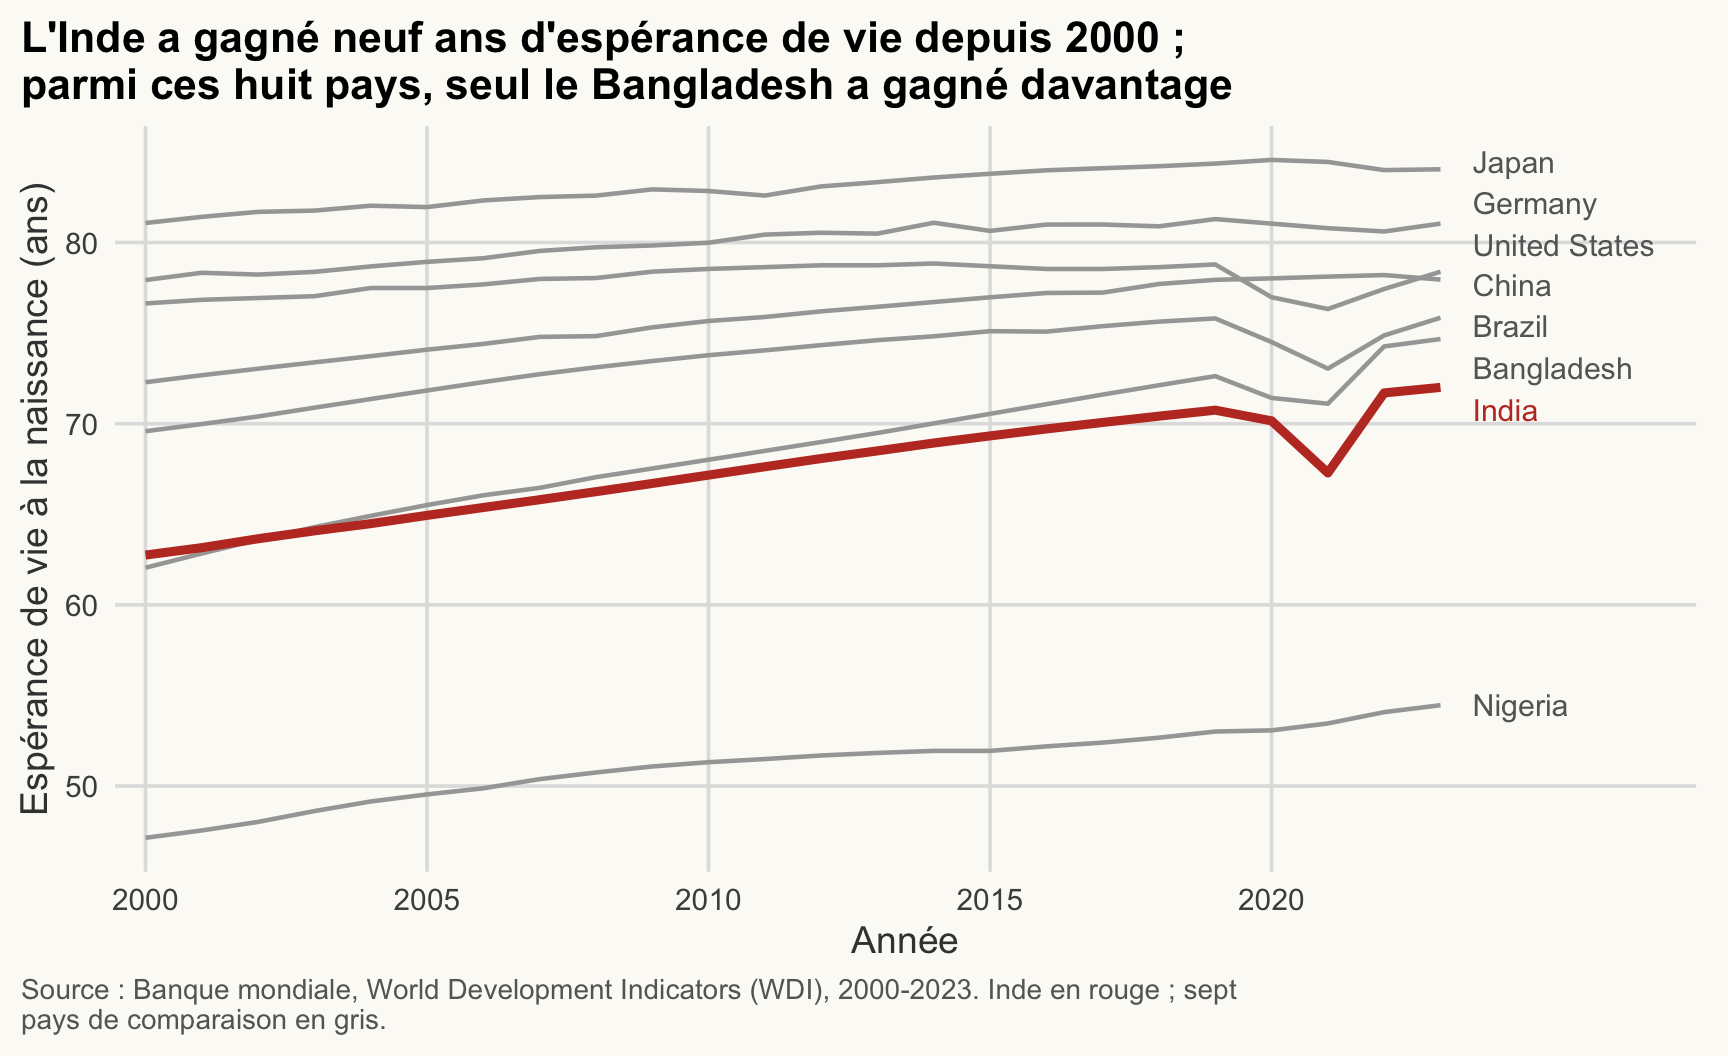
Le principe de dataviz de l’atelier : signal contre contexte. Si tout est en couleur, rien ne ressort. Dessinez d’abord le contexte en gris, puis le signal par-dessus, en couleur.
compare <- c("India", "China", "Nigeria", "Brazil", "United States", "Germany", "Japan", "Bangladesh")
highlight <- "India"

life_lines <- wdi |>
  filter(country %in% compare) |>
  drop_na(life_exp)

ggplot(life_lines, aes(x = year, y = life_exp, group = country)) +
  geom_line(data = filter(life_lines, country != highlight),
            colour = pal_cours[["gris"]], linewidth = 0.8) +
  geom_line(data = filter(life_lines, country == highlight),
            colour = pal_cours[["accent"]], linewidth = 1.6) +
  geom_text_repel(data = filter(life_lines, year == max(year)),
                  aes(label = country, colour = country == highlight),
                  hjust = 0, direction = "y", xlim = c(2023.4, NA), size = 4,
                  segment.color = NA, show.legend = FALSE, seed = 1) +
  scale_colour_manual(values = c(`TRUE` = pal_cours[["accent"]], `FALSE` = "grey40")) +
  scale_x_continuous(breaks = seq(2000, 2020, 5), expand = expansion(mult = c(0.02, 0.02))) +
  coord_cartesian(xlim = c(2000, 2027), clip = "off") +
  labs(
    title = str_wrap("L'Inde a gagné neuf ans d'espérance de vie depuis 2000 ; parmi ces huit pays, seul le Bangladesh a gagné davantage", 60),
    x = "Année",
    y = "Espérance de vie à la naissance (ans)",
    caption = str_wrap("Source : Banque mondiale, World Development Indicators (WDI), 2000-2023. Inde en rouge ; sept pays de comparaison en gris.", 95)
  )
NoteComment lire ce graphique
- La ligne rouge est le signal (l’Inde) ; les lignes grises sont le contexte. Comparez les pentes, pas seulement les points d’arrivée.
- Des lignes qui montent régulièrement signifient des gains réguliers ; le petit creux autour de 2020-2021 est un choc partagé par plusieurs pays.
- Les noms à l’extrémité droite remplacent la légende : suivez une ligne jusqu’à son étiquette.
Points à remarquer :
- Deux couches
geom_line(), chacune avec ses propresdata: le contexte gris d’abord, le signal rouge par-dessus. - Les étiquettes sont placées au bout des lignes (
year == max(year)), donc aucune légende n’est nécessaire. L’étiquetage direct se lit plus vite qu’une légende. -
coord_cartesian(xlim = ...)laisse de la place à droite pour les étiquettes, etgeom_text_repel(direction = "y")les écarte verticalement pour qu’elles ne se chevauchent pas. - Le creux de 2020-2021 est visible pour plusieurs pays : c’est la surmortalité liée à la COVID-19.
- Dans les versions actuelles de ggplot2, l’argument de largeur de ligne est
linewidth =(et nonsize =).
AstuceExercice 5.2
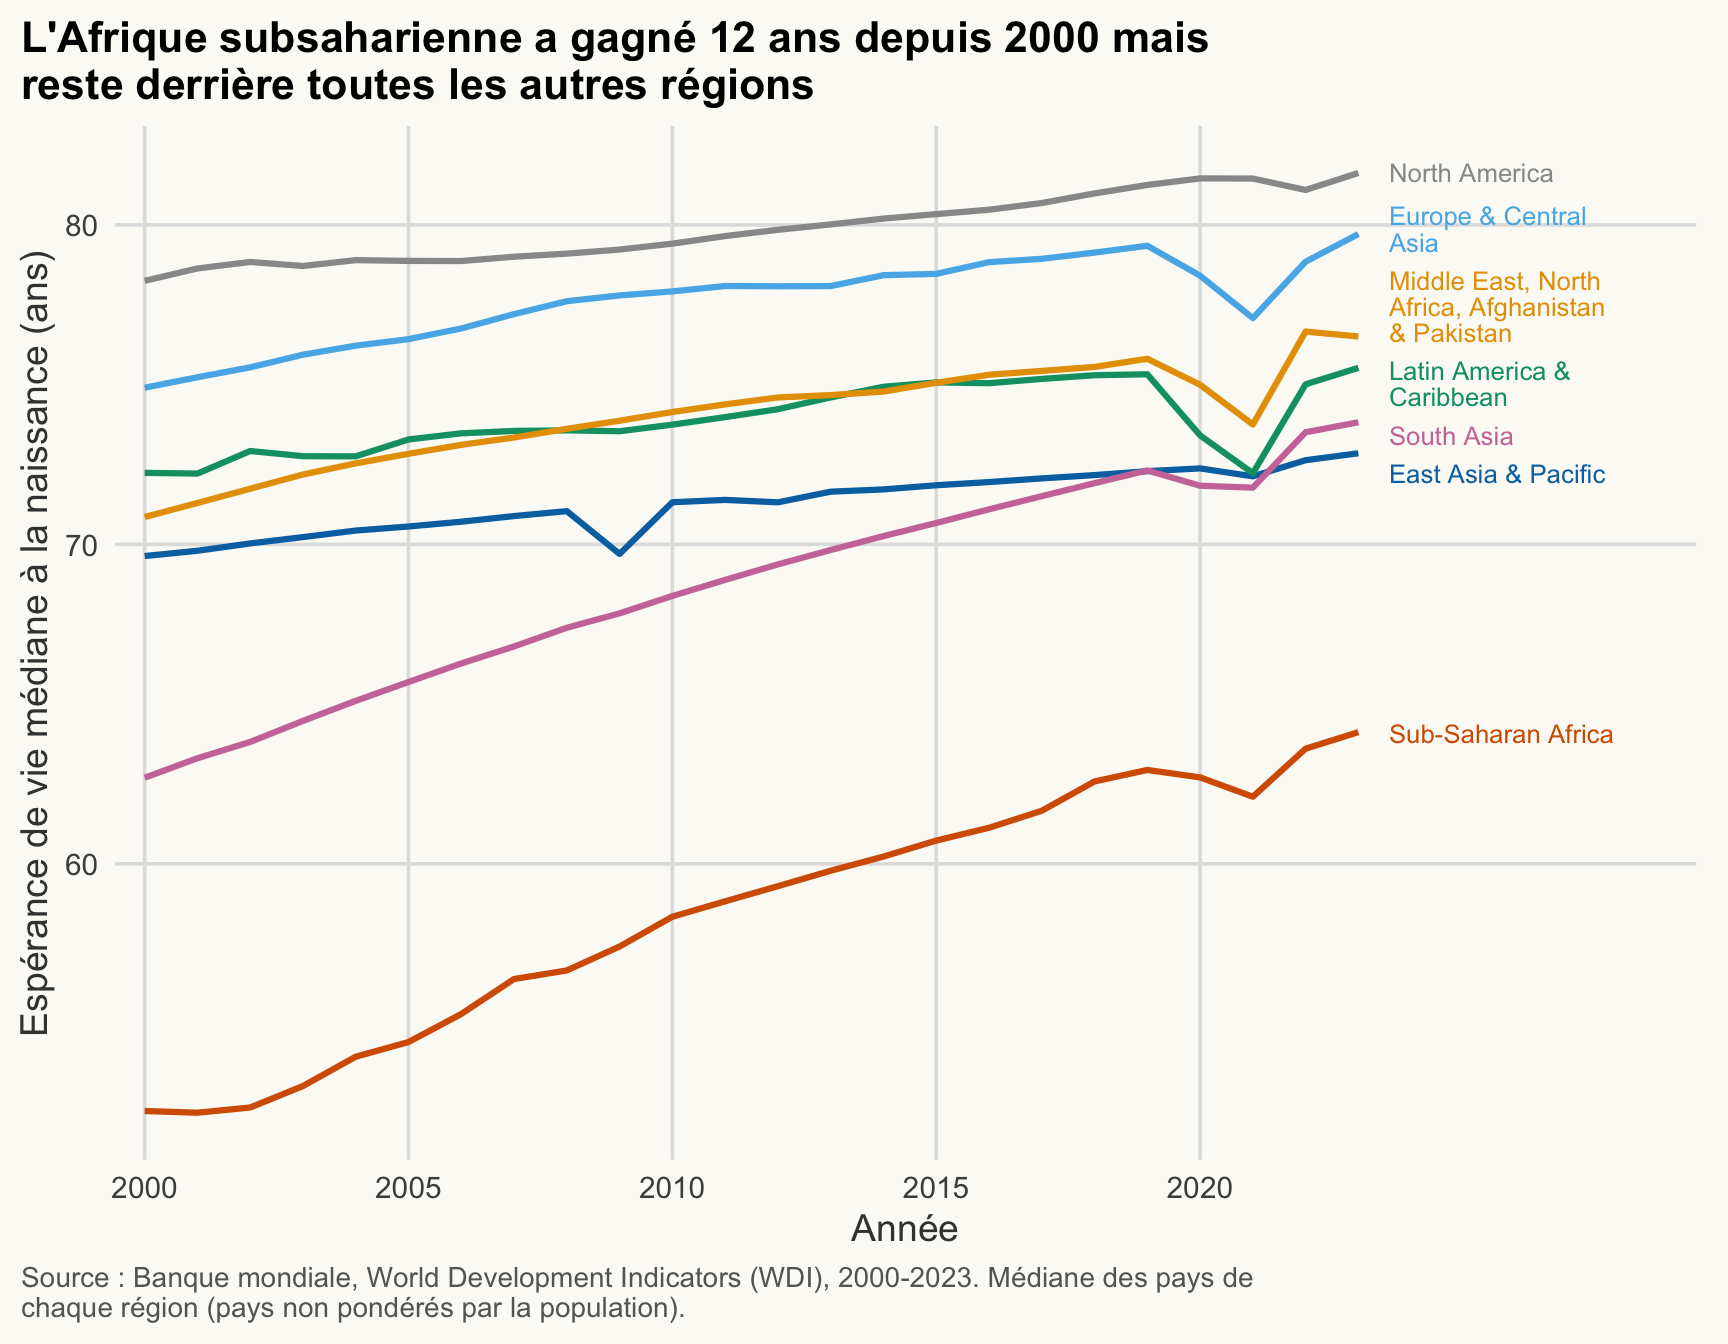
Pour chaque région, calculez l’espérance de vie médiane par année (utilisez wdi). Tracez une ligne par région avec les couleurs de pal_regions, étiquetée directement à l’extrémité droite (pas de légende). Titre : le message.
NoteAfficher la solution
life_region <- wdi |>
  drop_na(life_exp) |>
  summarise(life_med = median(life_exp), .by = c(region, year))

ggplot(life_region, aes(x = year, y = life_med, colour = region)) +
  geom_line(linewidth = 1.1) +
  geom_text_repel(
    data = filter(life_region, year == max(year)),
    aes(label = str_wrap(region, 20)),
    hjust = 0, direction = "y", xlim = c(2023.4, NA), size = 3.4, lineheight = 0.85,
    segment.color = NA, show.legend = FALSE
  ) +
  scale_colour_manual(values = pal_regions, guide = "none") +
  scale_x_continuous(breaks = seq(2000, 2020, 5), expand = expansion(mult = c(0.02, 0.05))) +
  coord_cartesian(xlim = c(2000, 2028), clip = "off") +
  labs(
    title = str_wrap("L'Afrique subsaharienne a gagné 12 ans depuis 2000 mais reste derrière toutes les autres régions", 60),
    x = "Année",
    y = "Espérance de vie médiane à la naissance (ans)",
    caption = str_wrap("Source : Banque mondiale, World Development Indicators (WDI), 2000-2023. Médiane des pays de chaque région (pays non pondérés par la population).", 95)
  )
Barres : comparer des groupes
≈ 25 min Après cette section, vous saurez choisir entre geom_col() et geom_bar() et produire des diagrammes en barres honnêtes et triés.
Deux diagrammes en barres différents, deux geoms différents :
| Vous avez… | Utilisez | Ce que ça fait |
|---|---|---|
| des lignes brutes, vous voulez des effectifs | geom_bar() |
compte les lignes pour vous |
| un nombre déjà calculé par groupe | geom_col() |
utilise votre y comme hauteur de barre |
(Une erreur fréquente est geom_bar(stat = "identity"). geom_col() fait la même chose, en plus clair.)
Valeurs : PIB par habitant médian par région, trié
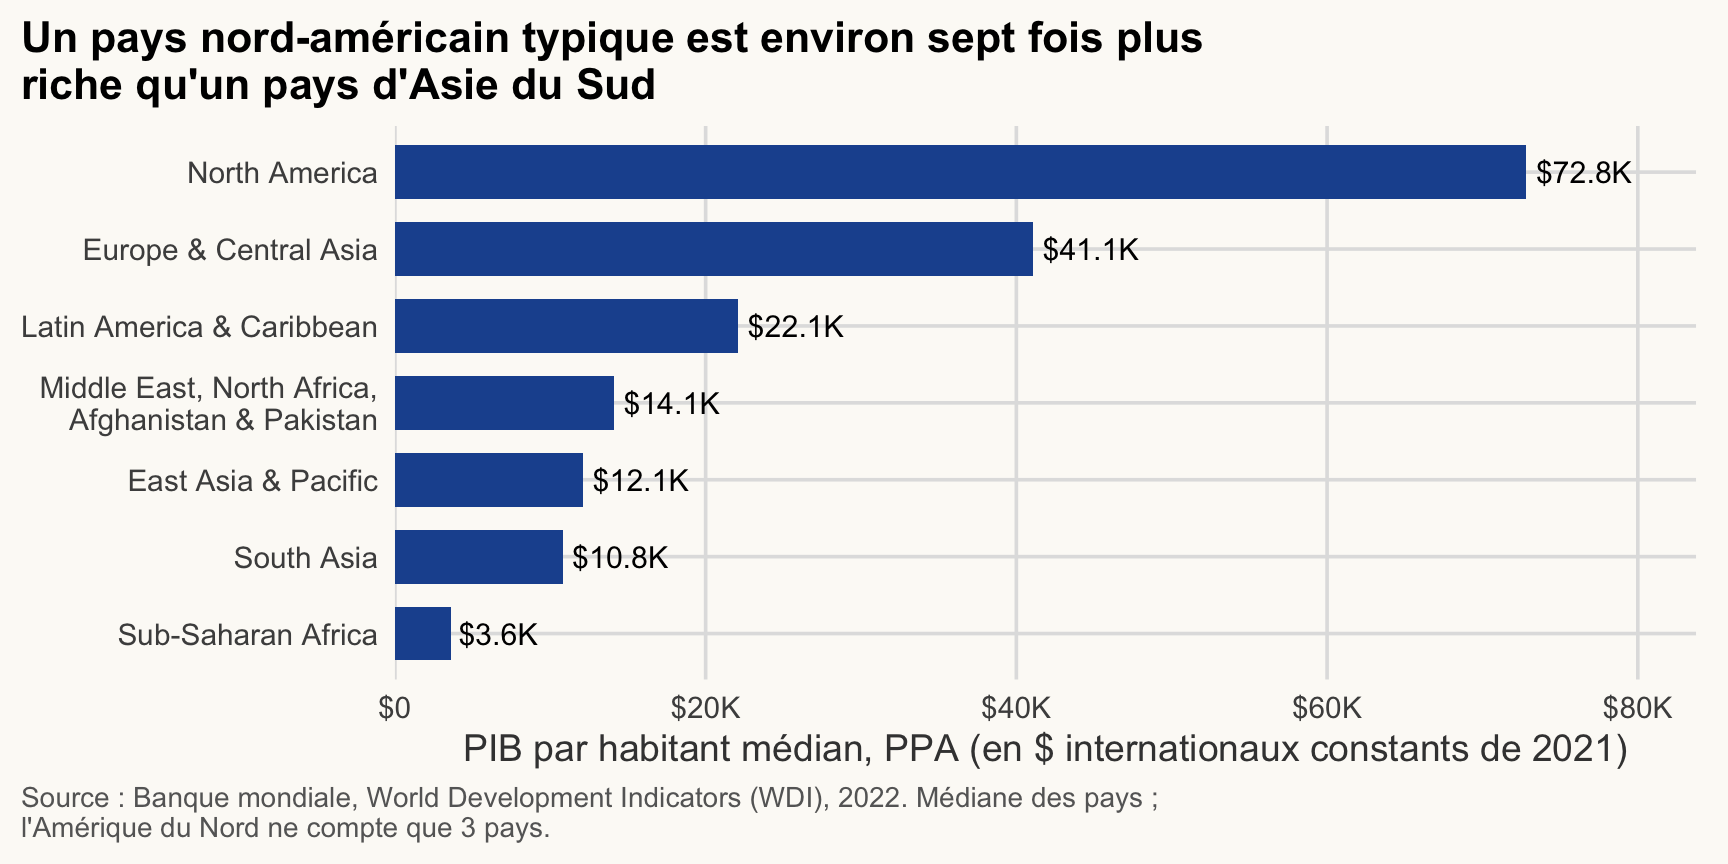
Deux règles pour les diagrammes en barres : partir de zéro et trier les barres. Pour des catégories textuelles, placez les longues étiquettes sur l’axe vertical (barres horizontales). fct_reorder() trie un facteur selon une autre variable.
gdp_region <- wdi_2022_ok |>
  summarise(gdp_med = median(gdp_pc_ppp), n_countries = n(), .by = region)

gdp_region |>
  mutate(region = fct_reorder(region, gdp_med)) |>
  ggplot(aes(x = gdp_med, y = region)) +
  geom_col(fill = pal_cours[["principal"]], width = 0.7) +
  geom_text(aes(label = label_dollar(accuracy = 0.1, scale_cut = cut_short_scale())(gdp_med)), hjust = -0.1, size = 4) +
  scale_x_continuous(labels = label_dollar(scale_cut = cut_short_scale()), expand = expansion(mult = c(0, 0.15))) +
  scale_y_discrete(labels = label_wrap(28)) +
  labs(
    title = str_wrap("Un pays nord-américain typique est environ sept fois plus riche qu'un pays d'Asie du Sud", 60),
    x = "PIB par habitant médian, PPA (en $ internationaux constants de 2021)",
    y = NULL,
    caption = str_wrap("Source : Banque mondiale, World Development Indicators (WDI), 2022. Médiane des pays ; l'Amérique du Nord ne compte que 3 pays.", 95)
  )
AvertissementErreur fréquente
Axes de barres tronqués. Une barre code une valeur par sa longueur, donc l’axe doit partir de zéro. Partir de 50 fait paraître un écart de 10 % comme un écart de 100 %. Si zéro n’a pas de sens, utilisez des points ou des lignes plutôt que des barres. (Même logique : pas de barres en 3D, et ne laissez pas les barres en ordre alphabétique quand les valeurs peuvent être classées.)
Effectifs : nombre de pays par groupe de revenu
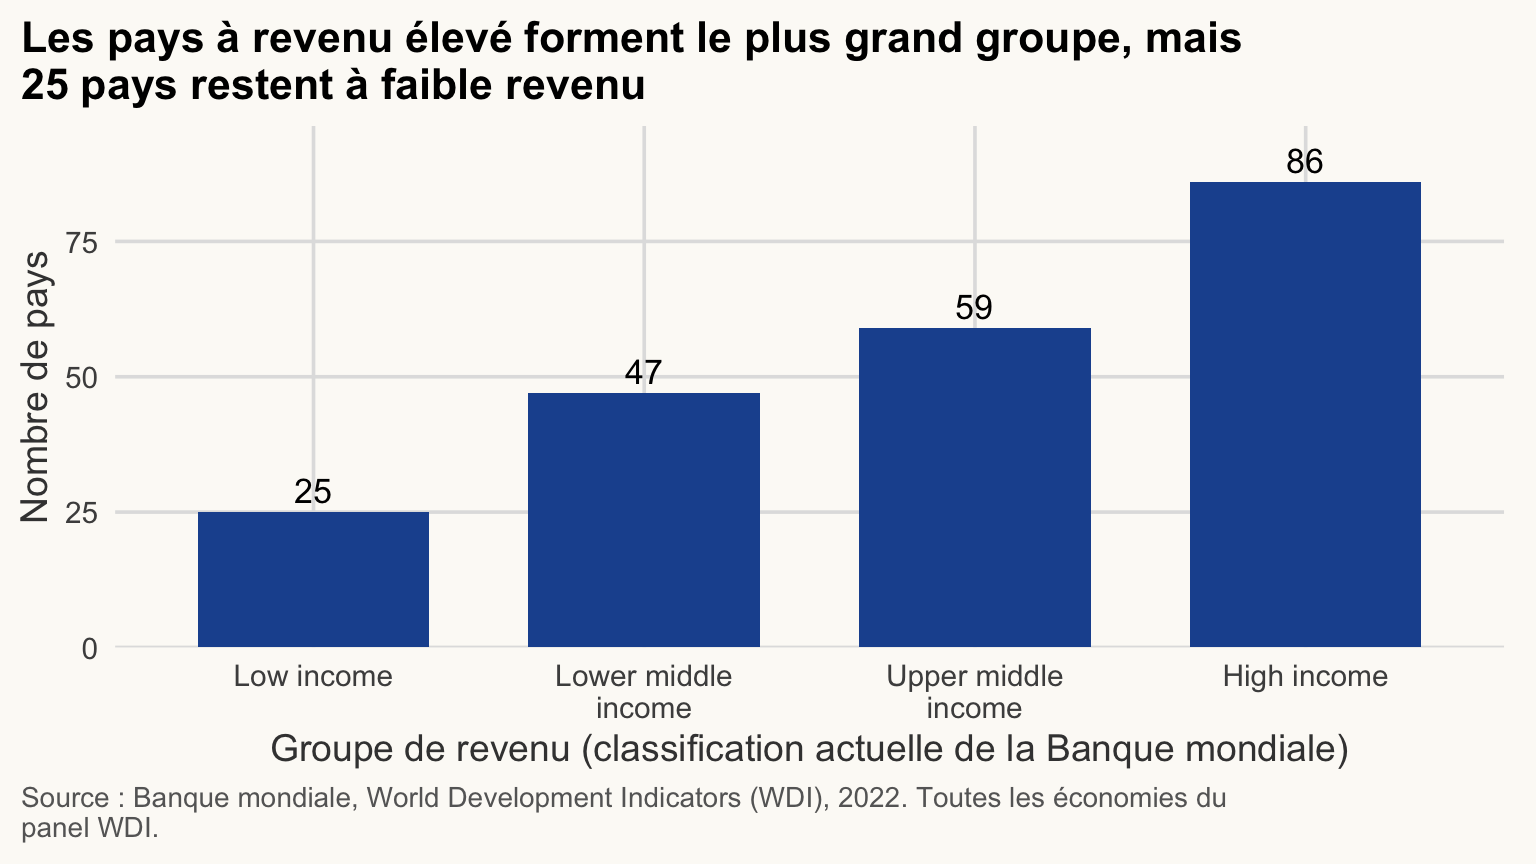
La colonne income est le groupe de revenu (classification actuelle de la Banque mondiale) : le groupe de chaque pays aujourd’hui, appliqué à toutes les années (voir la séance 4). La Banque mondiale fixe ces groupes à partir du revenu national brut par habitant (méthode Atlas, en dollars courants), et non du PIB par habitant en PPA que nous traçons.
Les groupes de revenu ont un ordre naturel (du plus faible au plus élevé), donc nous transformons la colonne en facteur ordonné à la main. L’ordre alphabétique placerait « High income » en premier.
niveaux <- c("Low income", "Lower middle income", "Upper middle income", "High income")

wdi_2022 |>
  mutate(income = factor(income, levels = niveaux, ordered = TRUE)) |>
  ggplot(aes(x = income)) +
  geom_bar(fill = pal_cours[["principal"]], width = 0.7) +
  geom_text(aes(label = after_stat(count)), stat = "count", vjust = -0.4, size = 4.5) +
  scale_x_discrete(labels = label_wrap(14)) +
  scale_y_continuous(expand = expansion(mult = c(0, 0.12))) +
  labs(
    title = str_wrap("Les pays à revenu élevé forment le plus grand groupe, mais 25 pays restent à faible revenu", 60),
    x = "Groupe de revenu (classification actuelle de la Banque mondiale)",
    y = "Nombre de pays",
    caption = str_wrap("Source : Banque mondiale, World Development Indicators (WDI), 2022. Toutes les économies du panel WDI.", 95)
  )
AstuceExercice 5.3
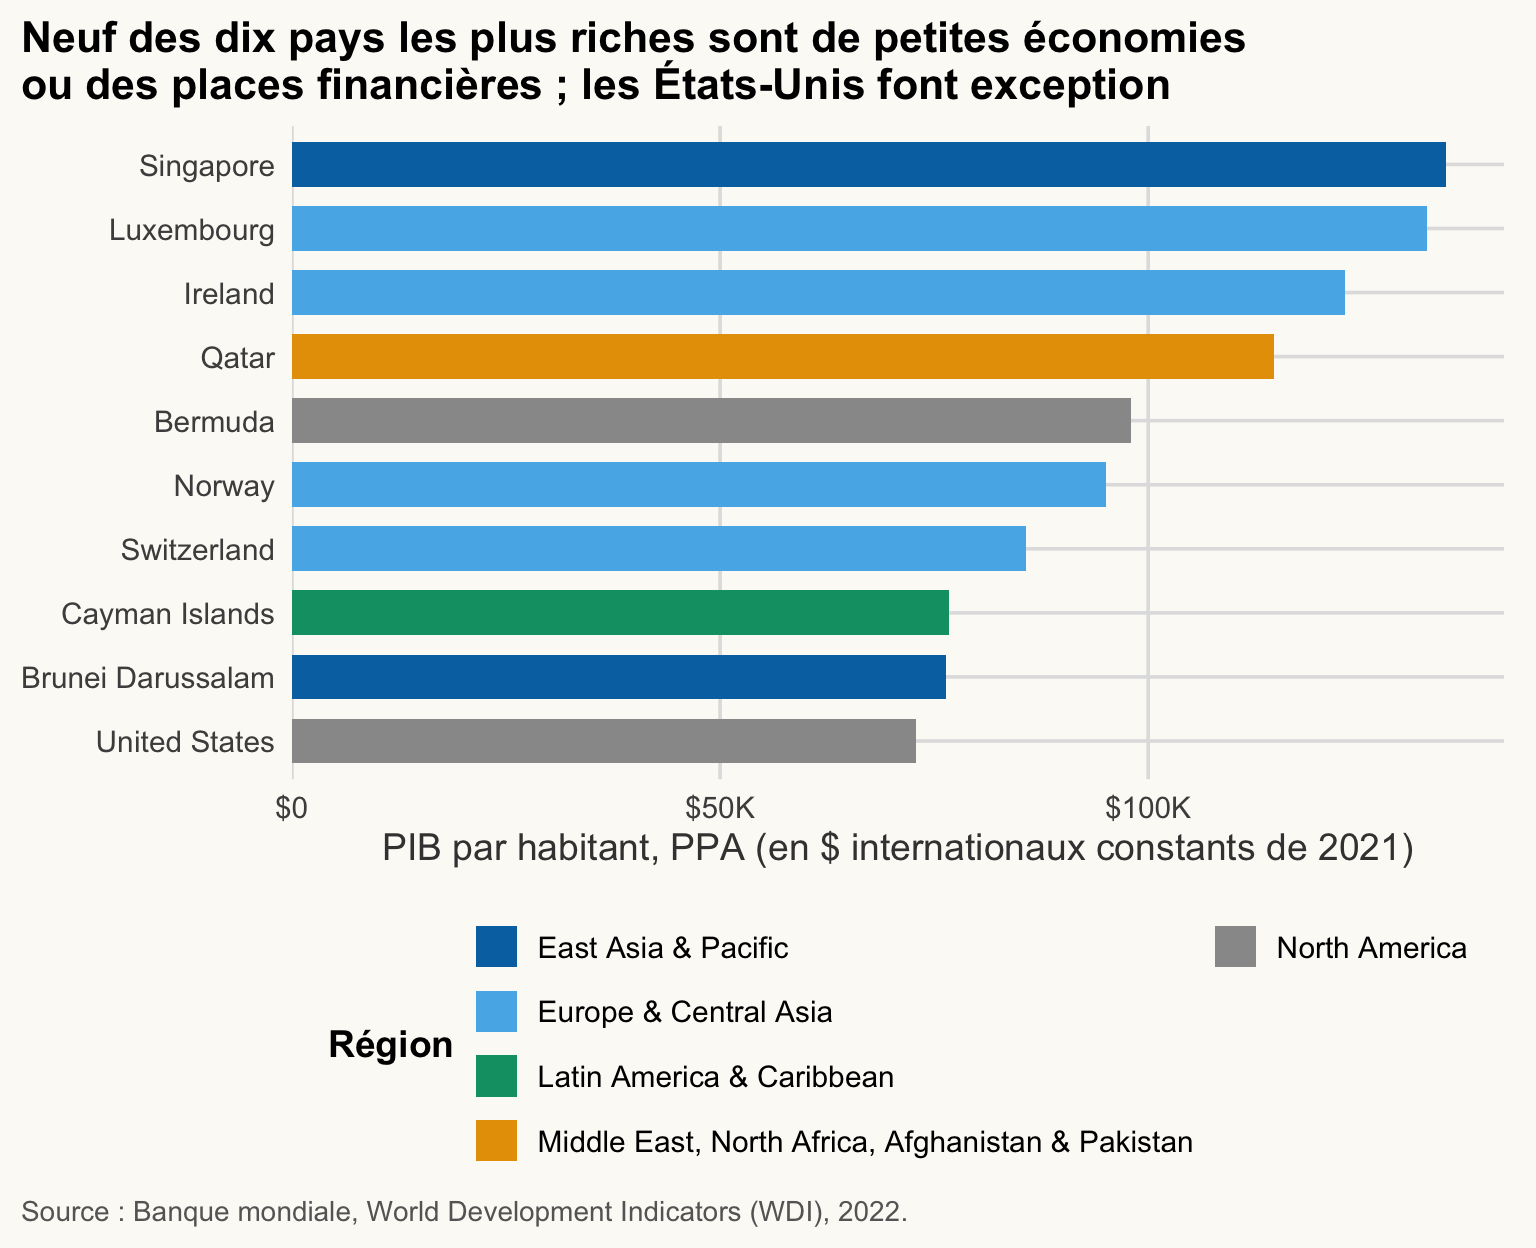
Montrez les dix pays les plus riches en 2022 (PIB par habitant, PPA) sous forme de barres horizontales triées. Utilisez slice_max(), pas top_n() (supplanté). Colorez les barres selon la région avec pal_regions.
NoteAfficher la solution
wdi_2022_ok |>
  slice_max(gdp_pc_ppp, n = 10) |>
  mutate(country = fct_reorder(country, gdp_pc_ppp)) |>
  ggplot(aes(x = gdp_pc_ppp, y = country, fill = region)) +
  geom_col(width = 0.7) +
  scale_x_continuous(labels = label_dollar(scale_cut = cut_short_scale()), expand = expansion(mult = c(0, 0.05))) +
  scale_fill_manual(values = pal_regions) +
  guides(fill = guide_legend(nrow = 4)) +
  labs(
    title = str_wrap("Neuf des dix pays les plus riches sont de petites économies ou des places financières ; les États-Unis font exception", 60),
    x = "PIB par habitant, PPA (en $ internationaux constants de 2021)",
    y = NULL, fill = "Région",
    caption = str_wrap("Source : Banque mondiale, World Development Indicators (WDI), 2022.", 95)
  )
Distributions
≈ 25 min Après cette section, vous saurez montrer comment une variable se répartit entre les pays, globalement et par groupe.
Pour voir comment une variable se répartit entre les pays, utilisez une observation par pays : wdi_2022_ok. (Empiler toutes les années compterait chaque pays 24 fois, et les observations ne seraient pas indépendantes.)
Histogramme et densité
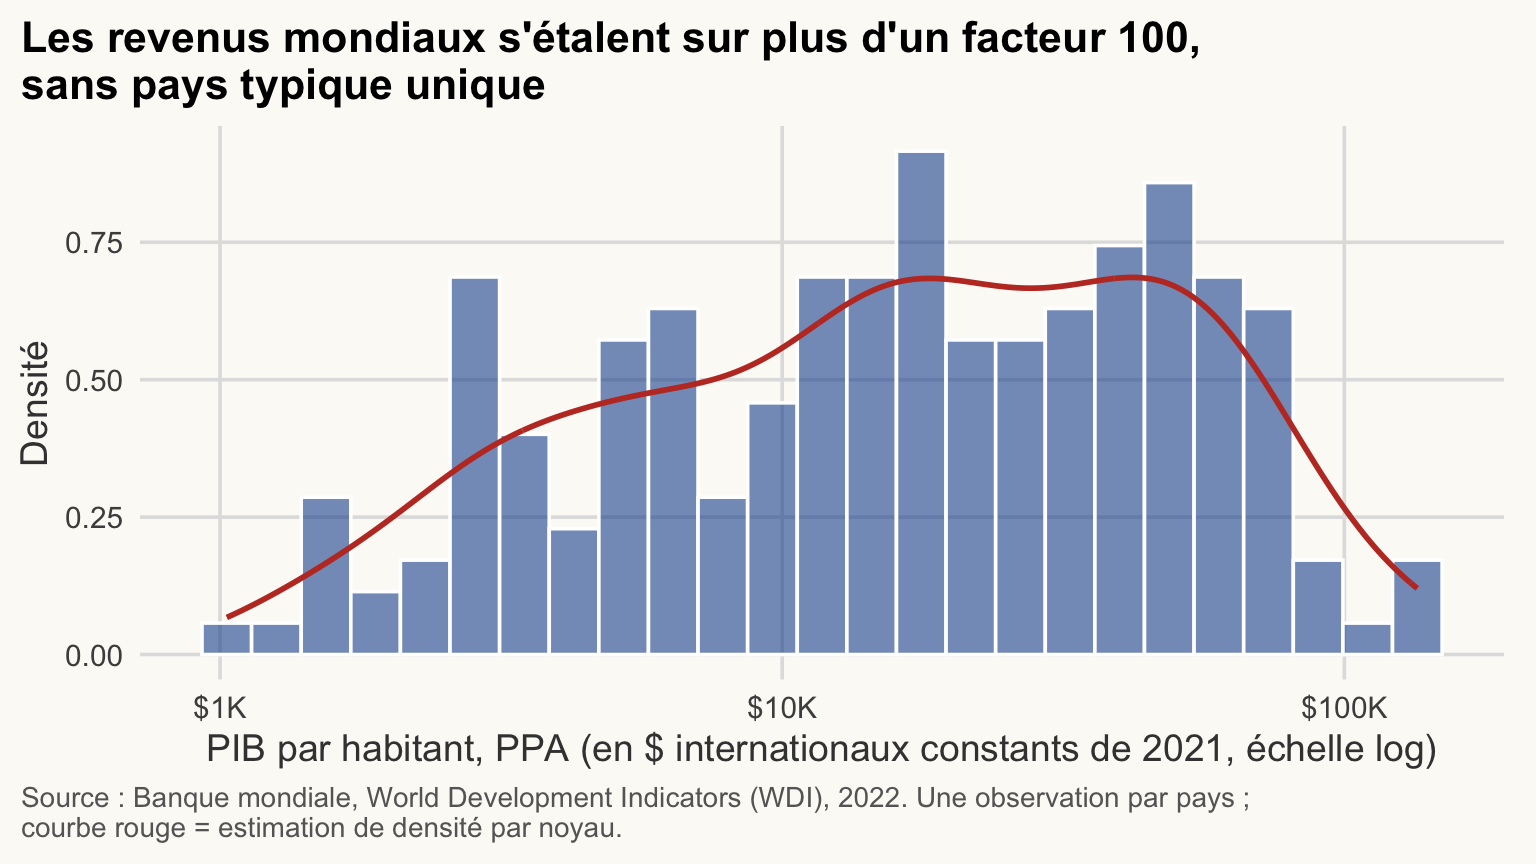
Le PIB par habitant est très asymétrique à droite, donc nous travaillons sur une échelle logarithmique. Nous choisissons la largeur des classes sur cette échelle (ici bins = 25) et comparons quelques valeurs : trop peu de classes masquent la structure, trop de classes montrent du bruit. Placer l’histogramme sur l’échelle de la densité nous permet de superposer une courbe de densité lissée.
ggplot(wdi_2022_ok, aes(x = gdp_pc_ppp)) +
  geom_histogram(aes(y = after_stat(density)), bins = 25,
                 fill = pal_cours[["principal"]], alpha = 0.6, colour = "white") +
  geom_density(colour = pal_cours[["accent"]], linewidth = 1) +
  scale_x_log10(labels = label_dollar(scale_cut = cut_short_scale())) +
  labs(
    title = str_wrap("Les revenus mondiaux s'étalent sur plus d'un facteur 100, sans pays typique unique", 60),
    x = "PIB par habitant, PPA (en $ internationaux constants de 2021, échelle log)",
    y = "Densité",
    caption = str_wrap("Source : Banque mondiale, World Development Indicators (WDI), 2022. Une observation par pays ; courbe rouge = estimation de densité par noyau.", 95)
  )
NoteComment lire ce graphique
- Chaque barre compte les pays dans une tranche de l’axe de revenu (logarithmique) : les barres hautes correspondent aux revenus courants.
- La ligne de densité rouge lisse les barres. Deux bosses signaleraient deux groupes de pays ; ici la masse est étalée sur un large intervalle.
- Comme l’axe est logarithmique, une même largeur signifie un même écart en pourcentage, pas un même écart en dollars.
AvertissementErreur fréquente
Échelle linéaire sur des données asymétriques. Sur un axe linéaire, quelques pays riches étirent l’étendue et presque tous les autres s’entassent à gauche. Essayez scale_x_log10() pour les revenus, les populations et toute quantité qui s’étale sur plusieurs ordres de grandeur, et précisez dans le titre de l’axe qu’il s’agit d’une échelle logarithmique.
Boxplot par groupe
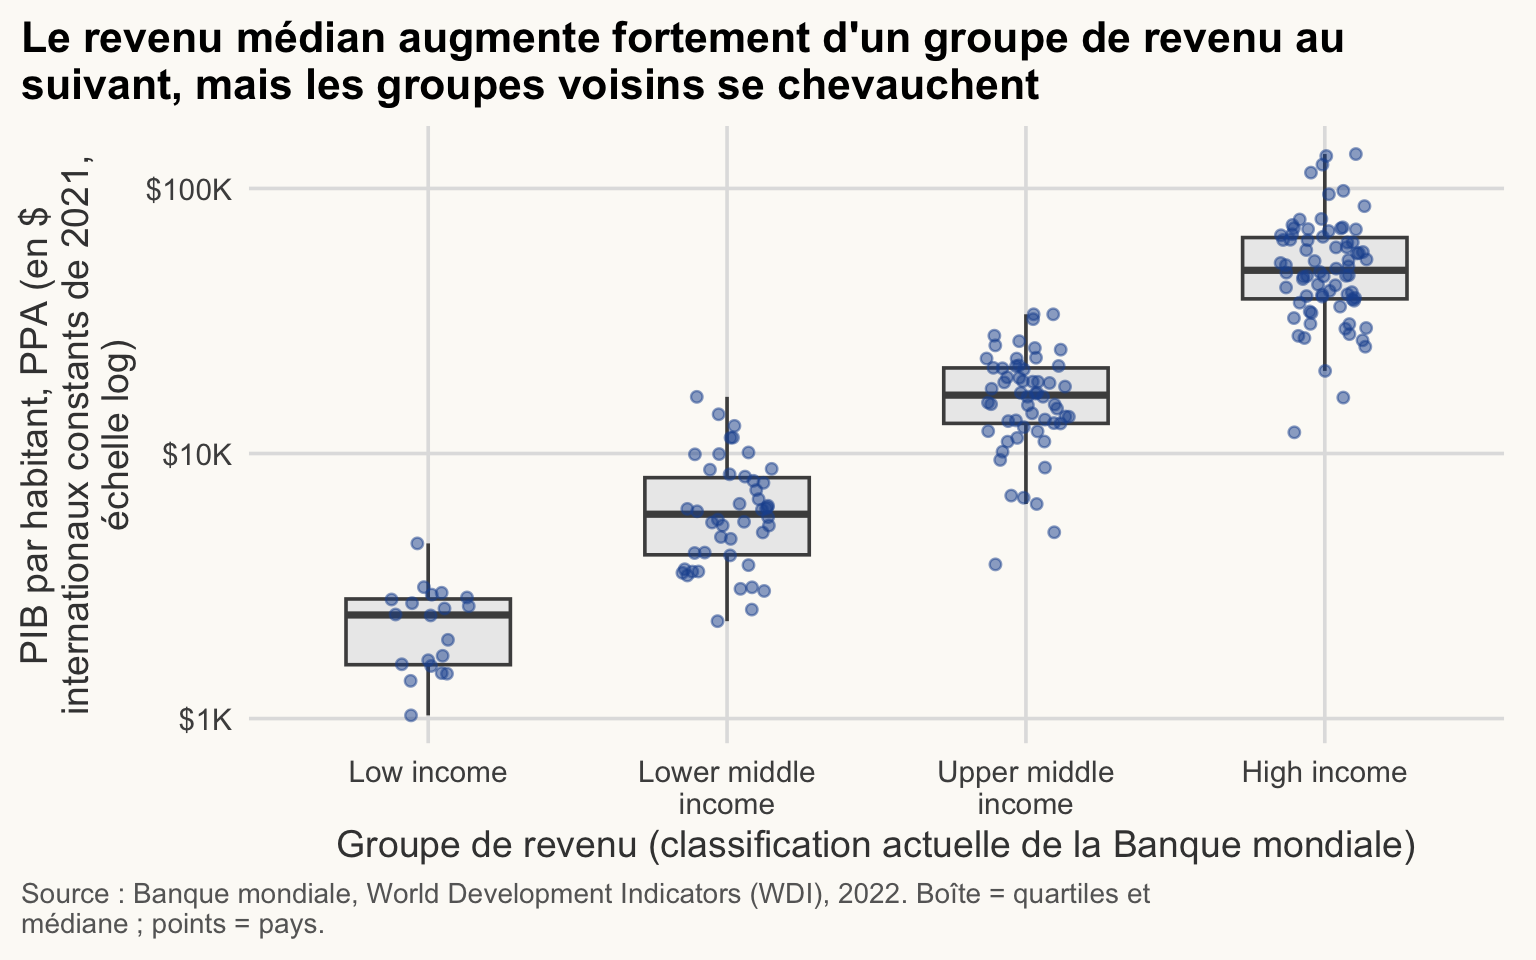
Un boxplot montre la médiane (trait), la moitié centrale des observations (boîte) et les valeurs inhabituelles (points). Ajoutez les pays individuels avec un léger jitter (décalage aléatoire), pour que le lecteur voie combien d’observations se cachent derrière chaque boîte.
wdi_2022_ok |>
  mutate(income = factor(income, levels = niveaux, ordered = TRUE)) |>
  ggplot(aes(x = income, y = gdp_pc_ppp)) +
  geom_boxplot(outliers = FALSE, fill = "grey92", colour = "grey30", width = 0.55) +
  geom_jitter(width = 0.15, alpha = 0.5, colour = pal_cours[["principal"]], size = 1.6) +
  scale_x_discrete(labels = label_wrap(14)) +
  scale_y_log10(labels = label_dollar(scale_cut = cut_short_scale())) +
  labs(
    title = str_wrap("Le revenu médian augmente fortement d'un groupe de revenu au suivant, mais les groupes voisins se chevauchent", 60),
    x = "Groupe de revenu (classification actuelle de la Banque mondiale)",
    y = str_wrap("PIB par habitant, PPA (en $ internationaux constants de 2021, échelle log)", 40),
    caption = str_wrap("Source : Banque mondiale, World Development Indicators (WDI), 2022. Boîte = quartiles et médiane ; points = pays.", 95)
  )
AvertissementErreur fréquente
Trop de couleurs. Colorer selon 7 régions, plus un dégradé, plus la taille donne un graphique que personne ne sait décoder. Utilisez la couleur pour une seule idée ; du gris pour le reste. Si vous avez besoin de plus d’environ 6 couleurs, utilisez des facettes ou mettez en valeur un élément.
Pourquoi outliers = FALSE ? Sinon le boxplot dessine les valeurs aberrantes et le jitter les dessine une seconde fois.
Les groupes se chevauchent parce qu’ils ne sont pas définis sur cet axe : la Banque mondiale classe les pays selon le revenu national brut par habitant, et non le PIB par habitant en PPA, et income contient le groupe actuel, pas celui de 2022. Le pays à faible revenu le plus riche (4 579 $) est plus riche que le pays à revenu intermédiaire supérieur le plus pauvre (3 816 $).
AstuceExercice 5.4
Comparez la distribution de l’espérance de vie en 2000 et en 2022. Utilisez facet_wrap(~ year) sur un histogramme de l’espérance de vie (une observation par pays). Qu’est-il arrivé à la queue gauche ?
NoteAfficher la solution
wdi |>
  filter(year %in% c(2000, 2022)) |>
  drop_na(life_exp) |>
  ggplot(aes(x = life_exp)) +
  geom_histogram(binwidth = 2.5, fill = pal_cours[["principal"]], colour = "white") +
  facet_wrap(~ year) +
  labs(
    title = str_wrap("La queue des faibles espérances de vie s'est réduite entre 2000 et 2022", 60),
    x = "Espérance de vie à la naissance (ans)",
    y = "Nombre de pays",
    caption = str_wrap("Source : Banque mondiale, World Development Indicators (WDI), 2000 et 2022. Une observation par pays et par année.", 95)
  )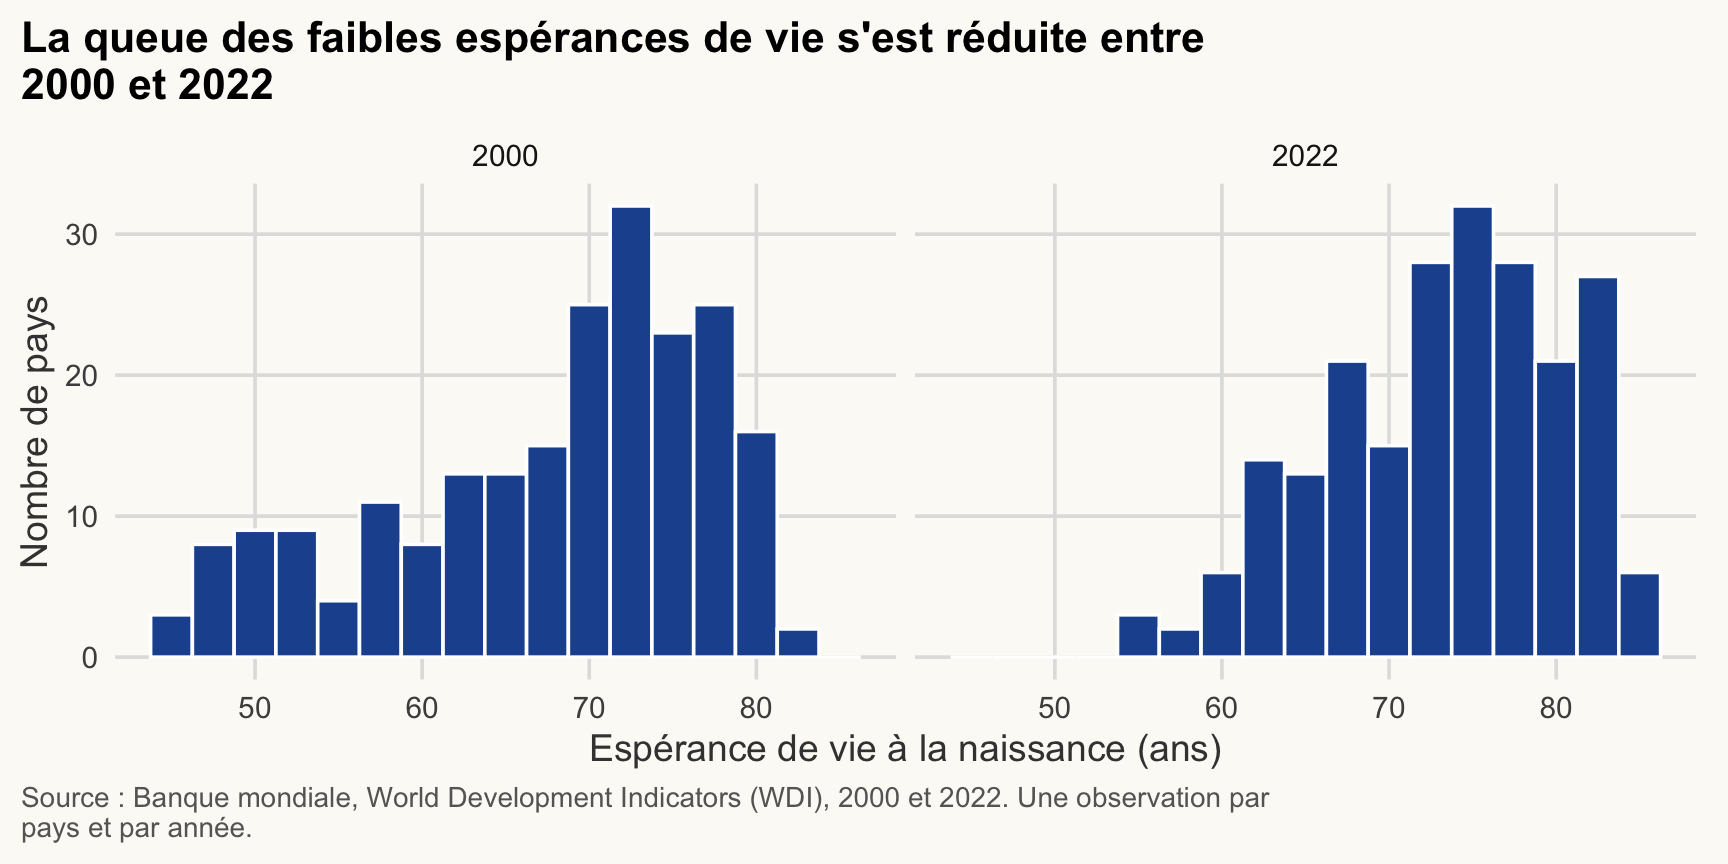
En 2000, 30 pays avaient une espérance de vie inférieure à 55 ans ; en 2022, seuls 3 pays sont dans ce cas (la série de la République centrafricaine est exclue, voir le début de cette page). Toute la distribution s’est décalée vers la droite.
Cartes
≈ 40 min Après cette section, vous saurez dessiner une carte choroplèthe du monde, la joindre sans risque aux données WDI et vérifier ce qui n’a pas été apparié.
Carte choroplèthe : une carte où chaque zone est coloriée selon une valeur. sf (simple features) : le format R qui stocke les formes dans une colonne geometry d’un data frame.
flowchart LR
  A[Formes : Natural Earth] --> C[left_join sur le code iso]
  B[Données : WDI 2022] --> C
  C --> D[vérification anti_join]
  D --> E[classes de valeurs]
  E --> F[geom_sf + projection]
Une carte choroplèthe colorie des zones selon une valeur. Une bonne carte demande quatre choses : toutes les géométries, une jointure sûre, une échelle lisible et une projection honnête. Une erreur fréquente est de ne colorier que quelques pays, parce que la jointure a été faite sur les noms de pays et n’a conservé que les lignes appariées.
1. Géométries : une ligne par pays, dans un tableau sf
sf (« simple features ») stocke la forme de chaque pays dans une colonne geometry. Le résultat se comporte comme un data frame : les verbes de dplyr fonctionnent dessus.
world <- ne_countries(scale = "medium", returnclass = "sf") |>
  filter(name != "Antarctica")          # pas de données là-bas, et il mange un cinquième de la carte

dim(world)
[1] 241 169world |>
st_drop_geometry() |>
select(name, iso_a3, iso_a3_eh, adm0_a3) |>
slice(1:5) name iso_a3 iso_a3_eh adm0_a3
1 Zimbabwe ZWE ZWE ZWE
2 Zambia ZMB ZMB ZMB
3 Yemen YEM YEM YEM
4 Vietnam VNM VNM VNM
5 Venezuela VEN VEN VENNatural Earth propose plusieurs codes de type ISO. Lequel correspond à l’iso3c de WDI ? Ne devinez pas : testez avec anti_join(), qui conserve les lignes du tableau de gauche sans correspondance.
# Pays WDI sans correspondance dans la carte, pour chaque code candidat
unmatched <- function(code) {
  wdi_2022 |>
    anti_join(st_drop_geometry(world), by = c("iso3c" = code)) |>
    pull(country)
}

# Combien d'économies WDI restent sans correspondance avec chaque code ?
length(unmatched("iso_a3"))
[1] 5length(unmatched("iso_a3_eh"))[1] 3length(unmatched("adm0_a3"))[1] 5unmatched("iso_a3_eh")[1] "Channel Islands" "Gibraltar" "Kosovo" iso_a3_eh est la meilleure clé : seules quelques économies WDI manquent sur la carte. Ce sont de petits territoires ou des territoires disputés (îles Anglo-Normandes, Gibraltar, Kosovo, qui a un code non standard dans Natural Earth). La vérification inverse montre les zones de la carte sans données WDI :
world |>
  st_drop_geometry() |>
  anti_join(wdi_2022, by = c("iso_a3_eh" = "iso3c")) |>
  select(name, iso_a3_eh) |>
  head(8)
name iso_a3_eh
1 Vatican VAT
2 S. Geo. and the Is. SGS
3 Br. Indian Ocean Ter. IOT
4 Saint Helena SHN
5 Pitcairn Is. PCN
6 Anguilla AIA
7 Falkland Is. FLK
8 Montserrat MSR
NotePourquoi c’est important en économie du développement
Ici, les pertes sont faibles : trois petits territoires ou territoires disputés côté WDI, et surtout de très petits territoires sans données WDI côté carte. C’est parce que nous joignons sur les codes. Une jointure sur les noms de pays laisserait environ 50 économies WDI sans forme, dont la République démocratique du Congo, le Yémen et la Côte d’Ivoire, et la carte les montrerait « sans données » sans aucun avertissement. Vérifier la jointure fait partie d’une mesure honnête du développement.
Ne joignez jamais sur les noms de pays : « Russian Federation » (WDI) est « Russia » (Natural Earth), « Egypt, Arab Rep. » est « Egypt ». Les codes sont bien plus stables que les noms, mais ils changent parfois (ROM est devenu ROU, ZAR est devenu COD) : faites quand même un anti_join().
2. Joindre et tracer
Nous partons de la carte (left_join(world, data)) pour que chaque pays garde sa forme, même sans données. Ceux-là reçoivent NA et seront dessinés en gris clair.
world_gdp <- world |>
  select(iso_a3_eh, geometry) |>
  left_join(select(wdi_2022, iso3c, country, gdp_pc_ppp, elec_access),
            by = c("iso_a3_eh" = "iso3c"))

sum(is.na(world_gdp$gdp_pc_ppp))   # formes dessinées en gris (pas de données)
[1] 41Le PIB par habitant est asymétrique : une échelle de couleur continue ferait paraître presque tout pareil. Nous regroupons donc les valeurs en classes, avec des bornes rondes et des étiquettes lisibles.
cuts   <- c(0, 2500, 5000, 10000, 20000, 40000, Inf)
labs_g <- c("< $2,500", "$2,500-5,000", "$5,000-10,000", "$10,000-20,000",
            "$20,000-40,000", "> $40,000")

world_gdp |>
  mutate(gdp_class = cut(gdp_pc_ppp, breaks = cuts, labels = labs_g, right = FALSE)) |>
  ggplot() +
  geom_sf(aes(fill = fct_na_value_to_level(gdp_class, "Pas de données")),   # NA devient un niveau
          colour = "white", linewidth = 0.1) +
  scale_fill_manual(values = c(hcl.colors(6, "YlGnBu", rev = TRUE), "grey85"),  # une couleur par niveau, dans l'ordre
                    drop = FALSE) +
  coord_sf(crs = "+proj=robin") +
  guides(fill = guide_legend(nrow = 2, title.position = "top")) +
  labs(
    x = NULL, y = NULL,
    title = str_wrap("Le revenu par habitant est le plus élevé au Nord et le plus bas en Afrique subsaharienne", 60),
    fill = "PIB par habitant, PPA (en $ internationaux constants de 2021)",
    caption = str_wrap("Source : Banque mondiale, World Development Indicators (WDI), 2022. Gris clair : pas de données.", 95)
  ) +
  theme(axis.text = element_blank(), panel.grid.major = element_line(colour = "grey94"))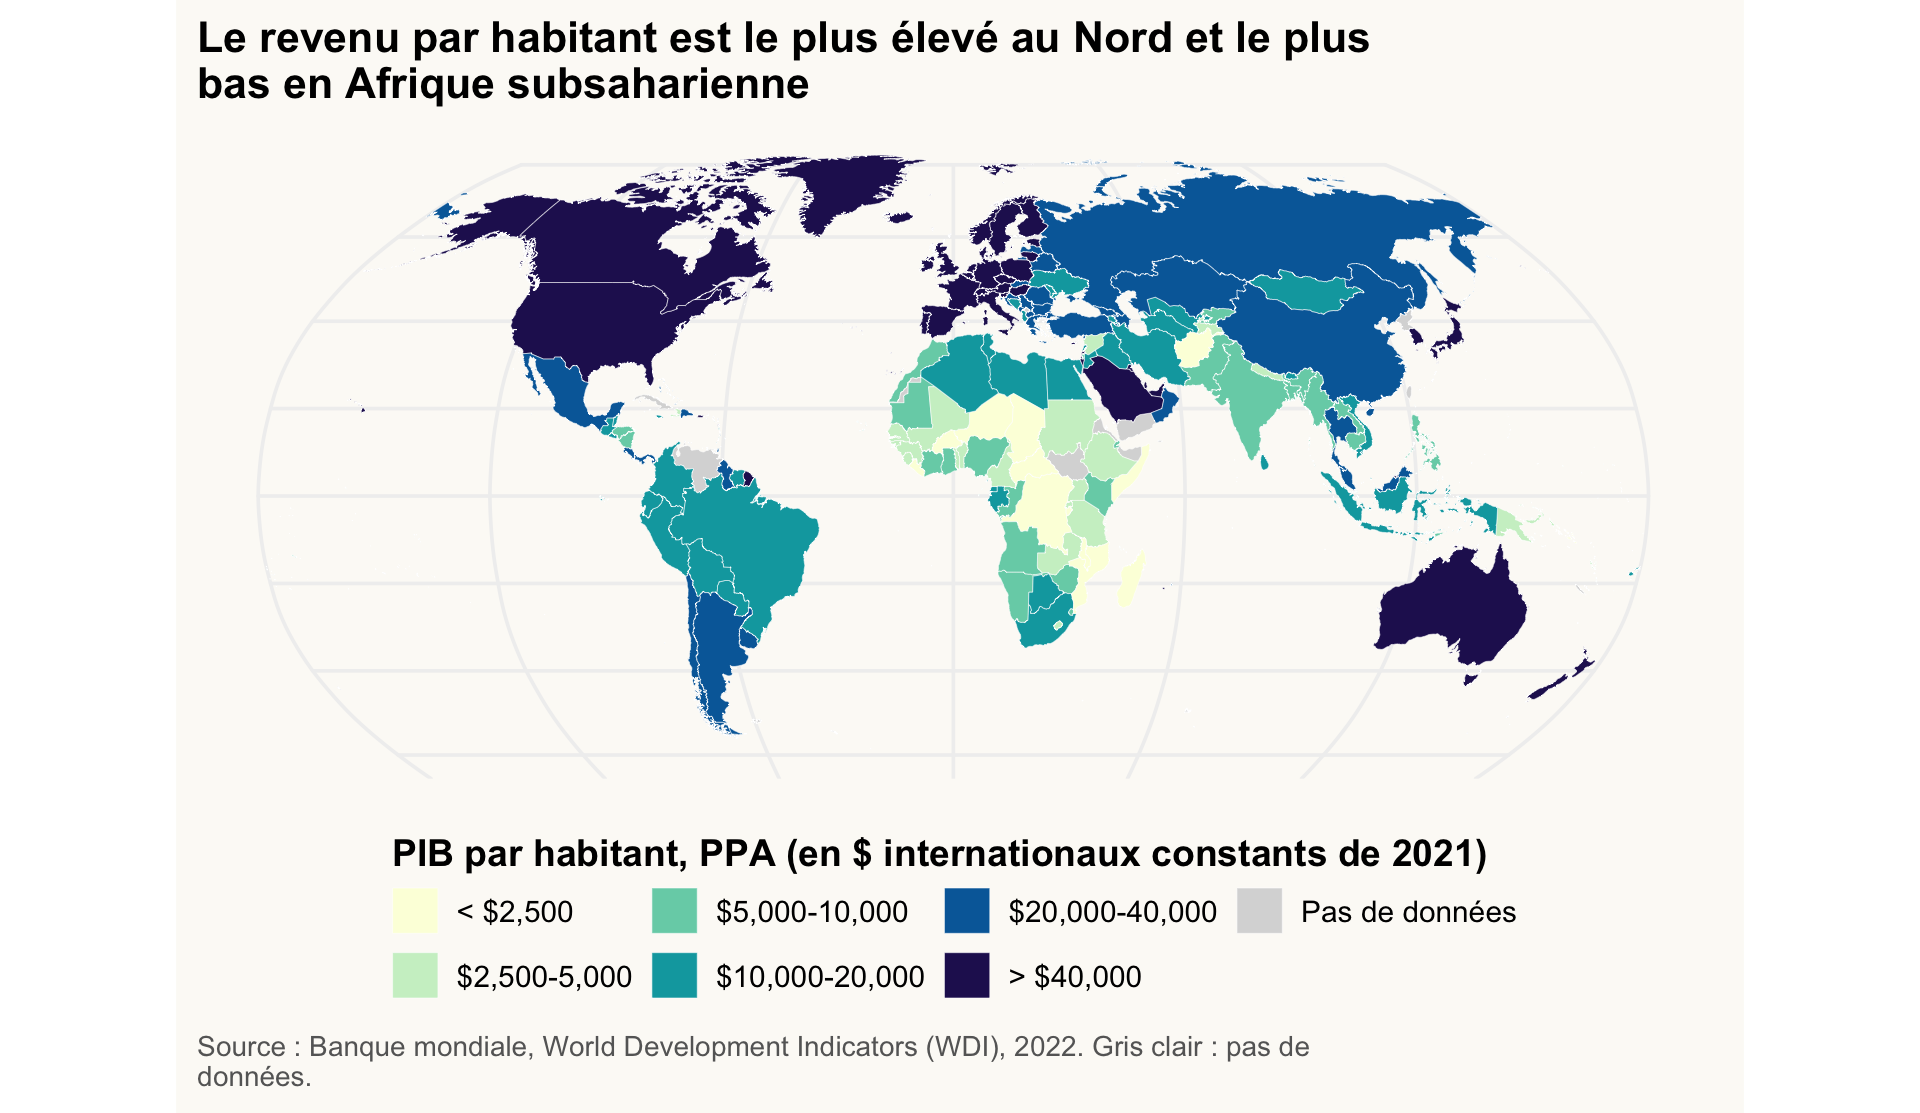
Ce qui rend cette carte honnête :
-
Tous les pays sont dessinés. Les données manquantes ont leur propre niveau, « Pas de données », en gris clair :
fct_na_value_to_level()transformeNAen un vrai niveau de facteur, le dernier, de sorte qu’il apparaisse dans la légende.scale_fill_manual()donne ensuite une couleur par niveau, dans l’ordre des niveaux (drop = FALSEconserve tous les niveaux, même vides, pour que les couleurs ne puissent pas se décaler). -
Échelle par classes avec des bornes rondes et des étiquettes écrites en dollars, pas en
1e+04. -
coord_sf(crs = "+proj=robin"): projection de Robinson, un compromis qui déforme moins les aires que le rectangle longitude/latitude par défaut. Une chaîne comme"+proj=robin"est une définition PROJ ;"EPSG:4326"donnerait de la simple latitude/longitude. - L’aire n’est pas la population : la Russie et le Canada paraissent grands, l’Inde petite. Une carte choroplèthe d’une variable intensive (par habitant) est juste ; une carte de totaux induirait en erreur.
AstuceExercice 5.5
Cartographiez l’accès à l’électricité (% de la population) en 2022 pour tous les pays, en classes (par exemple moins de 50 %, 50-80 %, 80-99 %, 99-100 %).
Facultatif : pour aller plus loin. Puis annotez les trois pays où l’accès est le plus faible, avec leur nom et leur valeur. Indice : utilisez slice_min() pour les trouver et st_point_on_surface() pour obtenir une position d’étiquette à l’intérieur de chaque pays. (Nous prenons les plus faibles, pas les plus élevés : plus de 100 pays sont à 100 %, donc un « top 3 » serait une égalité arbitraire.)
NoteAfficher la solution
bottom3 <- world_gdp |>
  drop_na(elec_access) |>
  slice_min(elec_access, n = 3, with_ties = FALSE) |>
  mutate(label = paste0(str_remove(country, ",.*"), " ", round(elec_access), "%")) |>
  st_point_on_surface()                       # un point à l'intérieur de chaque polygone

bottom3$label                                  # vérifier quels pays sont annotés
[1] "South Sudan 8%" "Burundi 10%" "Chad 12%" world_gdp |>
mutate(elec_class = cut(elec_access, breaks = c(0, 50, 80, 99, 100.01),
labels = c("< 50%", "50-80%", "80-99%", "99-100%"),
right = FALSE)) |>
ggplot() +
geom_sf(aes(fill = fct_na_value_to_level(elec_class, "Pas de données")),
colour = "white", linewidth = 0.1) +
geom_label_repel(data = bottom3, aes(label = label, geometry = geometry),
stat = "sf_coordinates", size = 3.4, fill = alpha("white", 0.85),
min.segment.length = Inf, box.padding = 0.2, seed = 1) + # pas de traits de repère
scale_fill_manual(values = c("#08306b", "#2171b5", "#9ecae1", "#eff3ff", "grey85"), # dans l'ordre des niveaux
drop = FALSE) +
coord_sf(crs = "+proj=robin") +
guides(fill = guide_legend(nrow = 2, title.position = "top")) +
labs(
x = NULL, y = NULL,
title = str_wrap("20 des 22 pays où moins de la moitié de la population a l'électricité sont en Afrique subsaharienne", 60),
fill = "Population ayant accès à l'électricité",
caption = str_wrap("Source : Banque mondiale, World Development Indicators (WDI), 2022. Étiquettes (placées près des pays) : les trois pays au plus faible accès. Gris clair : pas de données.", 95)
) +
theme(axis.text = element_blank(), panel.grid.major = element_line(colour = "grey94"))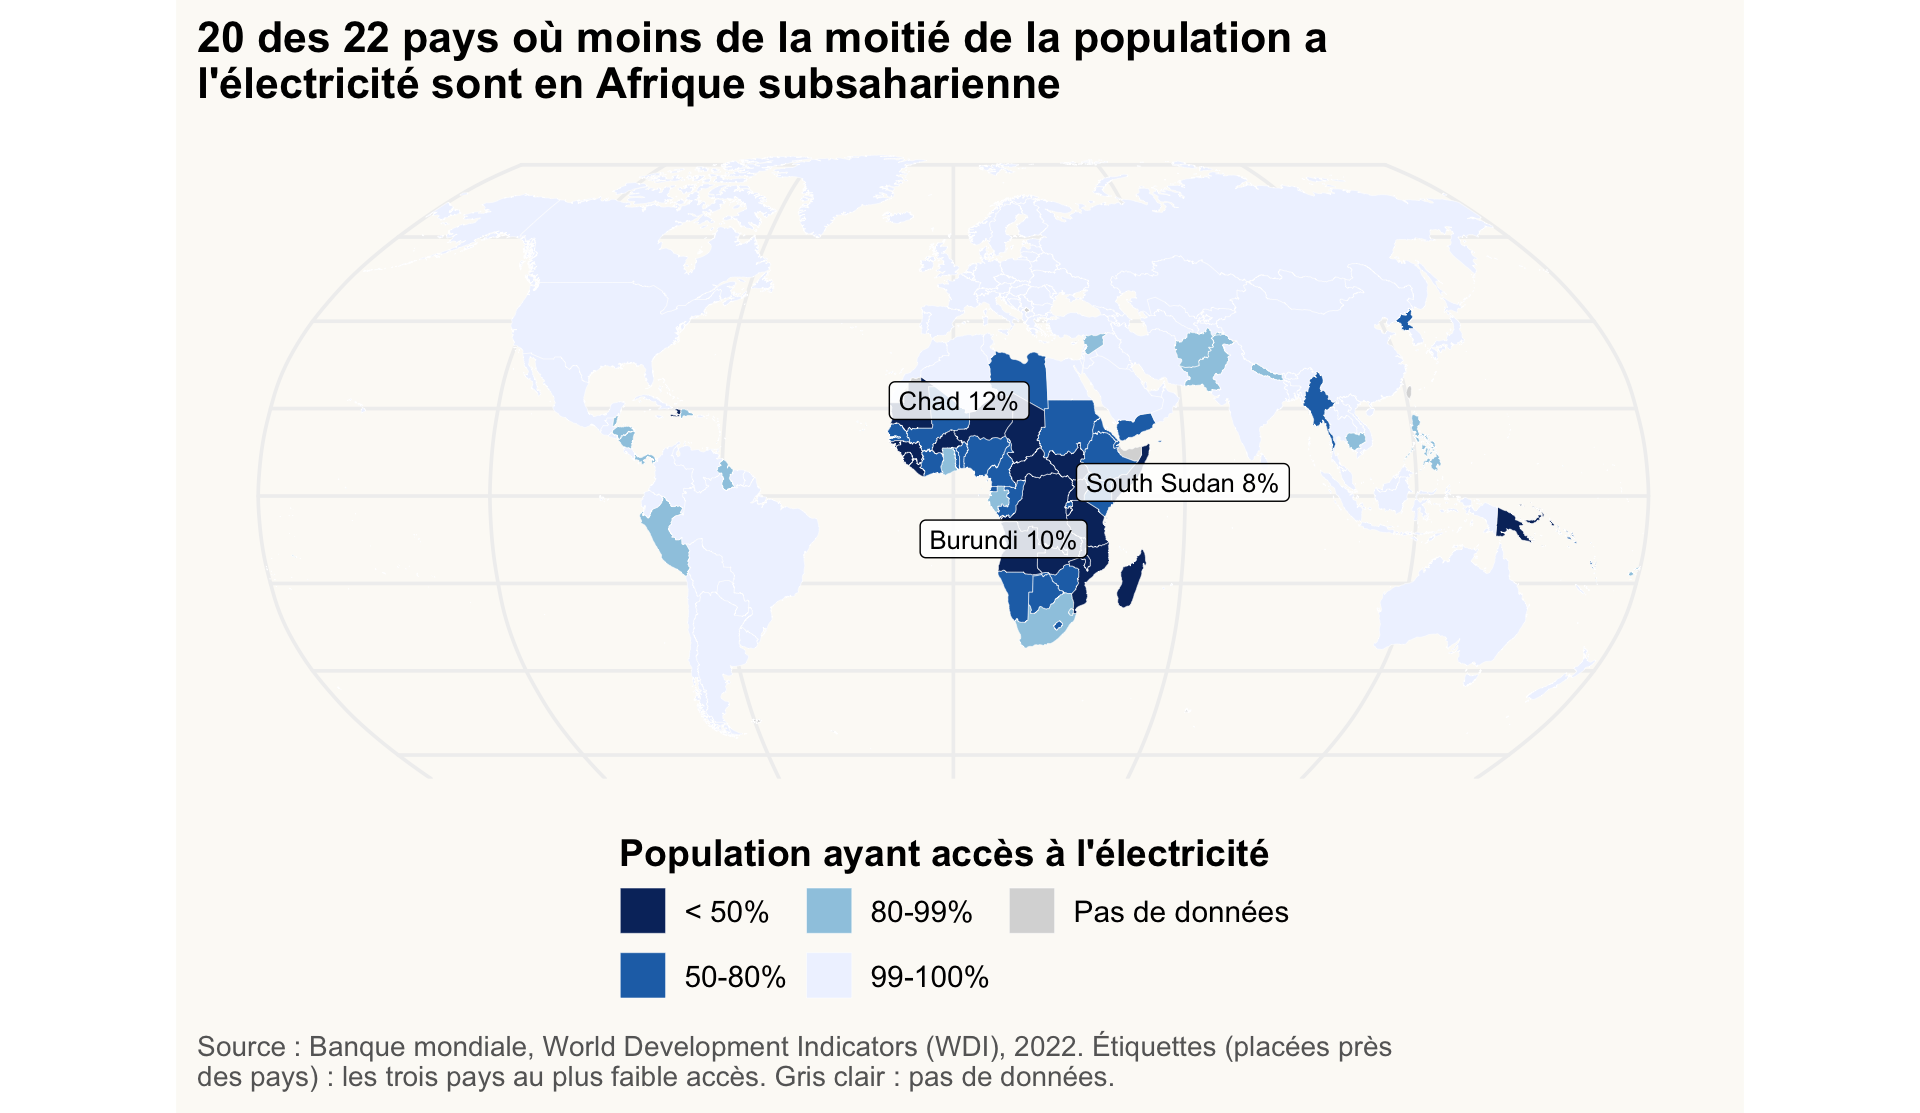
Enregistrer les figures
≈ 10 min Après cette section, vous saurez exporter une figure avec une taille et une résolution fixes.
Dans un rapport, la figure à l’écran n’est pas la figure du fichier. Enregistrez avec une taille et une résolution explicites pour que le résultat soit identique sur tous les ordinateurs. Stockez le graphique dans un objet, puis appelez ggsave().
dir.create(here("output"), showWarnings = FALSE)   # output/ est créé s'il manque

p_gapminder <- ggplot(wdi_2022_ok, aes(x = gdp_pc_ppp, y = life_exp, colour = region)) +
  geom_point() +
  scale_x_log10(labels = label_dollar(scale_cut = cut_short_scale()))

ggsave(here("output", "gapminder.png"), plot = p_gapminder,
       width = 8, height = 5, units = "in", dpi = 300)    # pour Word / diapositives
ggsave(here("output", "gapminder.pdf"), plot = p_gapminder,
width = 8, height = 5) # vectoriel, pour LaTeX-
widthetheightsont en pouces (units = "cm"est possible). Choisissez-les pour correspondre à l’emplacement final ; ne redimensionnez pas dans Word. - 300 dpi est le standard pour l’impression ; 150 suffit pour le web.
- Sans
plot =,ggsave()enregistre le dernier graphique affiché, ce qui est fragile dans un script. -
here()construit le chemin à partir de la racine du projet, donc le code fonctionne sur n’importe quelle machine.
ImportantIdée clé
Une figure est un livrable : le message dans le titre, les unités sur les axes, la source en note sous la figure, une taille fixe à l’export. Si le titre ne dit rien, c’est au lecteur de faire votre analyse.
AstuceExercice 5.6 (Facultatif : pour aller plus loin)
Réalisez un boxplot de l’espérance de vie par région (2022, un point par pays), avec les régions triées selon la médiane, à l’horizontale, et enregistrez-le en PNG à 300 dpi dans output/. Le bloc d’enregistrement ne doit pas être évalué lors du rendu de la page.
NoteAfficher la solution
p_life_region <- wdi_2022 |>
  drop_na(life_exp) |>
  mutate(region = fct_reorder(region, life_exp, .fun = median)) |>
  ggplot(aes(x = life_exp, y = region)) +
  geom_boxplot(fill = "grey92", colour = "grey30", width = 0.55) +
  scale_y_discrete(labels = label_wrap(28)) +
  labs(
    title = str_wrap("L'Afrique subsaharienne a l'espérance de vie médiane la plus basse, environ 9 ans sous la région suivante", 60),
    x = "Espérance de vie à la naissance (ans)",
    y = NULL,
    caption = str_wrap("Source : Banque mondiale, World Development Indicators (WDI), 2022. Une observation par pays.", 95)
  )

p_life_region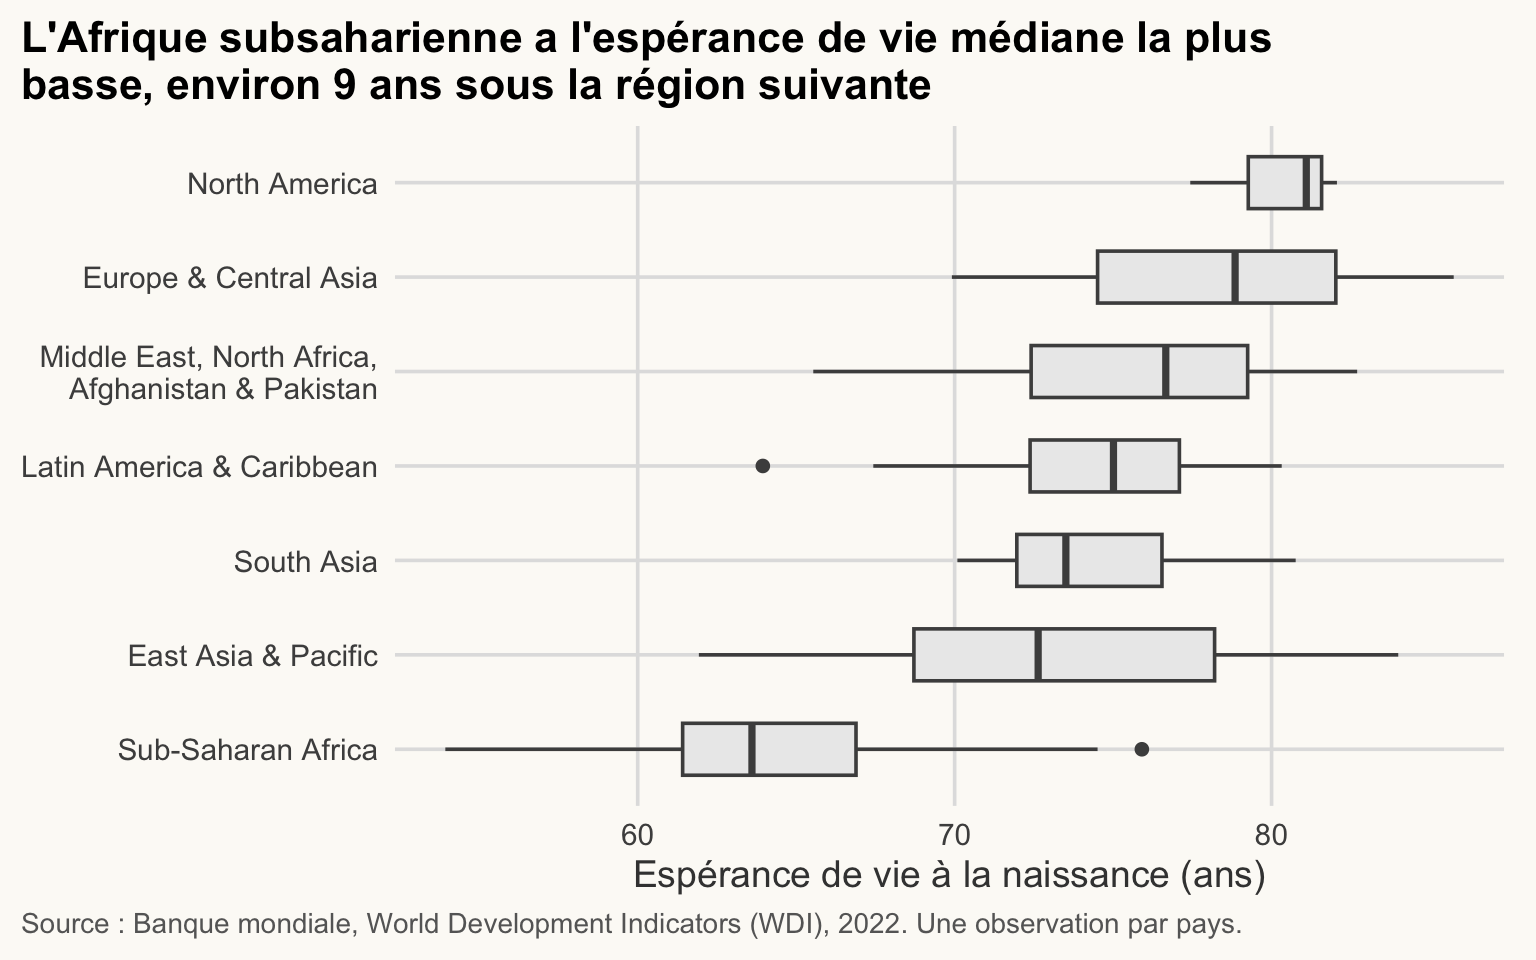
dir.create(here("output"), showWarnings = FALSE)
ggsave(here("output", "life_exp_region.png"), plot = p_life_region,
       width = 8, height = 5, dpi = 300)
À retenir
- Un ggplot est un empilement de couches indépendantes : données, esthétiques, geoms, échelles, libellés, thème. Apprenez la grammaire, pas les recettes.
-
aes()relie des variables ; les arguments en dehors deaes()fixent des constantes. - Les échelles logarithmiques et
scales::label_dollar(scale_cut = cut_short_scale())/label_number()rendent lisibles les données asymétriques du développement. Ne laissez jamais1e+04sur un axe. - Titre = le message ; axes avec unités ; note de source sous la figure. Les étiquettes directes valent mieux que les légendes.
- Mettez en valeur une série en couleur et grisez le reste (signal contre contexte). Triez les barres, faites-les partir de zéro, utilisez
geom_col()pour des valeurs etgeom_bar()pour des effectifs. - Pour les distributions, utilisez une observation par pays ; n’empilez pas les années en les disant indépendantes.
- Cartes : gardez toutes les formes, joignez sur les codes (pas les noms), vérifiez avec
anti_join(), regroupez en classes les valeurs asymétriques, utilisez une projection, du gris pour les données manquantes. - Enregistrez avec
ggsave()et deswidth,height,dpiexplicites.
Prochaine séance : Séance 6 : Visualisation avancée et rapports Quarto.