Sys.setenv(LANGUAGE = "en")
library(tidyverse)
library(here)
library(scales)
library(gt)
library(fixest)
library(modelsummary)

source(here::here("R", "theme_cours.R"))
set.seed(2024) # le seul tirage aléatoire de la page : nuages de points simulésSéance 4 : Statistiques descriptives et régression
Résumer, corréler, régresser et tester : que disent les données sur le revenu et la santé ?
Objectifs de la séance
- Décrire une variable : moyenne, médiane, écart-type, quantiles, écart interquartile, et pourquoi le PIB par habitant s’analyse en logarithmes.
- Construire un tableau de synthèse propre avec
gt. - Calculer et interpréter une corrélation, et savoir ce qu’elle ne peut pas vous dire.
- Estimer et lire une régression simple et une régression multiple (
fixest::feols, erreurs-types robustes,modelsummary). - Comprendre pourquoi empiler les années de quelques pays produit des statistiques trompeuses.
- Facultatif / à la maison : réaliser un test t à deux groupes et interpréter la p-valeur et l’intervalle de confiance.
Préparer votre session R
Packages utilisés aujourd’hui : tidyverse, here, scales, gt, fixest, modelsummary. S’il en manque un : install.packages(c("tidyverse", "here", "scales", "gt", "fixest", "modelsummary")).
Script de la séance : télécharger seance-4.R, tout le code de cette page dans un seul fichier.
Fil rouge : Croissance, santé et inégalités : que disent les données sur les pays en développement ? Aujourd’hui, comment le revenu et l’espérance de vie sont-ils liés entre les pays ?
1. Une année, une ligne par pays
≈ 15 min Après cette section, vous saurez construire un échantillon propre à une ligne par pays et dire combien de pays il contient.
Les séances 1 et 2 utilisaient trois pays. Les statistiques demandent beaucoup d’unités : nous utilisons donc désormais tous les pays. Chaque méthode statistique ci-dessous suppose qu’une ligne = une unité. Nous travaillons donc sur une coupe transversale : une année, une ligne par pays.
Quelle année ? Vérifions la couverture des variables dont nous avons besoin.
wdi <- read_csv(here::here("data", "wdi_panel.csv"), show_col_types = FALSE)

wdi |>
  filter(year %in% c(2000, 2010, 2015, 2019, 2021, 2023)) |>
  group_by(year) |>
  summarise(
    countries       = n(),
    `life exp.`     = sum(!is.na(life_exp)),
    `GDP pc`        = sum(!is.na(gdp_pc_ppp)),
    `both`          = sum(!is.na(life_exp) & !is.na(gdp_pc_ppp)),
    `+ Gini`        = sum(!is.na(life_exp) & !is.na(gdp_pc_ppp) & !is.na(gini)),
    `electricity`   = sum(!is.na(elec_access))
  ) |>
  gt() |>
  tab_header(title = "Nombre de pays avec données non manquantes") |>
tab_source_note("Source : Banque mondiale, World Development Indicators (WDI). Pays uniquement (agrégats exclus).")| Nombre de pays avec données non manquantes | ||||||
| year | countries | life exp. | GDP pc | both | + Gini | electricity |
|---|---|---|---|---|---|---|
| 2000 | 217 | 217 | 192 | 192 | 57 | 211 |
| 2010 | 217 | 217 | 198 | 198 | 86 | 215 |
| 2015 | 217 | 217 | 199 | 199 | 87 | 215 |
| 2019 | 217 | 217 | 199 | 199 | 78 | 215 |
| 2021 | 217 | 217 | 199 | 199 | 81 | 215 |
| 2023 | 217 | 217 | 197 | 197 | 60 | 215 |
| Source : Banque mondiale, World Development Indicators (WDI). Pays uniquement (agrégats exclus). | ||||||
Nous utilisons 2019. C’est la dernière année avant la COVID-19 (qui a réduit l’espérance de vie en 2020-21 et déforme à la fois le revenu et la santé), et la couverture est déjà maximale pour le PIB par habitant et l’espérance de vie. (Les séances 5 et 6 utilisent plutôt 2022 : elles montrent des valeurs récentes, et 2022 est la dernière année bien couverte.) L’indice de Gini est le point faible : il n’est mesuré que dans certains pays chaque année.
Vérifiez d’abord les extrêmes. La plus faible espérance de vie en 2019 est celle de la République centrafricaine (RCA, code CAF), 31,5 ans. Avant de décider quoi que ce soit, regardez toute la série de ce pays :
wdi |> filter(iso3c == "CAF") |> select(year, life_exp) |> print(n = Inf)# A tibble: 24 × 2
year life_exp
<dbl> <dbl>
1 2000 46.6
2 2001 46.7
3 2002 46.8
4 2003 47.3
5 2004 47.7
6 2005 48.2
7 2006 48.7
8 2007 49.3
9 2008 49.9
10 2009 14.7
11 2010 46.9
12 2011 50.1
13 2012 51.3
14 2013 49.5
15 2014 40.3
16 2015 51.9
17 2016 51.0
18 2017 45.2
19 2018 52.3
20 2019 31.5
21 2020 50.6
22 2021 40.3
23 2022 18.8
24 2023 57.4La série fait des bonds : 49,9 ans en 2008 puis 14,7 en 2009, 52,3 en 2018 puis 31,5 en 2019, 18,8 en 2022 puis 57,4 en 2023. Des chutes de 20 à 35 ans suivies d’un rebond immédiat sont des artefacts des données, pas des résultats, et elles reviennent plusieurs années : dans cette version des WDI, aucune année de la série d’espérance de vie de la RCA n’est fiable. On ne modifie jamais le fichier brut : on exclut toute la série de la RCA explicitement et on le dit, et nous ferons de même aux séances 5 et 6. La RCA sort donc de l’échantillon 2019, et le N ci-dessous compte un pays de moins.
# L'espérance de vie de la RCA n'est pas fiable dans cette version des WDI (14,7 en 2009, 18,8 en 2022) : on l'exclut pour toutes les années
wdi <- wdi |> mutate(life_exp = if_else(iso3c == "CAF", NA_real_, life_exp))
cs <- wdi |>
filter(year == 2019, !is.na(life_exp), !is.na(gdp_pc_ppp)) |>
mutate(
income = factor(income, levels = c("Low income", "Lower middle income",
"Upper middle income", "High income")),
log_gdp_pc = log(gdp_pc_ppp)
)
n_cs <- nrow(cs)
n_cs[1] 198Notre échantillon de travail compte 198 pays. Indiquez toujours N.
ImportantIdée clé
Toutes les méthodes de cette séance supposent qu’une ligne = une unité. Ici, l’unité est un pays en 2019. Avant toute statistique, sachez ce que représente une ligne et combien vous en avez.
2. Décrire une variable
Centre et dispersion
≈ 40 min, dont l’exercice 4.1 Après cette section, vous saurez résumer une variable avec la bonne statistique et expliquer pourquoi le PIB par habitant est analysé en logarithmes.
Les principaux résumés d’une variable \(x_1, \dots, x_N\) :
- la moyenne \(\bar{x} = \frac{1}{N}\sum_i x_i\) : sensible aux valeurs extrêmes ;
- la médiane : la valeur centrale, robuste aux valeurs extrêmes ;
- l’écart-type \(s = \sqrt{\frac{1}{N-1}\sum_i (x_i - \bar{x})^2}\) : distance typique à la moyenne ;
- les quantiles : la valeur en dessous de laquelle se trouve une part donnée des observations ; l’écart interquartile (IQR) est le 75e percentile moins le 25e.
mean(cs$life_exp)[1] 72.93089median(cs$life_exp)[1] 73.842sd(cs$life_exp)[1] 7.453676quantile(cs$life_exp, probs = c(0.1, 0.25, 0.5, 0.75, 0.9)) 10% 25% 50% 75% 90%
62.17430 67.04850 73.84200 78.46375 82.60891 IQR(cs$life_exp)[1] 11.41525Écart-type : la distance typique entre un pays et le pays moyen. \(s\) petit : les valeurs se regroupent autour de la moyenne. \(s\) grand : elles sont dispersées. Il s’exprime dans l’unité de la variable (en ans pour l’espérance de vie) : deux écarts-types ne sont donc comparables que pour la même variable.
summary() donne les principaux d’un coup :
summary(cs$life_exp) Min. 1st Qu. Median Mean 3rd Qu. Max.
52.99 67.05 73.84 72.93 78.46 85.26 summary(cs$gdp_pc_ppp) Min. 1st Qu. Median Mean 3rd Qu. Max.
1055 6417 16895 26480 38265 133454 Regardez le PIB par habitant : la moyenne (26 480 $) est bien supérieure à la médiane (16 895 $). Quelques pays riches tirent la moyenne vers le haut. La distribution est asymétrique à droite.
Aperçu : ggplot est enseigné à la séance 5 et les tableaux gt ne sont qu’une étape de mise en forme. Pour l’instant, recopiez les modèles et concentrez-vous sur les statistiques.
Afficher le code du graphique (enseigné à la séance 5)
mm <- tibble(
  statistic = c("Mean", "Median"),
  value     = c(mean(cs$gdp_pc_ppp), median(cs$gdp_pc_ppp))
)

ggplot(cs, aes(gdp_pc_ppp)) +
  geom_histogram(bins = 30, fill = "grey80", colour = "white") +
  geom_vline(data = mm, aes(xintercept = value, colour = statistic), linewidth = 1.1) +
  scale_colour_manual(values = c(Mean = pal_cours[["accent"]], Median = pal_cours[["principal"]]),
                      labels = c(Mean = "Moyenne", Median = "Médiane")) +
  scale_x_continuous(labels = label_dollar()) +
  labs(
    title = "Quelques pays riches tirent la moyenne au-dessus de la médiane",
    x = "PIB par habitant (en $ PPA constants de 2021)", y = "Nombre de pays", colour = NULL,
    caption = paste0("Source : Banque mondiale, World Development Indicators (WDI), 2019. N = ", n_cs, " pays.")
  ) +
  theme(legend.position = "top")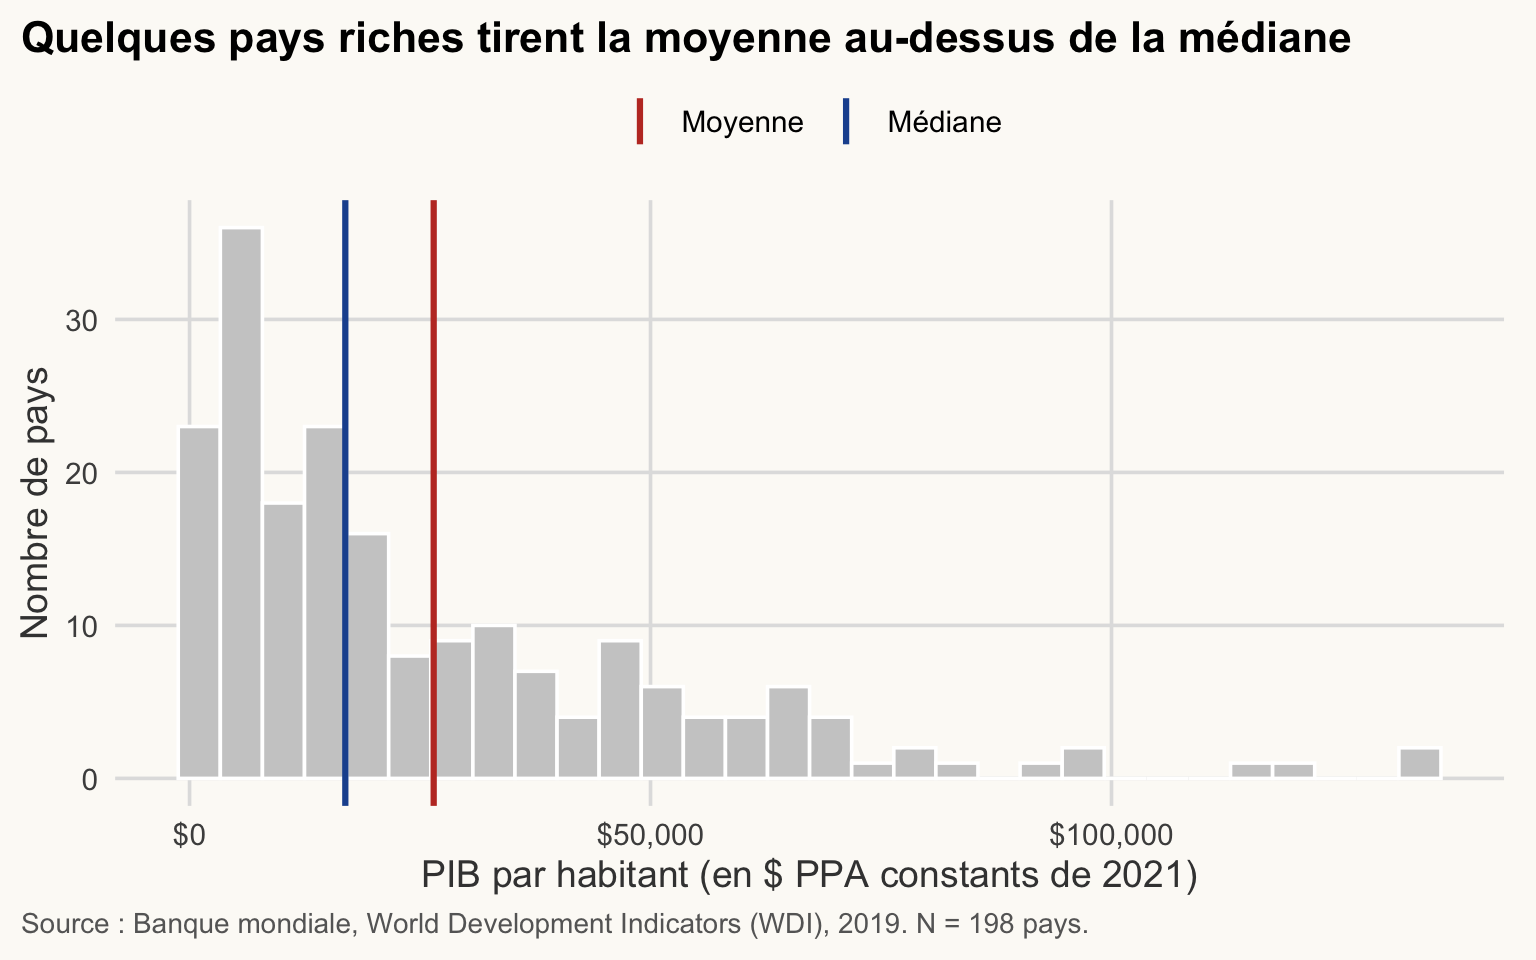
NoteComment lire ce graphique
- Chaque barre compte les pays dans une tranche de PIB par habitant ; l’essentiel de la masse est à gauche.
- La ligne bleue (médiane) sépare les pays en deux moitiés égales. La ligne rouge (moyenne) se situe à sa droite car les quelques pays très riches de la queue la tirent vers le haut.
- Plus les deux lignes sont éloignées, plus la variable est asymétrique. Pour une variable symétrique, elles coïncideraient.
cs |>
  select(gdp_pc_ppp, log_gdp_pc) |>
  pivot_longer(everything(), names_to = "variable", values_to = "value") |>
  # factor() : fixer l'ordre des panneaux et donner à chaque variable un libellé lisible
  mutate(variable = factor(variable,
                           levels = c("gdp_pc_ppp", "log_gdp_pc"),
                           labels = c("GDP per capita (2021 PPP $)", "Log of GDP per capita"))) |>
  ggplot(aes(value)) +
  geom_histogram(bins = 25, fill = pal_cours[["principal"]], colour = "white") +
  facet_wrap(~ variable, scales = "free_x") +
  scale_x_continuous(labels = label_number(big.mark = ",")) +
  labs(
    title = "La plupart des pays sont pauvres ; quelques-uns sont très riches",
    x = NULL, y = "Nombre de pays",
    caption = paste0("Source : Banque mondiale, World Development Indicators (WDI), 2019. N = ", n_cs, " pays.")
  )
NoteComment lire ce graphique
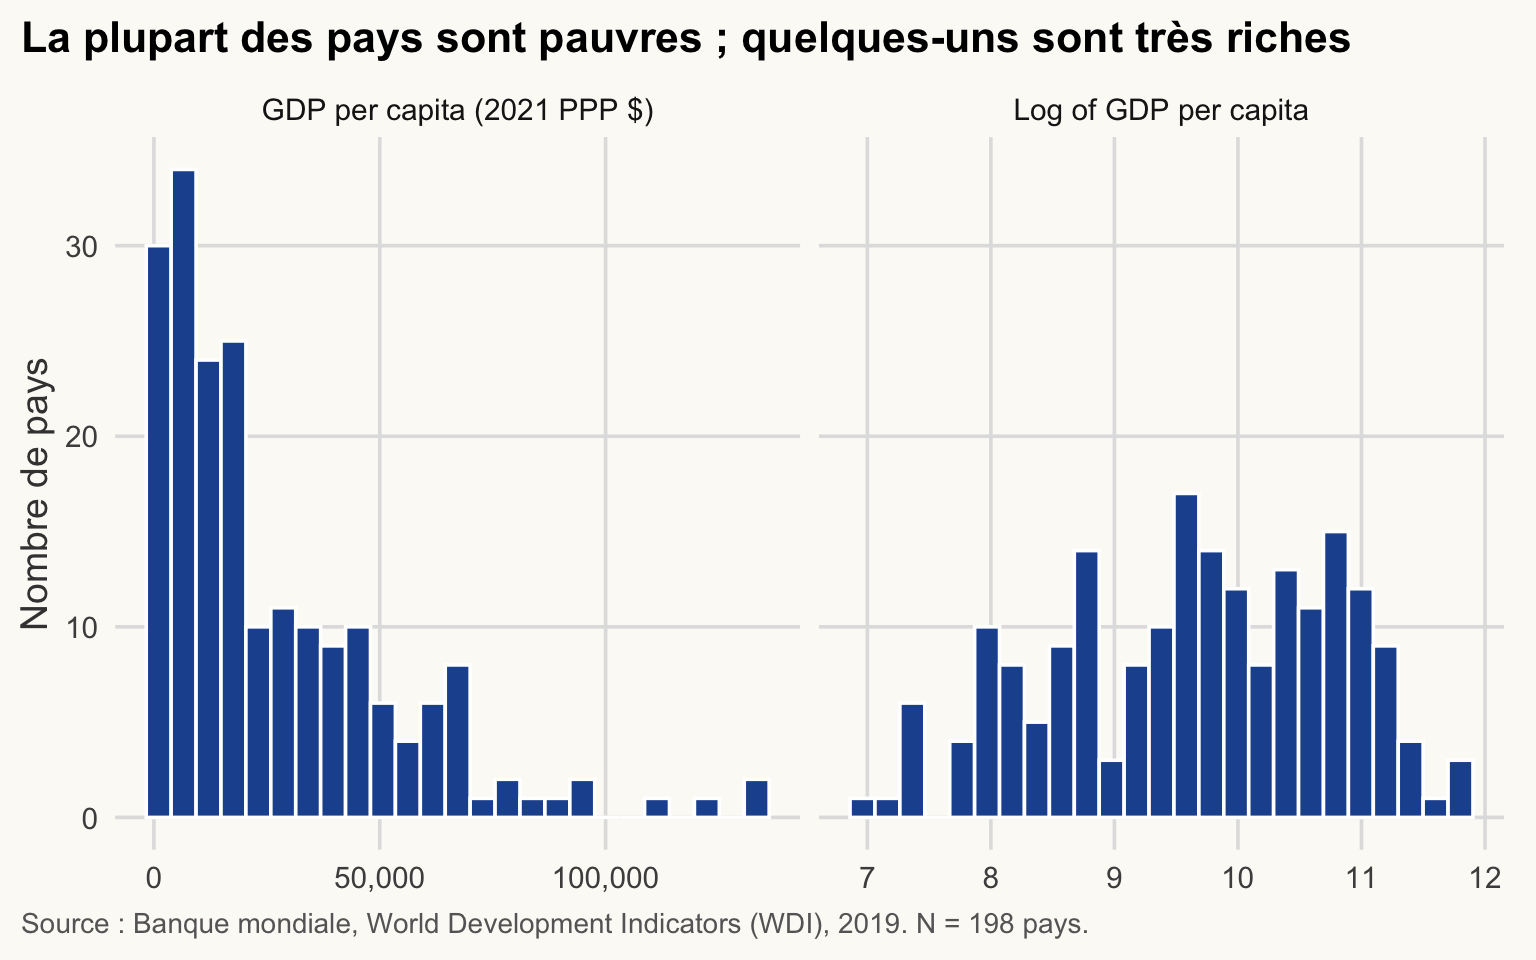
- Panneau de gauche : les niveaux. Presque tous les pays sont concentrés dans les premières barres et une longue queue s’étire vers la droite.
- Panneau de droite : les logarithmes. Les mêmes pays sont maintenant répartis en une cloche à peu près symétrique.
- Mêmes données, autre échelle : le logarithme ne change pas le classement des pays, seulement la façon de mesurer les distances entre eux.
Pourquoi des logarithmes ? Un logarithme transforme les écarts multiplicatifs en écarts additifs : passer de 1 000 $ à 2 000 $ représente le même pas que passer de 20 000 $ à 40 000 $ (+100 %). Il est plus pertinent de penser les écarts de revenu entre pays en pourcentages qu’en dollars. C’est aussi le logarithme qui rend la relation avec l’espérance de vie proche d’une droite (section 4).
ImportantIdée clé
Quand une variable est asymétrique à droite, la moyenne décrit autant les quelques pays riches que le pays typique. Présentez la médiane, et analysez le revenu en logarithmes.
Par groupe
group_by() + summarise() (séance 3) donne les statistiques par groupe. Les groupes sont les groupes de revenu (classification actuelle de la Banque mondiale) : la variable income contient le groupe actuel de chaque pays, appliqué à toutes les années, si bien qu’un pays qui a changé de groupe depuis apparaît dans son groupe actuel même en 2019.
by_inc <- cs |>
  group_by(income) |>
  summarise(
    N          = n(),
    mean_le    = mean(life_exp),
    median_le  = median(life_exp),
    sd_le      = sd(life_exp),
    iqr_le     = IQR(life_exp)
  )
by_inc
# A tibble: 4 × 6
income N mean_le median_le sd_le iqr_le
<fct> <int> <dbl> <dbl> <dbl> <dbl>
1 Low income 20 62.4 62.2 3.93 5.04
2 Lower middle income 46 66.8 66.6 5.44 7.84
3 Upper middle income 58 73.2 73.8 3.87 5.42
4 High income 74 79.4 81.3 4.45 5.99ggplot(cs, aes(income, life_exp)) +
geom_boxplot(fill = "grey90", colour = pal_cours[["principal"]], outlier.shape = NA) +
geom_jitter(width = 0.15, alpha = 0.5, colour = pal_cours[["principal"]]) +
labs(
title = str_wrap("Les pays plus riches vivent plus longtemps ; la dispersion est proche d'un groupe à l'autre", 60),
x = NULL, y = "Espérance de vie à la naissance (ans)",
caption = str_wrap(paste0("Source : Banque mondiale, World Development Indicators (WDI), 2019. N = ", n_cs, " pays."), 95)
)
NoteComment lire ce graphique
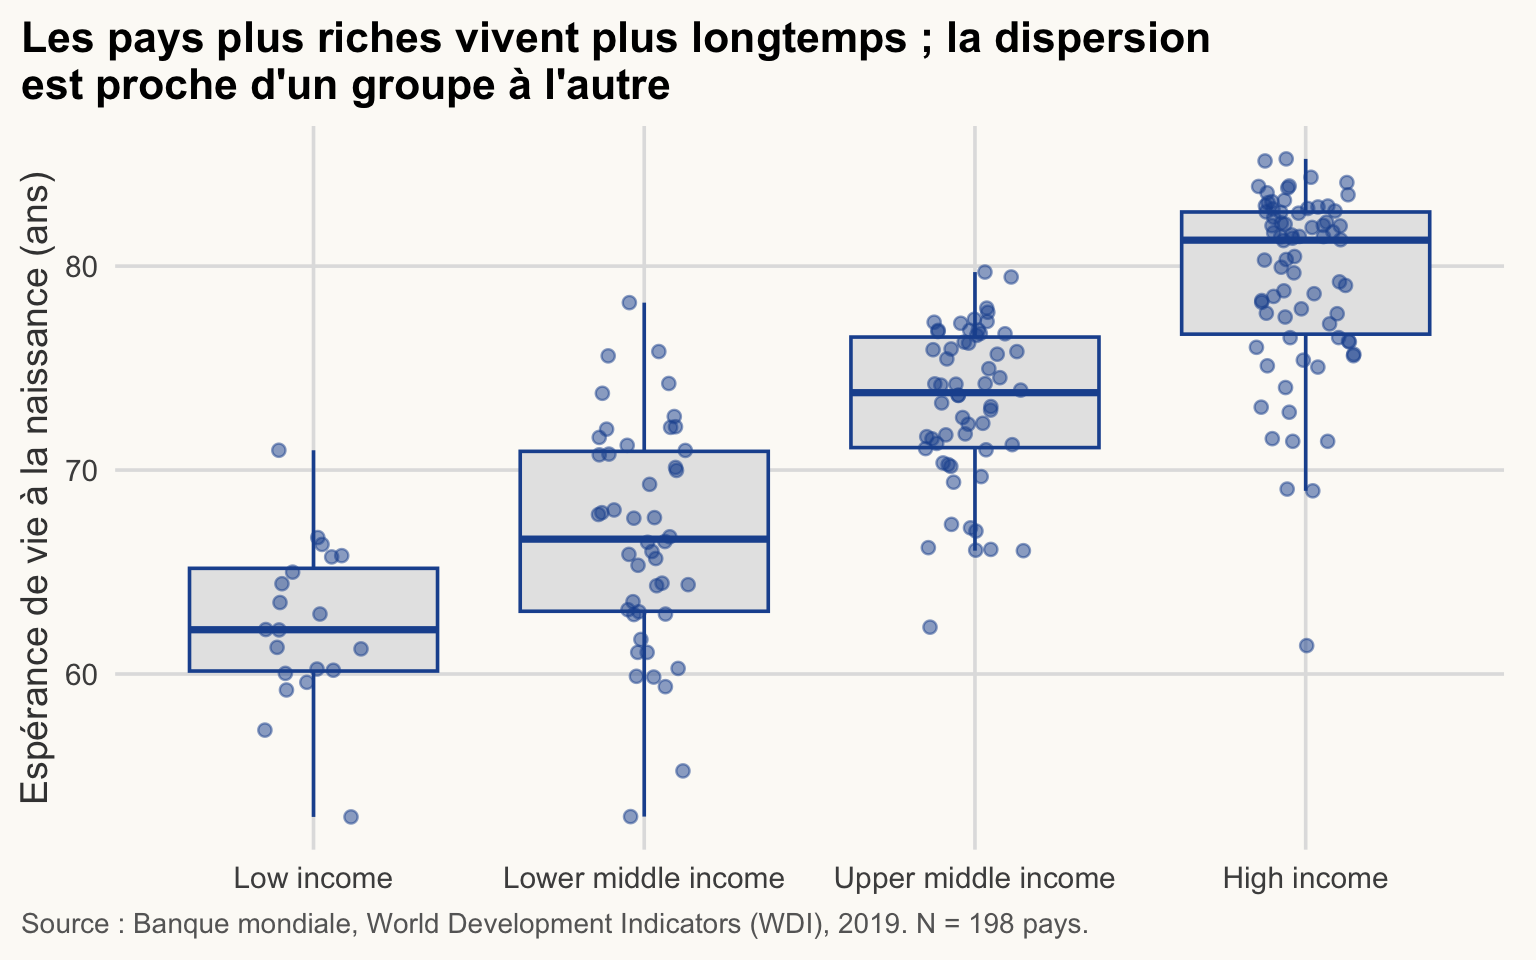
- Chaque boîte couvre les 50 % de pays du milieu d’un groupe (du 25e au 75e percentile) ; la ligne épaisse à l’intérieur est la médiane ; chaque point est un pays.
- Comparez les hauteurs des boîtes : elles montent du revenu faible au revenu élevé, donc les groupes plus riches vivent plus longtemps.
- Comparez les tailles des boîtes : elles sont proches. La plus large est celle du groupe à revenu intermédiaire de la tranche inférieure (écart interquartile de 7,8 ans dans le tableau ci-dessus, contre 5,0 à 6,0 pour les autres groupes). Être plus riche ne rend pas un groupe plus homogène.
Un tableau de synthèse soigné
Un tableau destiné à un article a des nombres formatés, une colonne N et une note de source. gt le construit à partir d’un data frame.
cs |>
  group_by(region) |>
  summarise(
    N               = n(),
    gdp_mean        = mean(gdp_pc_ppp),
    gdp_median      = median(gdp_pc_ppp),
    le_mean         = mean(life_exp),
    le_sd           = sd(life_exp)
  ) |>
  arrange(desc(le_mean)) |>
  gt() |>
  cols_label(
    region     = "Région",
    N          = "N",
    gdp_mean   = "Moyenne",
    gdp_median = "Médiane",
    le_mean    = "Moyenne",
    le_sd      = "Écart-type"
  ) |>
  tab_spanner("PIB par habitant ($ PPA 2021)", c(gdp_mean, gdp_median)) |>
  tab_spanner("Espérance de vie (ans)", c(le_mean, le_sd)) |>
  fmt_currency(c(gdp_mean, gdp_median), decimals = 0) |>
  fmt_number(c(le_mean, le_sd), decimals = 1) |>
  tab_header(title = "Revenu et espérance de vie par région, 2019") |>
tab_source_note("Source : Banque mondiale, World Development Indicators (WDI). Une observation par pays ; N = nombre de pays. Les régions sont les catégories de la Banque mondiale.")| Revenu et espérance de vie par région, 2019 | |||||
| Région | N |
PIB par habitant ($ PPA 2021)
|
Espérance de vie (ans)
|
||
|---|---|---|---|---|---|
| Moyenne | Médiane | Moyenne | Écart-type | ||
| North America | 3 | $74,076 | $69,121 | 80.7 | 1.7 |
| Europe & Central Asia | 53 | $42,973 | $38,182 | 78.4 | 4.3 |
| Middle East, North Africa, Afghanistan & Pakistan | 22 | $29,106 | $14,968 | 75.7 | 5.9 |
| Latin America & Caribbean | 38 | $23,822 | $21,578 | 74.5 | 3.7 |
| South Asia | 6 | $11,699 | $11,129 | 73.5 | 3.9 |
| East Asia & Pacific | 31 | $26,963 | $11,629 | 72.8 | 7.0 |
| Sub-Saharan Africa | 45 | $6,482 | $3,557 | 63.3 | 4.7 |
| Source : Banque mondiale, World Development Indicators (WDI). Une observation par pays ; N = nombre de pays. Les régions sont les catégories de la Banque mondiale. | |||||
AstuceExercice 4.1
Produisez, par groupe de revenu, un tableau gt avec N, la moyenne et la médiane de elec_access (accès à l’électricité, % de la population) en 2019. Écartez les pays dont elec_access est manquant et dites combien. Que disent la moyenne et la médiane dans le groupe à revenu faible ?
NoteAfficher la solution
elec <- cs |> filter(!is.na(elec_access))
nrow(cs) - nrow(elec)   # pays écartés
[1] 1elec |>
group_by(income) |>
summarise(N = n(), mean = mean(elec_access), median = median(elec_access)) |>
gt() |>
fmt_number(c(mean, median), decimals = 1) |>
tab_header(title = "Accès à l'électricité (% de la population), 2019") |>
tab_source_note("Source : Banque mondiale, World Development Indicators (WDI). N = nombre de pays avec données.")| Accès à l'électricité (% de la population), 2019 | |||
| income | N | mean | median |
|---|---|---|---|
| Low income | 20 | 38.1 | 30.9 |
| Lower middle income | 46 | 73.6 | 76.0 |
| Upper middle income | 57 | 96.5 | 99.7 |
| High income | 74 | 99.8 | 100.0 |
| Source : Banque mondiale, World Development Indicators (WDI). N = nombre de pays avec données. | |||
low <- elec |> filter(income == "Low income")
c(mean = mean(low$elec_access), median = median(low$elec_access))
mean median
38.08 30.95 Dans le groupe à revenu faible, la médiane (30,9 %) est inférieure à la moyenne (38,1 %) : quelques pays à fort accès tirent la moyenne vers le haut, la distribution est donc asymétrique à droite. L’accès est très inégal, même parmi les pays pauvres.
3. Corrélation
≈ 30 min, dont l’exercice 4.2 Après cette section, vous saurez calculer une corrélation, la tester, et expliquer ce qu’elle dit et ne dit pas.
Le coefficient de corrélation mesure l’intensité de l’association linéaire entre deux variables :
\[ r_{XY} = \frac{\operatorname{cov}(X, Y)}{\sigma_X \, \sigma_Y}, \qquad -1 \le r_{XY} \le 1 . \]
C’est la covariance rapportée aux deux écarts-types, il ne dépend donc pas des unités. \(r = 1\) : droite parfaite croissante ; \(r = -1\) : droite parfaite décroissante ; \(r = 0\) : aucune association linéaire.
Corrélation (\(r\)) : un nombre entre -1 et 1 qui indique à quel point deux variables évoluent le long d’une droite, et dans quel sens. Règle empirique : |r| inférieur à 0,3 est faible, supérieur à 0,7 est fort. Il ne dit rien sur la variable qui influence l’autre.
n_sim <- 200
x <- rnorm(n_sim)
make_y <- function(r, x) r * x + sqrt(1 - r^2) * rnorm(length(x))

x_u <- runif(n_sim, -2, 2)
sim <- bind_rows(
  tibble(x = x,   y = make_y(0.9, x),  panel = "Strong positive"),
  tibble(x = x,   y = make_y(0, x),    panel = "No relationship"),
  tibble(x = x,   y = make_y(-0.9, x), panel = "Strong negative"),
  tibble(x = x_u, y = x_u^2,           panel = "Strong but non-linear")
) |>
  group_by(panel) |>
  mutate(r = cor(x, y)) |>
  ungroup() |>
  # fct_inorder() : garder les panneaux dans leur ordre d'apparition, pas alphabétique
  mutate(panel = fct_inorder(paste0(panel, " (r = ", sprintf("%.2f", r), ")")))

ggplot(sim, aes(x, y)) +
  geom_point(alpha = 0.6, colour = pal_cours[["principal"]]) +
  facet_wrap(~ panel, scales = "free") +
  labs(
    title = str_wrap("r mesure l'association linéaire, pas l'existence d'un lien entre deux variables", 60),
    x = "X", y = "Y",
    caption = str_wrap("Source : données simulées.", 95)
  )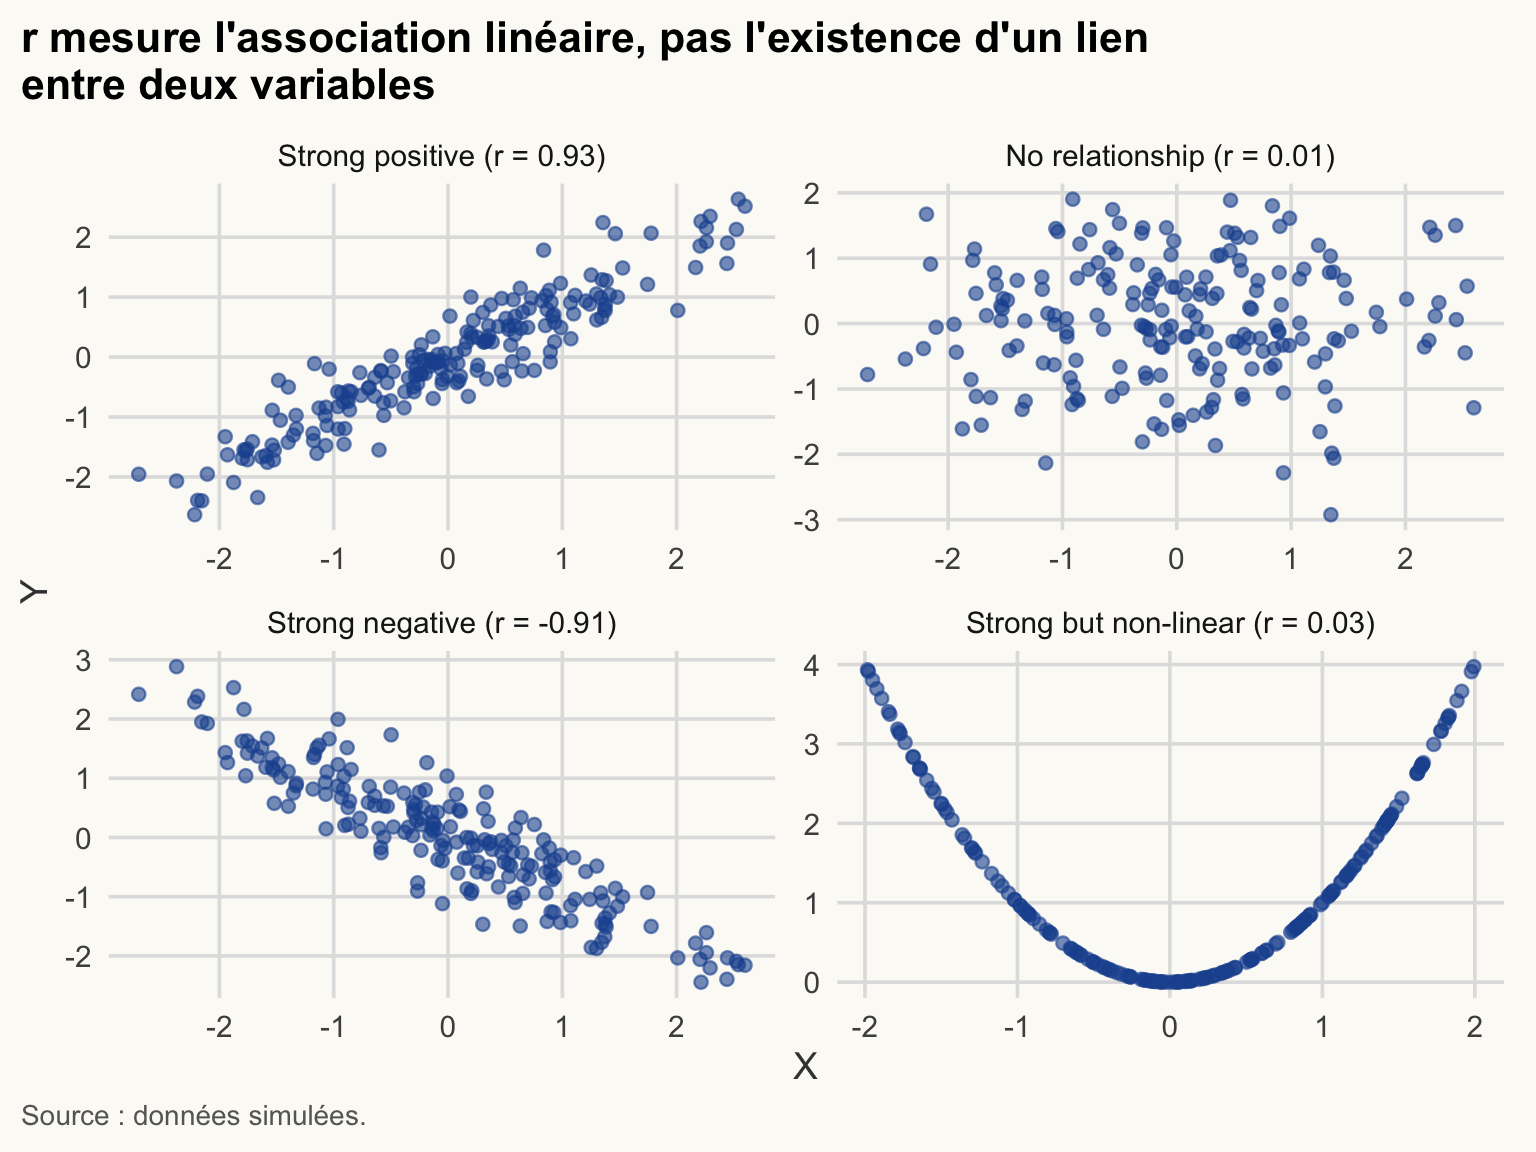
Le dernier panneau est la leçon clé : \(Y = X^2\) est une relation déterministe, et pourtant \(r \approx 0\). Faites toujours un graphique avant de calculer une corrélation.
NoteComment lire ce graphique
- Chaque panneau est un nuage de 200 points ; plus le nuage est resserré autour d’une droite, plus |r| est proche de 1.
- Panneau 2 : un nuage informe, r proche de 0. Panneau 4 : un U parfait, et pourtant r proche de 0, car la courbe n’est pas une droite.
- Un nombre comme r cache la forme des données. Le graphique la montre.
Passons aux données réelles : revenu et espérance de vie.
r_lin <- cor(cs$gdp_pc_ppp, cs$life_exp, use = "complete.obs")
r_log <- cor(cs$log_gdp_pc, cs$life_exp, use = "complete.obs")
c(levels = r_lin, logs = r_log)
levels logs
0.7394593 0.8564695 La corrélation avec le PIB par habitant en niveaux est de 0,74 ; avec le logarithme, elle est de 0,86. La relation est beaucoup plus proche d’une droite en logarithmes : c’est la bonne échelle.
ct <- cor.test(cs$log_gdp_pc, cs$life_exp)
ct
    Pearson's product-moment correlation

data:  cs$log_gdp_pc and cs$life_exp
t = 23.229, df = 196, p-value < 2.2e-16
alternative hypothesis: true correlation is not equal to 0
95 percent confidence interval:
 0.8142747 0.8896611
sample estimates:
      cor
0.8564695
cor.test() teste \(H_0: \rho = 0\). Ici \(r\) = 0,86, avec un intervalle de confiance à 95 % de [0,81 ; 0,89] et N = 198. La p-valeur est inférieure à \(10^{-15}\) : nous rejetons l’absence de corrélation. Mais une p-valeur minuscule ne dit pas que la corrélation est causale ou importante ; elle dit qu’il est peu probable qu’elle relève du seul bruit d’échantillonnage.
p-valeur : s’il n’y avait vraiment aucune relation dans la population, à quelle fréquence verrions-nous par hasard une corrélation (ou un écart, ou un coefficient) au moins aussi grande ? Une p-valeur faible signifie « difficile à attribuer au hasard ». Elle ne dit pas que l’effet est grand, important ou causal.
AvertissementErreur fréquente
Corrélation n’est pas causalité. Le revenu et l’espérance de vie évoluent ensemble (r proche de 0,86 en logarithmes), mais la corrélation seule ne peut dire si le revenu améliore la santé, si la santé augmente le revenu, ou si autre chose (institutions, éducation, climat) les détermine tous deux. Avant d’écrire « X entraîne Y », demandez-vous : Y pourrait-il causer X ? Une troisième variable pourrait-elle causer les deux ?
AstuceExercice 4.2
Calculez la corrélation entre elec_access et life_exp dans la coupe transversale 2019 (use = "complete.obs"), lancez cor.test() et tracez le nuage de points. Une droite est-elle un résumé raisonnable ?
NoteAfficher la solution
cor(cs$elec_access, cs$life_exp, use = "complete.obs")[1] 0.7504866cor.test(cs$elec_access, cs$life_exp)
    Pearson's product-moment correlation

data:  cs$elec_access and cs$life_exp
t = 15.857, df = 195, p-value < 2.2e-16
alternative hypothesis: true correlation is not equal to 0
95 percent confidence interval:
 0.6822713 0.8057475
sample estimates:
      cor
0.7504866
cs |>
filter(!is.na(elec_access)) |>
ggplot(aes(elec_access, life_exp)) +
geom_point(alpha = 0.6, colour = pal_cours[["principal"]]) +
labs(
title = str_wrap("L'espérance de vie augmente avec l'accès à l'électricité, mais le lien s'infléchit", 60),
x = "Accès à l'électricité (% de la population)",
y = "Espérance de vie à la naissance (ans)",
caption = str_wrap("Source : Banque mondiale, World Development Indicators (WDI), 2019.", 95)
)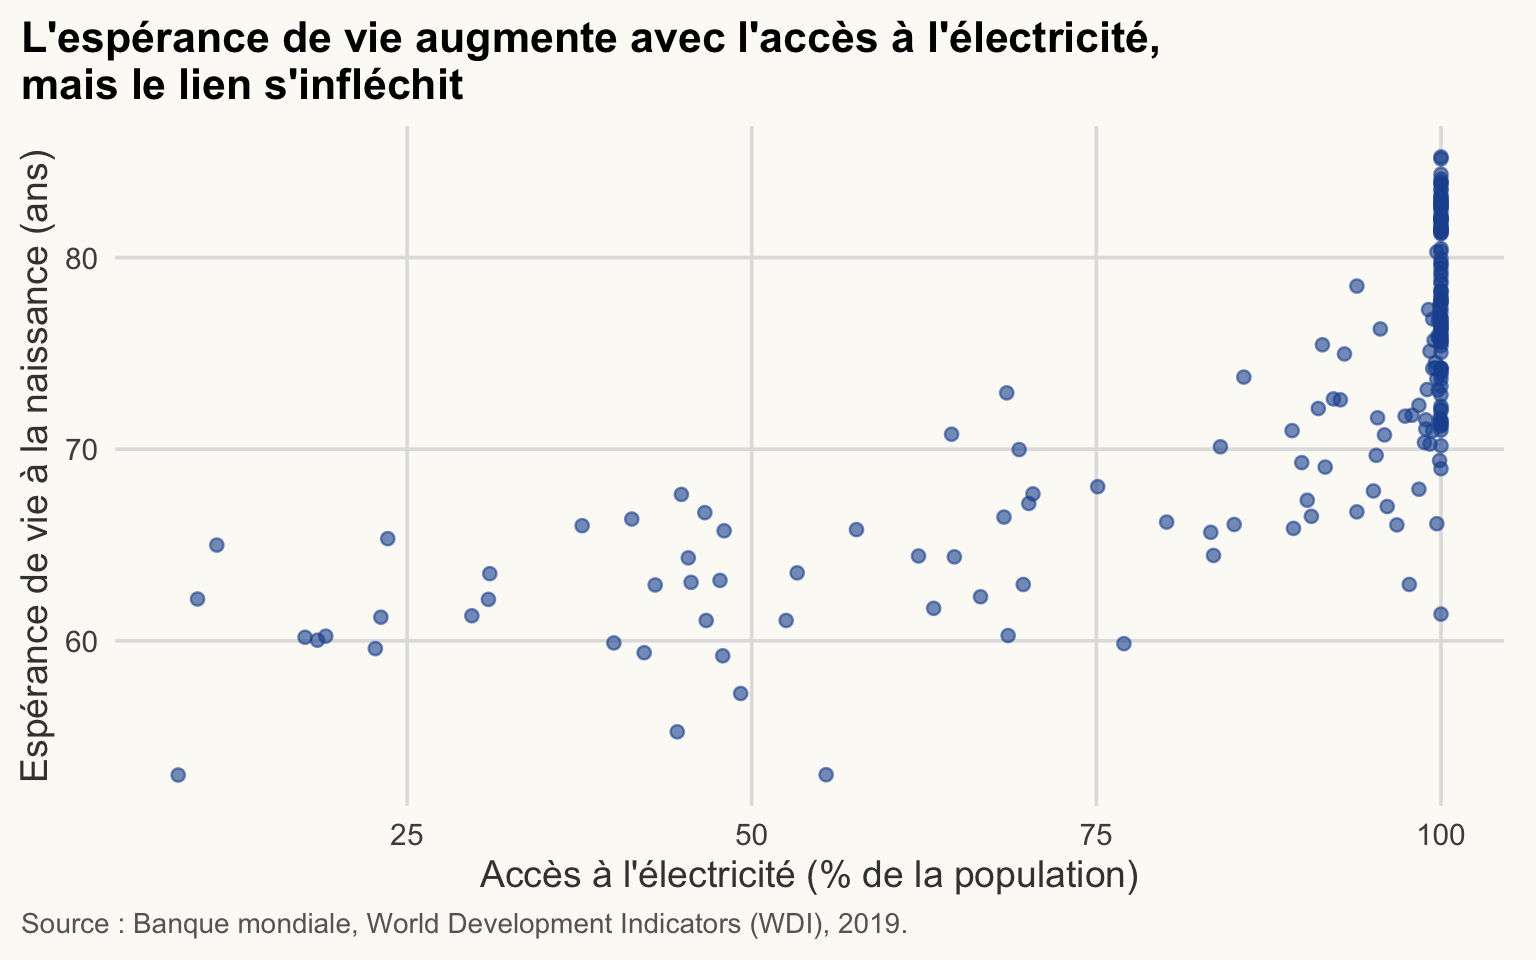
La plupart des pays sont proches de 100 % d’accès ; la relation n’est pentue qu’aux faibles niveaux d’accès, une seule droite est donc un résumé grossier. C’est une caractéristique des données (un plafond), pas une erreur.
ImportantIdée clé
Une corrélation est le résumé en un seul nombre d’une relation en ligne droite. Tracez d’abord, vérifiez l’échelle (logarithmes), puis calculez la corrélation, et ne la lisez jamais comme un lien de cause à effet.
4. Régression simple
≈ 40 min, dont l’exercice 4.3 Après cette section, vous saurez estimer une régression simple, lire sa pente dans les unités des données, et expliquer ce qu’est un résidu.
La corrélation est symétrique et sans unité. Une régression donne une pente dans les unités des données :
\[ \text{life\_exp}_i = \alpha + \beta \, \ln(\text{GDP pc}_i) + \varepsilon_i . \]
Les MCO (moindres carrés ordinaires, OLS) choisissent \(\alpha, \beta\) pour minimiser la somme des carrés des résidus \(\sum_i \hat{\varepsilon}_i^2\).
NoteEn clair
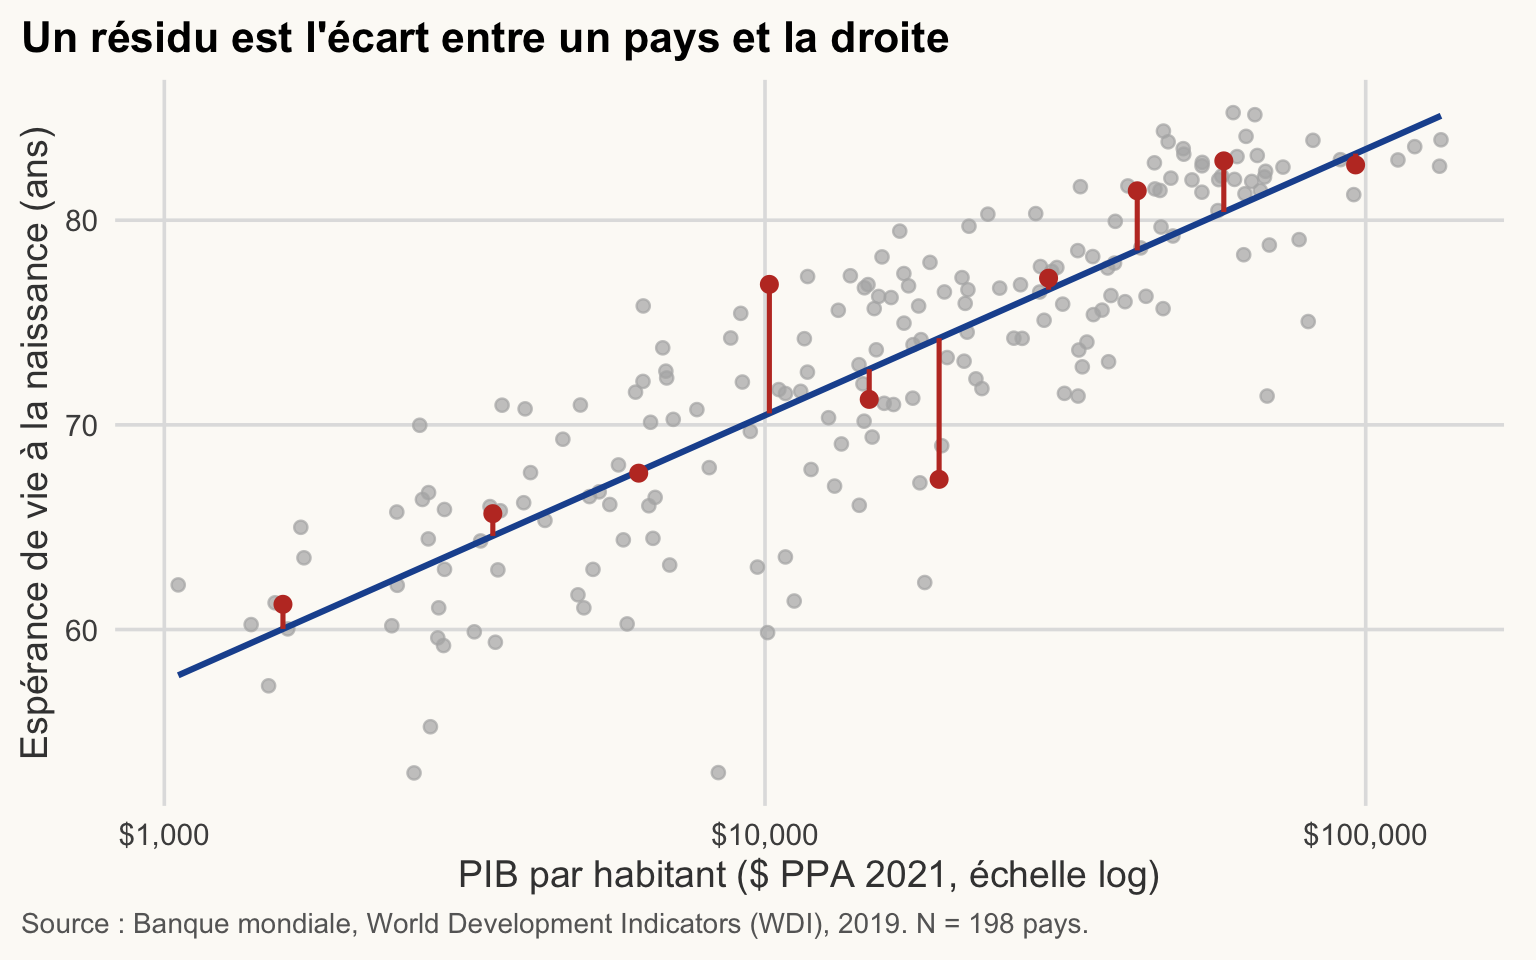
Imaginez que vous tracez une droite à travers le nuage de pays. Pour chaque pays, le résidu est l’écart vertical entre le pays et la droite : de combien son espérance de vie réelle diffère de ce que la droite prédit. Les MCO choisissent la droite qui rend ces écarts, élevés au carré puis additionnés, aussi petits que possible.
Trois choses à savoir avant le code.
-
Formules. R écrit un modèle sous la forme
y ~ x1 + x2: la variable à expliquer à gauche de~, les variables explicatives à droite, séparées par+. La constante est ajoutée automatiquement. -
lm()oufeols().lm()fait partie de R de base et donne les mêmes coefficients. Nous utilisonsfixest::feols()car il gère plus commodément les erreurs-types et s’étend aux modèles à effets fixes que vous rencontrerez plus tard. -
vcov = "hetero"demande des erreurs-types robustes à l’hétéroscédasticité : elles restent valides quand la dispersion des erreurs diffère selon les pays, ce qui est le cas habituel. Cela change les erreurs-types, pas les coefficients. Cela ne corrige pas le biais de variable omise ni la causalité inverse : ce sont des problèmes du modèle, pas des erreurs-types.
Erreur-type robuste : une estimation de la variation d’un coefficient d’un échantillon à l’autre, calculée sans supposer que les erreurs ont la même dispersion pour tous les pays. Elle modifie la largeur de l’intervalle de confiance et la p-valeur, jamais le coefficient lui-même. Ne la confondez pas avec l’écart-type (section 2) : l’écart-type mesure la dispersion d’une variable entre pays, l’erreur-type mesure l’incertitude sur une estimation.
AvertissementErreur fréquente
Utiliser des erreurs-types robustes et en conclure que l’estimation est « causale ». Les erreurs-types robustes rendent seulement l’incertitude plus honnête. Si le revenu et la santé sont tous deux déterminés par les institutions, le coefficient est biaisé quelles que soient les erreurs-types.
m1 <- feols(life_exp ~ log_gdp_pc, data = cs, vcov = "hetero")
summary(m1)
OLS estimation, Dep. Var.: life_exp
Observations: 198
Standard-errors: Heteroskedasticity-robust
Estimate Std. Error t value Pr(>|t|)
(Intercept) 18.44317 2.201431 8.37781 1.0268e-14 ***
log_gdp_pc 5.64837 0.219547 25.72742 < 2.2e-16 ***
---
Signif. codes: 0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1
RMSE: 3.83784 Adj. R2: 0.732181b1 <- coef(m1)[["log_gdp_pc"]](Nous avons créé log_gdp_pc au préalable ; feols(life_exp ~ log(gdp_pc_ppp)) donnerait le même résultat.)
Lire le coefficient (modèle log-niveau). \(\hat\beta\) = 5,65 ans. Comme le PIB entre en logarithmes :
- une hausse de 1 % du PIB par habitant est associée à \(\hat\beta / 100 \approx\) 0,056 an d’espérance de vie en plus ;
- une hausse de 10 % est associée à environ \(\hat\beta \times \ln(1{,}1) = \hat\beta \times 0{,}0953 \approx\) 0,54 an ;
- un doublement du PIB par habitant est associé à \(\hat\beta \times \ln 2 \approx\) 3,92 ans.
La constante (18,4) est l’espérance de vie prédite pour \(\ln(\text{GDP pc}) = 0\), c’est-à-dire un PIB par habitant de 1 $ : hors de l’étendue des données, donc non interprétable.
Le \(R^2\) est la part de la variance de l’espérance de vie « expliquée » par la droite : ici 0,73, soit aussi le \(r^2\) de la section 3. Notez les guillemets : expliquée signifie statistiquement prise en compte, pas causée.
Afficher le code du graphique (enseigné à la séance 5)
cs_fit <- cs |>
  mutate(fitted_le = fitted(m1)) |>
  arrange(gdp_pc_ppp)

# dix pays répartis le long de la distribution des revenus
shown <- cs_fit |> slice(round(seq(5, nrow(cs_fit) - 4, length.out = 10)))

ggplot(cs_fit, aes(gdp_pc_ppp, life_exp)) +
  geom_point(colour = "grey70", alpha = 0.7) +
  geom_line(aes(y = fitted_le), colour = pal_cours[["principal"]], linewidth = 1.1) +
  geom_segment(data = shown, aes(xend = gdp_pc_ppp, yend = fitted_le),
               colour = pal_cours[["accent"]], linewidth = 0.9) +
  geom_point(data = shown, colour = pal_cours[["accent"]], size = 2.5) +
  scale_x_log10(labels = label_dollar()) +
  labs(
    title = "Un résidu est l'écart entre un pays et la droite",
    x = "PIB par habitant ($ PPA 2021, échelle log)",
    y = "Espérance de vie à la naissance (ans)",
    caption = paste0("Source : Banque mondiale, World Development Indicators (WDI), 2019. N = ", n_cs, " pays.")
  )
NoteComment lire ce graphique
- La ligne bleue est la prédiction : pour un PIB par habitant donné, l’espérance de vie attendue par le modèle.
- Chaque segment rouge est un résidu : positif au-dessus de la droite (le pays vit plus longtemps que prévu), négatif en dessous.
- Les MCO choisissent la droite qui minimise la somme des longueurs au carré de tous les écarts, pas seulement des rouges.
ggplot(cs, aes(gdp_pc_ppp, life_exp)) +
  geom_point(alpha = 0.6, colour = pal_cours[["principal"]]) +
  geom_smooth(method = "lm", formula = y ~ x, colour = pal_cours[["accent"]],
              fill = pal_cours[["accent"]], alpha = 0.15) +
  scale_x_log10(labels = label_dollar()) +
  labs(
    title = "Les pays plus riches ont une espérance de vie plus longue",
    x = "PIB par habitant ($ PPA 2021, échelle log)",
    y = "Espérance de vie à la naissance (ans)",
    caption = paste0("Source : Banque mondiale, World Development Indicators (WDI), 2019. N = ", n_cs, " pays.")
  )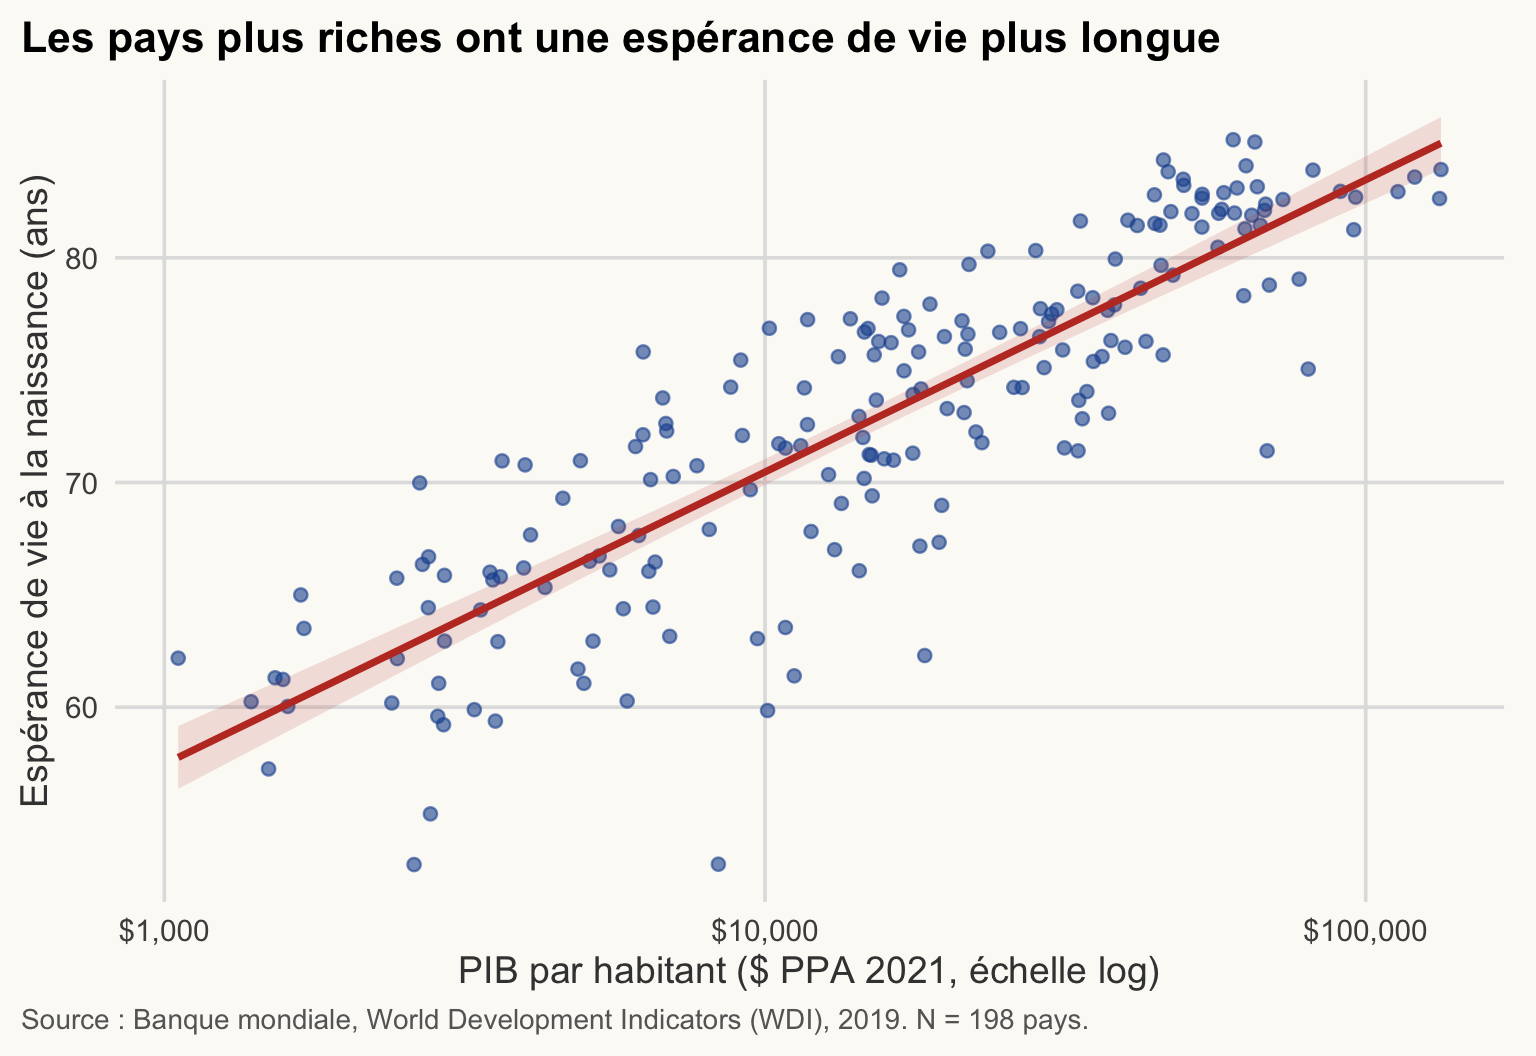
Avec un axe des x logarithmique, la relation ajustée est une droite, ce qui est exactement le modèle log-niveau.
NoteComment lire ce graphique
- Chaque point est un pays ; la droite est l’ajustement MCO et la bande grisée son intervalle de confiance à 95 %.
- La pente de la droite est \(\hat\beta\) : le gain en ans par unité de logarithme népérien du PIB. Les graduations de l’axe sont des puissances de dix : d’une graduation à la suivante (un revenu dix fois plus élevé), le gain est de \(\hat\beta \times \ln 10 \approx\) 13 ans.
- Les points éloignés de la droite sont des pays en bien meilleure ou bien moins bonne santé que ne le prédit leur revenu. La bande montre l’incertitude sur la droite, pas sur chaque pays.
NotePourquoi c’est important en économie du développement
Le gradient revenu-santé (la « courbe de Preston ») est un point de départ pour les questions d’aide et de croissance : augmenter les revenus permet-il de vivre plus longtemps ? Cette régression ne peut y répondre, mais elle montre l’ampleur de l’écart dont toute explication doit rendre compte.
ImportantIdée clé
Dans une régression log-niveau, la pente \(\hat\beta\) se lit pour 1 % (diviser par 100) ou pour un doublement (multiplier par 0,69) du revenu. C’est une différence entre pays, pas ce qui arriverait à un pays qui croît.
AstuceExercice 4.3
Régressez life_exp sur elec_access dans la coupe transversale 2019 (feols, erreurs-types robustes). Interprétez la pente en une phrase (unités !), donnez le \(R^2\) et N, et dites ce qui vous inquiéterait avant d’y voir un effet de l’électrification.
NoteAfficher la solution
m_el <- feols(life_exp ~ elec_access, data = cs, vcov = "hetero")
summary(m_el)
OLS estimation, Dep. Var.: life_exp
Observations: 197
Standard-errors: Heteroskedasticity-robust
Estimate Std. Error t value Pr(>|t|)
(Intercept) 52.607599 1.281582 41.0489 < 2.2e-16 ***
elec_access 0.234818 0.014405 16.3010 < 2.2e-16 ***
---
Signif. codes: 0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1
RMSE: 4.92181 Adj. R2: 0.56099r2(m_el, "r2") r2
0.5632302 La pente est la différence d’espérance de vie (en ans) associée à un point de pourcentage supplémentaire de la population ayant accès à l’électricité. N est le nombre de pays dont elec_access n’est pas manquant. Inquiétudes : variables omises (le revenu, les institutions, les dépenses de santé déterminent les deux), causalité inverse (les sociétés plus saines et plus riches s’électrifient) et non-linéarité (plafond à 100 %).
5. Régression multiple
≈ 40 min, dont l’exercice 4.4 Après cette section, vous saurez lire un tableau de régression à plusieurs modèles, et expliquer pourquoi il ne faut pas confondre changement d’échantillon et changement de spécification.
La relation revenu-santé n’est-elle que le reflet d’autre chose ? Ajoutons des variables de contrôle :
\[ \text{life\_exp}_i = \alpha + \beta \ln(\text{GDP pc}_i) + \gamma \, \text{Gini}_i + \delta' \text{Region}_i + \varepsilon_i . \]
D’abord, le coût : le Gini est manquant pour de nombreux pays.
n_gini <- cs |> filter(!is.na(gini)) |> nrow()
tibble(sample = c("All countries", "With Gini"), N = c(n_cs, n_gini))
# A tibble: 2 × 2
sample N
<chr> <int>
1 All countries 198
2 With Gini 78N passe de 198 à 78. Ajouter le Gini change donc deux choses à la fois : la spécification et l’échantillon. Pour comparer équitablement, nous ré-estimons aussi le modèle simple sur l’échantillon avec Gini.
relevel() fixe la catégorie de référence des indicatrices de région : les coefficients des autres régions sont des écarts par rapport à l’Afrique subsaharienne.
cs_g <- cs |>
  filter(!is.na(gini)) |>
  mutate(region = relevel(factor(region), ref = "Sub-Saharan Africa"))
cs <- cs |>
  mutate(region = relevel(factor(region), ref = "Sub-Saharan Africa"))

m2 <- feols(life_exp ~ log_gdp_pc,               data = cs_g, vcov = "hetero")
m3 <- feols(life_exp ~ log_gdp_pc + gini,        data = cs_g, vcov = "hetero")
m4 <- feols(life_exp ~ log_gdp_pc + gini + region, data = cs_g, vcov = "hetero")
nice_names <- function(x) {
x |>
str_replace("^log_gdp_pc$", "Log du PIB par habitant") |>
str_replace("^gini$", "Indice de Gini (0-100)") |>
str_replace("^region", "Région : ") |>
str_replace("^\\(Intercept\\)$", "Constante")
}
modelsummary(
output = "gt", # un tableau gt : même aspect que les autres tableaux, sans script externe
fmt = \(x) nb(x, 3), # séparateur décimal de la langue de la page
list("(1) Tous" = m1, "(2) Avec Gini" = m2, "(3) + Gini" = m3, "(4) + Région" = m4),
coef_rename = nice_names,
stars = c("*" = 0.1, "**" = 0.05, "***" = 0.01),
gof_map = c("nobs", "r.squared"),
title = "Espérance de vie, coupe transversale 2019 (MCO)",
notes = c("Variable dépendante : espérance de vie à la naissance (ans). Erreurs-types robustes à l'hétéroscédasticité entre parenthèses.",
"Catégorie de référence des régions : Afrique subsaharienne.",
"Source : Banque mondiale, World Development Indicators (WDI), 2019. Les colonnes (2) à (4) n'utilisent que les pays disposant d'un indice de Gini.")
)| (1) Tous | (2) Avec Gini | (3) + Gini | (4) + Région | |
|---|---|---|---|---|
| Constante | 18,443*** | 23,529*** | 22,586*** | 22,071*** |
| (2,201) | (3,305) | (4,324) | (5,358) | |
| Log du PIB par habitant | 5,648*** | 5,267*** | 5,311*** | 5,143*** |
| (0,220) | (0,317) | (0,341) | (0,508) | |
| Indice de Gini (0-100) | 0,014 | 0,027 | ||
| (0,047) | (0,066) | |||
| Région : East Asia & Pacific | 1,908 | |||
| (2,089) | ||||
| Région : Europe & Central Asia | 1,750 | |||
| (2,146) | ||||
| Région : Latin America & Caribbean | 1,785 | |||
| (2,179) | ||||
| Région : Middle East, North Africa, Afghanistan & Pakistan | 2,911 | |||
| (2,386) | ||||
| Région : North America | 0,567 | |||
| (2,850) | ||||
| Région : South Asia | 4,869** | |||
| (1,871) | ||||
| Num.Obs. | 198 | 78 | 78 | 78 |
| R2 | 0.734 | 0.771 | 0.771 | 0.788 |
| * p < 0.1, ** p < 0.05, *** p < 0.01 | ||||
| Variable dépendante : espérance de vie à la naissance (ans). Erreurs-types robustes à l'hétéroscédasticité entre parenthèses. | ||||
| Catégorie de référence des régions : Afrique subsaharienne. | ||||
| Source : Banque mondiale, World Development Indicators (WDI), 2019. Les colonnes (2) à (4) n'utilisent que les pays disposant d'un indice de Gini. | ||||
gdp3    <- coef(m3)[["log_gdp_pc"]]
se_gdp3 <- se(m3)[["log_gdp_pc"]]
b <- round(c(coef(m1)[["log_gdp_pc"]], coef(m2)[["log_gdp_pc"]],
             coef(m3)[["log_gdp_pc"]], coef(m4)[["log_gdp_pc"]]), 2)
bg  <- coef(m3)[["gini"]]
bg4 <- coef(m4)[["gini"]]
se3 <- se(m3)[["gini"]]
p3  <- pvalue(m3)[["gini"]]
p4  <- pvalue(m4)[["gini"]]
NoteComment lire ce tableau
Lisez une ligne, une colonne à la fois. Prenons la ligne « Log du PIB par habitant » de la colonne (3) :
- Coefficient (5,31) : la différence d’espérance de vie, en ans, associée à une unité de plus de log du PIB par habitant, à Gini constant.
- Erreur-type (entre parenthèses, 0,34) : l’incertitude sur le coefficient. Règle approximative : le coefficient est « distinguable de zéro » s’il est à plus d’environ 2 erreurs-types de zéro (ici 15,6).
- Étoiles : un raccourci pour la p-valeur (* p < 0,1, ** p < 0,05, *** p < 0,01). Plus d’étoiles signifie « plus difficile à attribuer au hasard », pas « effet plus grand ».
- R² (en bas) : la part de la variance de l’espérance de vie prise en compte par le modèle de cette colonne.
- Num.Obs. (N) : le nombre de pays utilisés. Il change entre les colonnes (1) et (2) : comparez l’échantillon avant de comparer les estimations.
Comment lire les quatre colonnes ensemble (le tableau ci-dessus contient tous les nombres) :
- Les colonnes (1) et (2) donnent le même type d’estimation sur deux échantillons : le coefficient du PIB est de 5,65 avec tous les pays et de 5,27 avec les pays disposant d’un Gini (N = 198 contre 78). La composition de l’échantillon compte.
- Colonne (3) : ajouter le Gini ne déplace guère le coefficient du PIB (de 5,27 à 5,31). Le coefficient du Gini est de 0,014 (erreur-type robuste 0,047, p = 0,76) : un Gini supérieur de 10 points va de pair avec environ 0,14 an d’espérance de vie, à revenu constant. C’est faible, et statistiquement indistinguable de zéro.
- Colonne (4) : avec les indicatrices de région, le coefficient du PIB est de 5,14 et celui du Gini de 0,027 (p = 0,68), de nouveau faible et non significatif. Le gradient de revenu résiste aux contrôles ; ce n’est pas simplement un effet régional.
Afficher le code du graphique (enseigné à la séance 5)
modelplot(
  list("(1) Tous" = m1, "(2) Avec Gini" = m2, "(3) + Gini" = m3, "(4) + Région" = m4),
  coef_rename = nice_names,
  coef_omit = "Intercept|region"
) +
  geom_vline(xintercept = 0, linetype = "dashed", colour = "grey40") +
  scale_colour_manual(values = unname(c(pal_cours[["gris"]], pal_cours[["principal"]],
                                        pal_regions[["Sub-Saharan Africa"]], pal_cours[["accent"]]))) +
  labs(
    title = "Le gradient de revenu est stable ; le coefficient de Gini est proche de zéro",
    x = "Coefficient (ans d'espérance de vie par unité), IC à 95 %", y = NULL, colour = NULL,
    caption = "Source : Banque mondiale, World Development Indicators (WDI), 2019. Colonnes (2)-(4) : pays ayant un indice de Gini."
  ) +
  theme(legend.position = "bottom")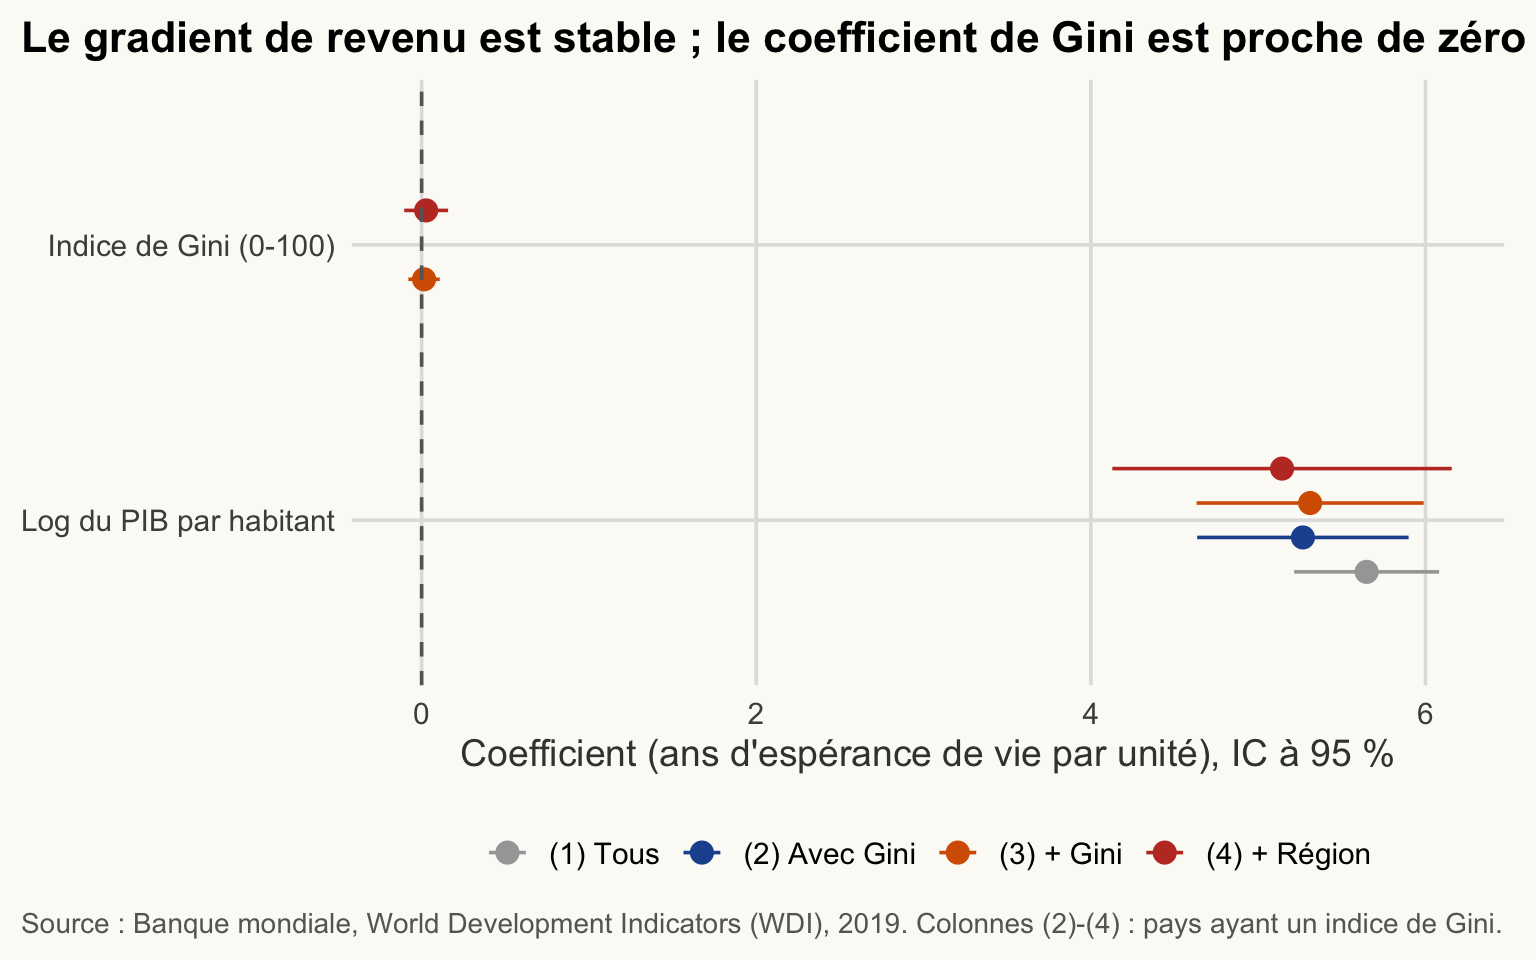
NoteComment lire ce graphique
- Chaque point est un coefficient ; la barre horizontale est son intervalle de confiance à 95 %. La ligne en pointillés marque zéro.
- Une barre qui ne touche pas zéro (log du PIB) est distinguable d’une absence de relation. Une barre qui croise zéro (Gini) ne l’est pas.
- Les deux variables sont sur des échelles différentes (points de log contre points de Gini) : comparez donc chaque barre à zéro, pas une variable à l’autre.
Chaque coefficient est « la différence associée à une variation d’une unité, toutes choses égales par ailleurs pour les autres variables incluses ». Ce sont des associations, pas des effets causaux :
- Variables omises : les institutions, les systèmes de santé, l’éducation, le climat et les conflits affectent à la fois le revenu et la santé.
- Causalité inverse : les populations en meilleure santé sont plus productives, la santé peut donc augmenter le revenu autant que l’inverse.
- Mesure et sélection : le Gini n’est disponible que pour un sous-ensemble non aléatoire de pays, et il mélange deux types d’enquêtes auprès des ménages : sur la consommation (fréquentes dans les pays à faible revenu, en Inde par exemple) et sur le revenu (la plupart des pays à revenu élevé). La consommation est moins inégalement répartie que le revenu : une même valeur du Gini ne mesure donc pas la même chose partout.
- Tirages non indépendants : les pays voisins partagent climat, histoire et institutions, les observations sont donc corrélées au sein des régions. Et nos pays de 2019 sont proches de l’ensemble de la population des pays, pas un échantillon aléatoire de celle-ci : lisez les p-valeurs comme un repère approximatif du bruit, pas comme des probabilités exactes.
ImportantIdée clé
« Toutes choses égales par ailleurs » est un énoncé sur le modèle, pas sur le monde. Un coefficient ne bouge que lorsque vous ajoutez une variable corrélée à la fois à la variable à expliquer et à la variable d’intérêt, et l’échantillon doit rester le même pour que la comparaison soit équitable.
AstuceExercice 4.4
Estimez life_exp ~ log_gdp_pc + elec_access sur la coupe transversale 2019. Le coefficient du log du PIB par habitant change-t-il par rapport au modèle (1) estimé sur les mêmes pays ? Pourquoi, en mots ?
NoteAfficher la solution
cs_el  <- cs |> filter(!is.na(elec_access))   # même échantillon pour les deux modèles
m1_el  <- feols(life_exp ~ log_gdp_pc,               data = cs_el, vcov = "hetero")
m_ctrl <- feols(life_exp ~ log_gdp_pc + elec_access, data = cs_el, vcov = "hetero")
etable(m1_el, m_ctrl)
m1_el m_ctrl
Dependent Var.: life_exp life_exp
Constant 18.35*** (2.204) 23.41*** (2.212)
log_gdp_pc 5.655*** (0.2198) 4.441*** (0.3156)
elec_access 0.0770*** (0.0186)
_______________ _________________ __________________
S.E. type Heteroskeda.-rob. Heteroskedas.-rob.
Observations 197 197
R2 0.73624 0.76288
Adj. R2 0.73489 0.76044
---
Signif. codes: 0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1elec_access est manquant pour 1 pays : le modèle (1) est donc d’abord ré-estimé sur les mêmes 197 pays. Sur cet échantillon, le coefficient du revenu passe de 5,65 à 4,44 quand on ajoute l’accès. L’accès à l’électricité est lui-même fortement corrélé au revenu, et aussi à l’espérance de vie : une partie de ce que le coefficient du revenu captait est maintenant attribuée à l’accès, si bien que le coefficient du revenu diminue.
6. Pourquoi ne pas empiler les années ?
≈ 10 min Après cette section, vous saurez expliquer pourquoi un panel de quelques pays n’est pas un grand échantillon.
AvertissementEmpiler les années de quelques pays ne donne pas des observations indépendantes
Une erreur courante : régresser le PIB sur l’année, ou comparer deux régions, en utilisant 21 années pour chacun de trois pays. Deux problèmes :
- Non-indépendance. Les 21 observations de la Chine concernent le même pays, fortement corrélées d’une année à l’autre. 63 pays-années issus de 3 pays ne forment pas un échantillon de taille 63 : les observations d’un même pays sont loin d’être indépendantes. Des erreurs-types, des tests t et des p-valeurs calculés comme si elles l’étaient seraient beaucoup trop optimistes.
- Régression fallacieuse. Deux séries quelconques qui croissent dans le temps (PIB, population, CO2, nombre de smartphones) sont fortement corrélées, quel que soit le lien causal. Un \(R^2\) élevé entre deux séries tendancielles est le résultat par défaut, pas une preuve.
Une jointure ratée peut aussi faire disparaître silencieusement un pays (les États-Unis dans l’exemple de la séance 3) : vérifiez toujours N et les clés de jointure (anti_join(), séance 3). Les remèdes utilisés aujourd’hui : une coupe transversale (une ligne par pays), N indiqué partout et, pour les panels, des méthodes conçues pour eux (effets fixes, erreurs-types clusterisées), que vous rencontrerez dans un cours plus avancé.
7. Facultatif / à la maison : tests d’hypothèses et tableau de modèles
≈ 30 min Après cette section, vous saurez tester une différence entre deux groupes et dire ce que signifie et ne signifie pas une p-valeur.
Cette section n’est pas nécessaire pour les séances suivantes. Faites-la à la maison ou si vous terminez en avance.
Question : l’espérance de vie est-elle différente en Afrique subsaharienne qu’ailleurs ? Une observation par pays, une année : l’unité d’observation est le pays, et les pays ne sont pas des tirages strictement indépendants (voir la section 5).
cs_t <- cs |>
  mutate(group = if_else(region == "Sub-Saharan Africa", "Sub-Saharan Africa", "Rest of the world"))

cs_t |>
  group_by(group) |>
  summarise(N = n(), mean = mean(life_exp), sd = sd(life_exp))
# A tibble: 2 × 4
group N mean sd
<chr> <int> <dbl> <dbl>
1 Rest of the world 153 75.8 5.46
2 Sub-Saharan Africa 45 63.3 4.72La statistique t de Welch compare deux moyennes sans supposer l’égalité des variances :
\[ t = \frac{\bar{x}_1 - \bar{x}_2}{\sqrt{\dfrac{s_1^2}{n_1} + \dfrac{s_2^2}{n_2}}} . \]
Le numérateur est l’écart observé ; le dénominateur est son erreur-type. Un \(|t|\) élevé signifie que l’écart est grand par rapport à ce que le bruit d’échantillonnage pourrait produire sous \(H_0: \mu_1 = \mu_2\).
tt <- t.test(life_exp ~ group, data = cs_t)   # Welch par défaut
tt
    Welch Two Sample t-test

data:  life_exp by group
t = 15.058, df = 81.75, p-value < 2.2e-16
alternative hypothesis: true difference in means between group Rest of the world and group Sub-Saharan Africa is not equal to 0
95 percent confidence interval:
 10.85315 14.15737
sample estimates:
 mean in group Rest of the world mean in group Sub-Saharan Africa
                        75.77300                         63.26774
gap <- unname(tt$estimate[1] - tt$estimate[2])Lecture. L’espérance de vie moyenne est de 75,8 ans dans le reste du monde et de 63,3 en Afrique subsaharienne : un écart de 12,5 ans (\(t\) = 15,1, p-valeur <1e-15). L’intervalle de confiance à 95 % de l’écart est [10,9 ; 14,2] ans. En clair : si l’on tirait de nombreuses fois de tels échantillons, les intervalles construits ainsi contiendraient le véritable écart dans 95 % des cas ; ici l’intervalle est loin de zéro.
Ce qu’une p-valeur n’est pas.
- Ce n’est pas la probabilité que \(H_0\) soit vraie. C’est la probabilité d’un écart au moins aussi grand si \(H_0\) était vraie.
- Ce n’est pas la taille de l’effet : avec de grands échantillons, des écarts triviaux obtiennent des p-valeurs minuscules. Regardez l’écart et l’intervalle de confiance.
- « Non significatif » ne veut pas dire « pas de différence » : il peut simplement s’agir d’une faible puissance.
- Elle ne dit rien sur pourquoi les groupes diffèrent.
AstuceExercice 4.5
- Testez si l’espérance de vie diffère entre les pays à revenu élevé et tous les autres (2019, une ligne par pays). Indiquez N dans chaque groupe, l’écart, l’IC à 95 % et votre interprétation. (b) Construisez un tableau
modelsummaryavec deux modèles de votre choix (par exemplelife_exp ~ log_gdp_pcetlife_exp ~ log_gdp_pc + elec_access) avec des erreurs-types robustes, une note définissant les étoiles et des noms de coefficients lisibles.
NoteAfficher la solution
# (a) revenu élevé contre le reste
cs_h <- cs |> mutate(group = if_else(income == "High income", "High income", "Other"))
count(cs_h, group)
# A tibble: 2 × 2
group n
<chr> <int>
1 High income 74
2 Other 124t.test(life_exp ~ group, data = cs_h)
    Welch Two Sample t-test

data:  life_exp by group
t = 13.633, df = 188.35, p-value < 2.2e-16
alternative hypothesis: true difference in means between group High income and group Other is not equal to 0
95 percent confidence interval:
  8.795007 11.770882
sample estimates:
mean in group High income       mean in group Other
                 79.37072                  69.08777
# (b) deux modèles dans un seul tableau
ma <- feols(life_exp ~ log_gdp_pc, data = cs, vcov = "hetero")
mb <- feols(life_exp ~ log_gdp_pc + elec_access, data = cs, vcov = "hetero")
modelsummary(
output = "gt", # un tableau gt : même aspect que les autres tableaux, sans script externe
fmt = \(x) nb(x, 3), # séparateur décimal de la langue de la page
list("(1)" = ma, "(2)" = mb),
coef_rename = c("log_gdp_pc" = "Log du PIB par habitant",
"elec_access" = "Accès à l'électricité (%)",
"(Intercept)" = "Constante"),
stars = c("*" = 0.1, "**" = 0.05, "***" = 0.01),
gof_map = c("nobs", "r.squared"),
notes = c("Variable dépendante : espérance de vie (ans). Erreurs-types robustes entre parenthèses.",
"* p < 0,1, ** p < 0,05, *** p < 0,01. Source : Banque mondiale, World Development Indicators (WDI), 2019.")
)| (1) | (2) | |
|---|---|---|
| Constante | 18,443*** | 23,408*** |
| (2,201) | (2,212) | |
| Log du PIB par habitant | 5,648*** | 4,441*** |
| (0,220) | (0,316) | |
| Accès à l'électricité (%) | 0,077*** | |
| (0,019) | ||
| Num.Obs. | 198 | 197 |
| R2 | 0.734 | 0.763 |
| * p < 0.1, ** p < 0.05, *** p < 0.01 | ||
| Variable dépendante : espérance de vie (ans). Erreurs-types robustes entre parenthèses. | ||
| * p < 0,1, ** p < 0,05, *** p < 0,01. Source : Banque mondiale, World Development Indicators (WDI), 2019. | ||
En (a), le groupe « High income » est le premier dans la sortie uniquement par ordre alphabétique ; lisez attentivement les deux moyennes pour obtenir le bon signe de l’écart.
À retenir
- Indiquez N partout ; connaissez votre unité d’observation (ici : un pays en 2019).
- Variables asymétriques : la moyenne est tirée par les extrêmes ; utilisez la médiane et les logarithmes. Le PIB par habitant s’analyse en logarithmes.
- \(r = \operatorname{cov}(X,Y)/(\sigma_X \sigma_Y)\) ne mesure que l’association linéaire : tracez d’abord.
- Dans une régression log-niveau, 1 % de PIB par habitant en plus va de pair avec \(\beta/100\) an en plus ; une hausse de 10 % avec \(\beta \times 0{,}0953\).
- Ajouter une variable comportant des valeurs manquantes change l’échantillon : comparez les modèles sur le même échantillon.
- Les coefficients de régression sont des associations ; les variables omises et la causalité inverse empêchent une lecture causale.
- Une p-valeur n’est pas la probabilité que \(H_0\) soit vraie, et ne dit rien de la taille d’un effet : lisez l’intervalle de confiance.
Suite : Séance 5, visualiser avec ggplot2.