Sys.setenv(LANGUAGE = "en")   # messages de R en anglais
library(tidyverse)   # readr, dplyr, ggplot2…
library(here)        # chemins relatifs au projet
library(janitor)     # clean_names()
library(readxl)      # lire des fichiers Excel
library(writexl)     # écrire des fichiers Excel
library(lubridate)   # dates
library(scales)      # label_dollar()
library(WDI)         # API de la Banque mondiale (utilisé dans un bloc non évalué)

source(here("R", "theme_cours.R"))Séance 2 : Importer et exporter des données
CSV, Excel, fichiers mal formatés, et données directement depuis la Banque mondiale
Objectifs de la séance
- Localiser des fichiers avec
here::here()plutôt qu’avecsetwd(). - Importer des fichiers CSV et Excel, et inspecter ce que vous avez importé.
- Gérer un fichier mal formaté : regarder d’abord le texte brut, puis vérifier
nrow()etproblems(). - Convertir du texte en nombres (
parse_number()), garder les codes en texte, nettoyer les libellés, et retrouver les valeurs manquantes créées par une conversion. - Facultatif : nettoyer des noms de pays et lire des dates avec
lubridate, puis retrouver les dates qui ont échoué. - Exporter des résultats vers
output/(CSV, Excel,.rds) sans toucher aux données brutes. - Récupérer des données de la Banque mondiale avec le package
WDI, et comprendre pourquoi on les met en cache.
Préparer votre session R
Packages utilisés aujourd’hui : tidyverse, here, janitor, readxl, writexl, lubridate, scales, WDI. S’il en manque un, lancez install.packages("name") dans la console.
Script de la séance : télécharger seance-2.R, tout le code de cette page dans un seul fichier.
Rythme. Le parcours principal dure environ 190 minutes, exercices compris. Les parties marquées Facultatif : pour aller plus loin (la section 6 sur le texte et les dates, la section 9, et les exercices 2.4, 2.5 et 2.7) ajoutent environ 45 minutes : faites-les si le temps le permet, ou chez vous.
1. Où sont mes fichiers ?
≈ 10 min Après cette section, vous saurez dire où se trouve un fichier et indiquer son chemin à R sans setwd().
Toute analyse de ce cours suit le même enchaînement : importer les données, les vérifier, les nettoyer, sauvegarder le résultat.
flowchart LR
    A[Fichier brut dans data/raw] --> B[Importer]
    B --> C[Vérifier]
    C --> D[Nettoyer]
    D --> E[Sauvegarder dans output]
À la dernière séance, vous avez travaillé dans un projet RStudio. Le dossier du projet est le répertoire de travail. Voici notre organisation :
r-course/
├── r-course.Rproj
├── data/          # les données fournies (de data.zip)
│   └── raw/       # fichiers originaux, LECTURE SEULE
├── R/
│   └── theme_cours.R   # thème graphique commun (de data.zip)
└── output/        # tout ce que VOUS produisez (tableaux, exports)
flowchart LR
P[r-course/] --> D[data/]
P --> R[R/]
P --> O[output/]
D --> RAW[data/raw/ lecture seule]
Règle : n’écrivez jamais dans data/. Si vous écrasez un fichier brut, l’original est perdu. Tout ce que vous créez va dans output/.
N’utilisez pas setwd("C:/Users/me/..."). Cela casse sur tous les autres ordinateurs. Utilisez here::here() : cette fonction construit un chemin à partir de la racine du projet, quelle que soit la machine.
# here("data", "raw", "SCIM.csv") renvoie le chemin complet sur votre machine,
# p. ex. "/home/you/r-course/data/raw/SCIM.csv" (non affiché ici)
file.exists(here("data", "raw", "SCIM.csv"))
[1] TRUEObtenir TRUE avec file.exists() est le premier test à faire quand un import échoue.
NoteEn clair
Un chemin est une adresse. setwd("C:/Users/me/...") revient à donner votre adresse personnelle à quelqu’un qui habite ailleurs. here() donne l’itinéraire depuis la porte d’entrée du projet, si bien que les mêmes indications fonctionnent sur tous les ordinateurs.
2. Fichiers CSV avec readr
≈ 30 min Après cette section, vous saurez lire un fichier CSV et dire d’un coup d’œil si R l’a bien compris.
Un fichier CSV (comma-separated values, valeurs séparées par des virgules) est un fichier texte brut : une ligne par observation, les valeurs étant séparées par un délimiteur. read_csv() devine le type de chaque colonne à partir des 1 000 premières lignes.
Nous utilisons SCIM.csv, des données de l’OCDE sur le commerce international (exportations, importations, solde commercial) par pays et par période.
scim <- read_csv(here("data", "raw", "SCIM.csv"))Quand vous lancez ceci dans la console, readr affiche le nombre de lignes et de colonnes ainsi que le type deviné pour chacune : lisez-le, c’est le contrôle le moins coûteux dont vous disposez (cette page masque ces messages). Regardons maintenant les données.
head(scim)# A tibble: 6 × 19
SUBJECT Sujet LOCATION Pays MEASURE Mesure FREQUENCY Fréquence TIME Temps
<chr> <chr> <chr> <chr> <chr> <chr> <chr> <chr> <chr> <chr>
1 XTEXVA01 Export… ISR Isra… CXMLSA Monna… Q Trimestr… 2022… T2-2…
2 XTEXVA01 Export… ISR Isra… CXMLSA Monna… Q Trimestr… 2022… T3-2…
3 XTEXVA01 Export… ISR Isra… CXMLSA Monna… Q Trimestr… 2022… T4-2…
4 XTEXVA01 Export… ISR Isra… CXMLSA Monna… Q Trimestr… 2023… T1-2…
5 XTEXVA01 Export… ISR Isra… CXMLSA Monna… Q Trimestr… 2023… T2-2…
6 XTEXVA01 Export… ISR Isra… CXMLSA Monna… Q Trimestr… 2023… T3-2…
# ℹ 9 more variables: `Unit Code` <chr>, Unit <chr>, `PowerCode Code` <dbl>,
# PowerCode <chr>, `Reference Period Code` <lgl>, `Reference Period` <lgl>,
# Value <dbl>, `Flag Codes` <lgl>, Flags <lgl>glimpse(scim)Rows: 20,580
Columns: 19
$ SUBJECT <chr> "XTEXVA01", "XTEXVA01", "XTEXVA01", "XTEXVA01"…
$ Sujet <chr> "Exportations des biens (en valeur)", "Exporta…
$ LOCATION <chr> "ISR", "ISR", "ISR", "ISR", "ISR", "ISR", "ZAF…
$ Pays <chr> "Israël", "Israël", "Israël", "Israël", "Israë…
$ MEASURE <chr> "CXMLSA", "CXMLSA", "CXMLSA", "CXMLSA", "CXMLS…
$ Mesure <chr> "Monnaie nationale convertie en dollars, corri…
$ FREQUENCY <chr> "Q", "Q", "Q", "Q", "Q", "Q", "Q", "Q", "Q", "…
$ Fréquence <chr> "Trimestrielle", "Trimestrielle", "Trimestriel…
$ TIME <chr> "2022-Q2", "2022-Q3", "2022-Q4", "2023-Q1", "2…
$ Temps <chr> "T2-2022", "T3-2022", "T4-2022", "T1-2023", "T…
$ `Unit Code` <chr> "USD", "USD", "USD", "USD", "USD", "USD", "USD…
$ Unit <chr> "Dollar des États-Unis", "Dollar des États-Uni…
$ `PowerCode Code` <dbl> 9, 9, 9, 9, 9, 9, 9, 9, 9, 9, 9, 9, 9, 9, 9, 9…
$ PowerCode <chr> "Milliards", "Milliards", "Milliards", "Millia…
$ `Reference Period Code` <lgl> NA, NA, NA, NA, NA, NA, NA, NA, NA, NA, NA, NA…
$ `Reference Period` <lgl> NA, NA, NA, NA, NA, NA, NA, NA, NA, NA, NA, NA…
$ Value <dbl> 17.196020, 17.218710, 16.495160, 14.000260, 15…
$ `Flag Codes` <lgl> NA, NA, NA, NA, NA, NA, NA, NA, NA, NA, NA, NA…
$ Flags <lgl> NA, NA, NA, NA, NA, NA, NA, NA, NA, NA, NA, NA…
ImportantIdée clé
Un import qui s’exécute sans erreur n’est pas un import qui a fonctionné. Regardez toujours le résultat (glimpse(), nrow()) avant de l’utiliser.
glimpse() affiche chaque colonne sur une ligne avec son type : utilisez-le plus que head(). summary() donne des résumés numériques :
summary(scim$Value) Min. 1st Qu. Median Mean 3rd Qu. Max.
-28821.12 -0.25 8.15 3878.63 55.73 1167777.00 Ce résumé n’a aucun sens, et R ne vous prévient pas : Value mélange des dollars américains, des monnaies nationales et des variations en pourcentage, tantôt mensuelles, tantôt trimestrielles. Le maximum, 1 167 777, est le commerce trimestriel de l’Indonésie en milliards de roupies. Nous le vérifions plus bas avec count().
Qu’observe-t-on ?
- Les noms de colonnes mélangent majuscules et minuscules et contiennent des espaces (
"Unit Code","Reference Period"). C’est pénible à saisir, car il faut des backticks. - Les colonnes vont par paires français/anglais (
SUBJECT/Sujet,LOCATION/Pays,MEASURE/Mesure,TIME/Temps) : la même information en double. -
TIMEest une colonne de texte qui mélange des mois ("2022-04") et des trimestres ("2022-Q2").
janitor::clean_names() transforme les noms en snake_case cohérent :
scim <- clean_names(scim)
names(scim)
[1] "subject" "sujet" "location"
[4] "pays" "measure" "mesure"
[7] "frequency" "frequence" "time"
[10] "temps" "unit_code" "unit"
[13] "power_code_code" "power_code" "reference_period_code"
[16] "reference_period" "value" "flag_codes"
[19] "flags"
NoteAperçu : les verbes de dplyr
select(), filter(), count(), distinct(), mutate(), slice_max() et summarise() sont enseignés à la séance 3 (ggplot à la séance 5). Pour l’instant, recopiez simplement le schéma.
Supprimons les doublons en français et les colonnes inutiles, mais gardons unit_code et frequency, puis comptons ce qui reste :
scim <- scim |>
  select(subject, location, measure, frequency, time, unit_code, value)

scim |> count(subject)
# A tibble: 3 × 2
subject n
<chr> <int>
1 XTEXVA01 7738
2 XTIMVA01 7726
3 XTNTVA01 5116scim |> count(measure, unit_code, frequency)# A tibble: 12 × 4
measure unit_code frequency n
<chr> <chr> <chr> <int>
1 CXML USD M 2986
2 CXML USD Q 931
3 CXMLSA USD M 2986
4 CXMLSA USD Q 931
5 GPSA PC M 1991
6 GPSA PC Q 621
7 GYSA PC M 1991
8 GYSA PC Q 621
9 NCML NATCUR M 2866
10 NCML NATCUR Q 895
11 NCMLSA NATCUR M 2866
12 NCMLSA NATCUR Q 895Les trois sujets sont les exportations (XTEXVA01), les importations (XTIMVA01) et le commerce net (XTNTVA01). Le second comptage montre pourquoi nous avons gardé unit_code et frequency : CXML et CXMLSA sont en dollars américains, NCML et NCMLSA en monnaie nationale, GPSA et GYSA sont des variations en pourcentage (par rapport à la période précédente et sur un an), et chacune existe en mensuel (M) et en trimestriel (Q). Avant tout calcul sur value, gardez une seule mesure et une seule fréquence.
Aperçu : les dates. time est du texte, donc R ne peut ni le trier ni le représenter comme une date. lubridate::yq() convertit "2022-Q2" en premier jour de ce trimestre (le chapitre Dates and times de R for Data Science, en anglais, va plus loin, de même que la section 6) :
scim |>
  filter(str_detect(time, "Q")) |>
  distinct(time) |>
  mutate(date = yq(time))
# A tibble: 7 × 2
time date
<chr> <date>
1 2022-Q2 2022-04-01
2 2022-Q3 2022-07-01
3 2022-Q4 2022-10-01
4 2023-Q1 2023-01-01
5 2023-Q2 2023-04-01
6 2023-Q3 2023-07-01
7 2023-Q4 2023-10-01
AvertissementErreur fréquente
Ouvrir un CSV dans Excel puis le réenregistrer peut transformer des codes en dates (le gène SEPT2 devient « 2-Sep », le code 1-3 devient une date) ou changer le séparateur décimal : dans un Excel en français, 3,5 signifie 3,5, mais read_csv() attend un point. Vérifiez avec glimpse() : une colonne numérique lue comme <chr> est le symptôme habituel. Corrigez à la source ou avec read_csv2() (séparateur point-virgule, virgule décimale). Des caractères accentués transformés en é signalent un mauvais encodage : ajoutez locale = locale(encoding = "latin1") (ou "UTF-8").
3. Fichiers Excel avec readxl
≈ 20 min Après cette section, vous saurez lister les feuilles d’un classeur et lire une feuille, ou une partie de feuille.
read_excel() lit les fichiers .xls et .xlsx. Un fichier Excel peut contenir plusieurs feuilles, il faut donc d’abord les lister :
path_xlsx <- here("data", "raw", "SCIM.xlsx")
excel_sheets(path_xlsx)
[1] "Sheet1" "Feuil2"Deux feuilles. Par défaut, read_excel() lit la première. Choisissez une feuille par son nom ou sa position avec sheet =. Les fichiers créés avec un Excel en français ont souvent des noms de feuilles en français (Feuil1, Feuil2) et des noms de colonnes avec accents ou tirets (Août-2022) ; R exige des backticks autour de tels noms.
scim_xlsx <- read_excel(path_xlsx, sheet = "Sheet1")
dim(scim_xlsx)
[1] 50 18scim_xlsx[1:5, 1:6]# A tibble: 5 × 6
Pays `Août-2022` `Sept-2022` `Oct-2022` `Nov-2022` `Déc-2022`
<chr> <dbl> <dbl> <dbl> <dbl> <dbl>
1 Australie 35.2 36.0 33.9 34.3 35.0
2 Autriche 17.3 17.2 16.9 18.0 18.0
3 Belgique 55.1 54.2 51.0 55.0 53.2
4 Canada 50.9 49.6 48.5 47.6 47.8
5 Chili 8.07 8.34 8.47 8.13 8.43Ce fichier n’est pas identique au CSV : il est en format large (une colonne par mois, une ligne par pays), et les noms des mois sont en français. Et la deuxième feuille ?
dim(read_excel(path_xlsx, sheet = "Feuil2"))[1] 0 0Elle est vide (0 ligne, 0 colonne) ; Feuil2 est le nom par défaut français de « Sheet 2 ». Leçon : ne présumez jamais du contenu d’une feuille.
Pour ne lire qu’une partie d’une feuille, utilisez range = (notation Excel) :
read_excel(path_xlsx, sheet = "Sheet1", range = "A1:D6")# A tibble: 5 × 4
Pays `Août-2022` `Sept-2022` `Oct-2022`
<chr> <dbl> <dbl> <dbl>
1 Australie 35.2 36.0 33.9
2 Autriche 17.3 17.2 16.9
3 Belgique 55.1 54.2 51.0
4 Canada 50.9 49.6 48.5
5 Chili 8.07 8.34 8.474. Un import difficile : le fichier WID
≈ 35 min Après cette section, vous saurez importer un fichier mal formé et prouver, chiffres à l’appui, que l’import est correct.
Les vrais fichiers sont rarement propres. WID_Data.csv provient de la World Inequality Database (en anglais) : coefficients de Gini du revenu national avant impôt pour la Chine, l’Inde et les États-Unis. Avant d’exécuter le moindre code, regardez le texte brut :
readLines(here("data", "raw", "WID_Data.csv"), n = 9)[1] "Downloaded from wid.world on 08-08-2024 at 09:28:58"
[2] "China;\"gptinc_pall_992_j_CN"
[3] "Pre-tax national income "
[4] "Total population | Gini coefficient | adults | equal split"
[5] "\";pall;2000;0.49796440218"
[6] "China;\"gptinc_pall_992_j_CN"
[7] "Pre-tax national income "
[8] "Total population | Gini coefficient | adults | equal split"
[9] "\";pall;2001;0.507249422709" Trois problèmes :
- La première ligne est un commentaire (« Downloaded from wid.world… »), pas un en-tête.
- Le séparateur est
;, pas,. - Le libellé de la variable est réparti sur plusieurs lignes entre guillemets, et il n’y a pas de ligne d’en-tête.
Un read_csv() naïf n’échoue pas bruyamment. Il renvoie quelque chose :
wid_naive <- read_csv(here("data", "raw", "WID_Data.csv"))   # tentative naïve
dim(wid_naive)
[1] 190 1head(wid_naive, 3)# A tibble: 3 × 1
`Downloaded from wid.world on 08-08-2024 at 09:28:58`
<chr>
1 "China;\"gptinc_pall_992_j_CN"
2 "Pre-tax national income"
3 "Total population | Gini coefficient | adults | equal split"Une seule colonne, 190 « lignes » qui sont des fragments de texte, et la ligne de commentaire est devenue le nom de colonne. Nous savons que le fichier contient 3 pays × 21 années = 63 observations, donc 190 est faux. problems() liste les cellules que readr n’a pas pu analyser ; ici il n’en signale qu’une, ce qui ne suffit pas : c’est votre propre contrôle avec nrow() qui détecte l’erreur.
problems(wid_naive) |> select(-file) # masquer le long chemin# A tibble: 1 × 4
row col expected actual
<int> <int> <chr> <chr>
1 191 1 closing quote end of file
NoteEn clair
read_csv() est un touriste muni d’un guide de conversation pour une seule langue. Face à un fichier dont la « grammaire » est différente (séparateur ;, un commentaire en ligne 1), il ne s’arrête pas : il invente une lecture. Vous êtes l’interprète : regardez le texte brut, puis énoncez à readr les règles.
Lisons-le maintenant correctement : sautons la ligne de commentaire, indiquons que le délimiteur est ;, et fournissons nous-mêmes les noms de colonnes.
wid <- read_delim(
  here("data", "raw", "WID_Data.csv"),
  delim = ";",
  skip = 1,                                   # la ligne de commentaire
  col_names = c("country_wid", "indicator", "percentile", "year", "gini"),
  show_col_types = FALSE
)
nrow(wid)
[1] 63glimpse(wid)Rows: 63
Columns: 5
$ country_wid <chr> "China", "China", "China", "China", "China", "China", "Chi…
$ indicator <chr> "gptinc_pall_992_j_CN\nPre-tax national income \nTotal pop…
$ percentile <chr> "pall", "pall", "pall", "pall", "pall", "pall", "pall", "p…
$ year <dbl> 2000, 2001, 2002, 2003, 2004, 2005, 2006, 2007, 2008, 2009…
$ gini <dbl> 0.4979644, 0.5072494, 0.5345691, 0.5428115, 0.5460035, 0.5…63 lignes, comme prévu. Côte à côte, le résultat naïf et le résultat correct :
# A tibble: 4 × 1
  comment_line_as_name
  <chr>
1 "China;\"gptinc_pall_992_j_CN"
2 "Pre-tax national income"
3 "Total population | Gini coefficient …
4 ";pall;2000;0.49796440218\nChina;gpti…
# A tibble: 4 × 3
country_wid year gini
<chr> <dbl> <dbl>
1 China 2000 0.498
2 China 2001 0.507
3 China 2002 0.535
4 China 2003 0.543Le libellé sur plusieurs lignes se retrouve dans indicator : un texte entre guillemets peut contenir des retours à la ligne, et readr sait les gérer. Comparez avec la version nettoyée data/wid_gini.csv préparée pour ce cours :
wid_gini <- read_csv(here("data", "wid_gini.csv"), show_col_types = FALSE)
glimpse(wid_gini)
Rows: 63
Columns: 4
$ iso3c <chr> "CHN", "CHN", "CHN", "CHN", "CHN", "CHN", "CHN", "CHN", "C…
$ country_wid <chr> "China", "China", "China", "China", "China", "China", "Chi…
$ year <dbl> 2000, 2001, 2002, 2003, 2004, 2005, 2006, 2007, 2008, 2009…
$ gini <dbl> 0.4979644, 0.5072494, 0.5345691, 0.5428115, 0.5460035, 0.5…# Mêmes chiffres ? (le fichier nettoyé a en plus un code iso3c)
all.equal(wid$gini, wid_gini$gini)[1] TRUEUn graphique est aussi un contrôle : si l’import est correct, les séries doivent ressembler à des données d’inégalités, et non à du bruit. Voici l’indice de Gini du WID (0 = égalité parfaite, 1 = une seule personne reçoit tout le revenu) une fois correctement importé.
Afficher le code du graphique (enseigné à la séance 5)
ggplot(wid_gini, aes(x = year, y = gini, colour = iso3c)) +
  geom_line(linewidth = 1) +
  scale_colour_manual(values = c(CHN = pal_cours[["accent"]],
                                 IND = "#E69F00",
                                 USA = pal_cours[["principal"]])) +
  labs(
    title = str_wrap("Les inégalités de revenu ont augmenté en Chine, en Inde et aux États-Unis, 2000-2020", 60),
    x = NULL, y = "Indice de Gini (0-1)", colour = NULL,
    caption = str_wrap("Source : World Inequality Database (WID), revenu national avant impôt.", 95)
  )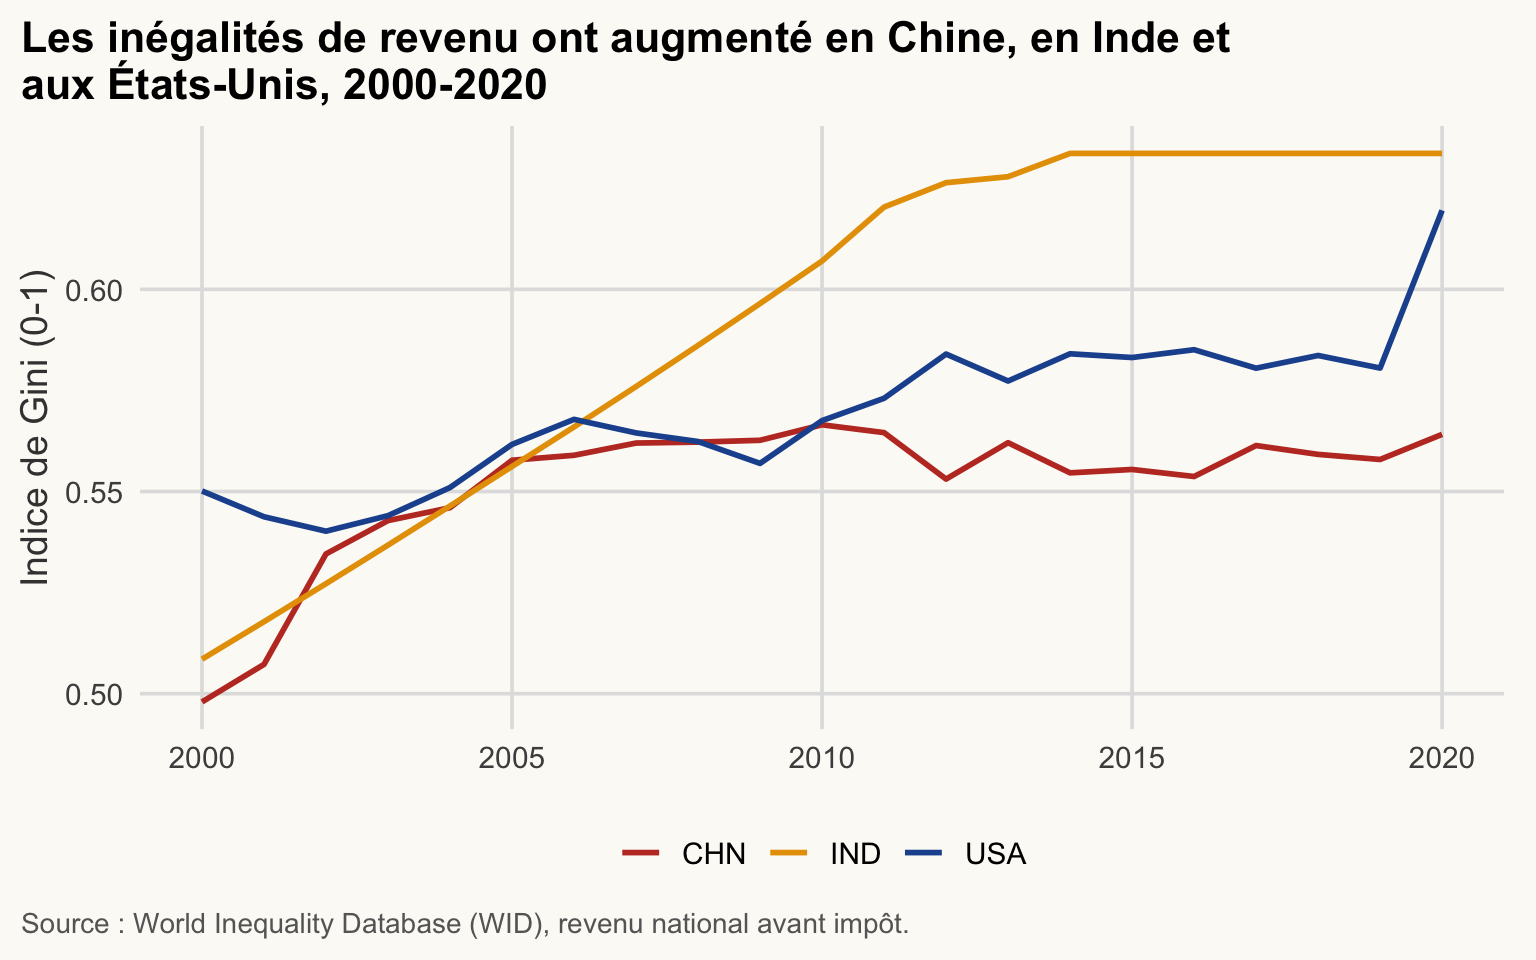
Lisez ce graphique comme un contrôle, pas seulement comme un résultat. La courbe de l’Inde est presque droite de 2000 à 2011 (environ +0,01 par an), puis parfaitement plate de 2014 à 2020 (0,634 chaque année) : ce sont des interpolations du WID, pas des mesures annuelles, car l’Inde dispose de peu d’enquêtes. Le saut des États-Unis en 2020 (de 0,58 à 0,62) mérite aussi un examen. Consultez les métadonnées du WID avant de lire des variations d’une année sur l’autre.
ImportantLa liste de contrôle pour tout nouveau fichier
- Ouvrez le texte brut (
readLines(path, n = 10)) avant de le lire. - Après l’import :
nrow(),ncol(),glimpse(): correspondent-ils à ce que vous attendez ? -
problems(x)liste les cellules quereadrn’a pas pu analyser. - Vérifiez les valeurs manquantes et les types (
summary()).
Le fichier nettoyé comporte un code iso3c (code pays). Remarquez que le WID écrit "USA" là où la Banque mondiale écrit "United States" : les noms de pays diffèrent selon les sources. Nous verrons à la séance 3 pourquoi il faut faire les jointures sur les codes, jamais sur les noms.
5. Convertir et nettoyer des valeurs
≈ 20 min Après cette section, vous saurez transformer du texte en nombres, garder les codes en texte, nettoyer des libellés, et retrouver les valeurs qu’une conversion a perdues.
glimpse() vous dit qu’une colonne n’a pas le bon type. Cette section apprend à la corriger, et à vérifier la correction. Nous utilisons repair_me.csv : de vraies valeurs de la Banque mondiale pour six pays en 2015 et 2019, avec des problèmes placés exprès. Vous le réparerez entièrement à la séance 3 ; ici, on s’exerce à une correction à la fois.
repair <- read_csv(here("data", "raw", "repair_me.csv"), show_col_types = FALSE)
glimpse(repair)
Rows: 13
Columns: 5
$ country <chr> "Afghanistan", "Afghanistan", "Angola", "Angola", "Banglade…
$ iso_num <chr> "004", "004", "024", "024", "050", "050", "204", "204", "28…
$ year <dbl> 2015, 2019, 2015, 2019, 2015, 2019, 2015, 2019, 2015, 2019,…
$ gdp_pc_ppp <dbl> 2967.7, 2927.2, 11389.8, 9713.0, 5352.7, 6838.3, 2952.0, 32…
$ life_exp <chr> "62.3", "62.9", "61", "63.1", "70.5", "72.6", "n/a", "59.9"…Lisez les types. gdp_pc_ppp est <dbl> : readr a compris que "2,967.7" est un nombre avec un séparateur de milliers. iso_num est <chr> et garde "004". Mais life_exp est <chr> : au moins une de ses valeurs n’est pas un nombre. Nous y revenons à la fin.
Des nombres stockés en texte
Tous les outils ne sont pas aussi serviables que readr. La fonction read.csv() de R de base, que vous croiserez dans beaucoup de réponses en ligne, lit le même fichier autrement :
repair_base <- read.csv(here("data", "raw", "repair_me.csv"))
str(repair_base)
'data.frame': 13 obs. of 5 variables:
$ country : chr "Afghanistan" "Afghanistan" "Angola" "Angola" ...
$ iso_num : int 4 4 24 24 50 50 204 204 288 288 ...
$ year : int 2015 2019 2015 2019 2015 2019 2015 2019 2015 2019 ...
$ gdp_pc_ppp: chr "2,967.7" "2,927.2" "11,389.8" "9,713.0" ...
$ life_exp : chr "62.3" "62.9" "61" "63.1" ...gdp_pc_ppp est maintenant du texte (chr). Le réflexe as.numeric() échoue sur toutes les valeurs, à cause de la virgule :
as.numeric(repair_base$gdp_pc_ppp)Warning: NAs introduced by coercion [1] NA NA NA NA NA NA NA NA NA NA NA NA NATreize NA et un avertissement : NAs introduced by coercion (« des NA ont été introduits lors de la conversion »). readr::parse_number() enlève le séparateur de milliers, ainsi que tout texte autour du nombre :
parse_number(repair_base$gdp_pc_ppp) [1] 2967.7 2927.2 11389.8 9713.0 5352.7 6838.3 2952.0 3281.1 5607.4
[10] 6508.2 4679.6 5171.7 6508.2
AvertissementErreur fréquente
parse_number() garde le premier nombre qu’elle trouve et jette tout le reste : "12 km" et "12 miles" deviennent tous deux 12. Regardez le texte avant de le convertir. Pour des nombres à la française ("2.967,7" ou "2 967,7"), indiquez quel signe joue quel rôle avec locale = :
parse_number("12 km")[1] 12parse_number("2.967,7", locale = locale(decimal_mark = ",", grouping_mark = "."))[1] 2967.7Des codes qui doivent rester du texte
iso_num est le code pays numérique ISO : l’Afghanistan est "004". Un code est une étiquette, pas une quantité : on n’additionne jamais deux codes, mais on fait des jointures dessus. read.csv() l’a transformé en nombre, et les zéros ont disparu :
repair_base$iso_num [1] 4 4 24 24 50 50 204 204 288 288 404 404 2884 ne correspondra jamais à "004" dans un autre fichier. Avec readr, déclarez le type au lieu de faire confiance à la devinette :
repair_codes <- read_csv(here("data", "raw", "repair_me.csv"),
                         col_types = cols(iso_num = col_character()))
repair_codes$iso_num
[1] "004" "004" "024" "024" "050" "050" "204" "204" "288" "288" "404" "404"
[13] "288"Ici, la devinette était déjà juste (la version de readr utilisée pour cette page garde en texte les valeurs qui commencent par des zéros), mais une devinette dépend de la version et des 1000 premières lignes. col_types = écrit la règle noir sur blanc : le même script donne le même résultat sur tous les ordinateurs.
Espaces et majuscules dans les libellés
read_csv() enlève sans rien dire les espaces au début et à la fin de chaque valeur (son argument trim_ws = TRUE) ; read.csv() les garde. unique() affiche chaque valeur entre guillemets, ce qui permet de les voir :
unique(repair$country) # read_csv() : espaces enlevées, reste la casse[1] "Afghanistan" "Angola" "Bangladesh" "Benin" "Ghana"
[6] "kenya" "KENYA" unique(repair_base$country) # read.csv() : les deux problèmes[1] "Afghanistan" "Angola" "Bangladesh" "Benin" "Ghana"
[6] " kenya" "KENYA " Pour R, " kenya" et "KENYA " sont deux pays différents, et aucun des deux n’est "Kenya". str_squish() enlève les espaces aux deux bouts (et les espaces doublées à l’intérieur) ; str_to_title() met une majuscule au début de chaque mot :
str_squish(c(" kenya", "KENYA ", "Burkina Faso"))[1] "kenya" "KENYA" "Burkina Faso"unique(str_to_title(str_squish(repair_base$country)))[1] "Afghanistan" "Angola" "Bangladesh" "Benin" "Ghana"
[6] "Kenya" Six noms pour six pays. (Nous nous contentons d’afficher le résultat : le tableau lui-même sera réparé à la séance 3.)
AvertissementErreur fréquente
Appliquer str_to_title() à des noms qui étaient déjà corrects. Elle ne connaît pas les noms de pays :
str_to_title(c("Côte d'Ivoire", "United States of America"))[1] "Côte D'ivoire" "United States Of America"Vérifiez avec unique() après chaque étape de nettoyage, et corrigez les exceptions une par une (la section 6 montre comment). Mieux encore : associez les pays par leurs codes, pas par leurs noms.
Des valeurs manquantes créées par une conversion
Revenons à life_exp. Comptez les valeurs manquantes avant et après la conversion :
sum(is.na(repair$life_exp)) # avant[1] 0life_num <- as.numeric(repair$life_exp)Warning: NAs introduced by coercionsum(is.na(life_num)) # après[1] 1Un NA est apparu, qui n’était pas dans le fichier. Pour le retrouver, gardez les lignes où le texte était présent mais où le nombre manque :
repair |>
  mutate(life_num = as.numeric(life_exp)) |>
  filter(!is.na(life_exp), is.na(life_num)) |>
  select(country, year, life_exp, life_num)
# A tibble: 1 × 4
country year life_exp life_num
<chr> <dbl> <chr> <dbl>
1 Benin 2015 n/a NALe Bénin 2015 est écrit "n/a". Il faut maintenant décider. S’il s’agissait d’une faute de frappe ("6l.2"), vous chercheriez la bonne valeur à la source. Ici, "n/a" est la façon dont le fournisseur écrit « manquant » : déclarez-le à l’import avec na = :
repair_na <- read_csv(here("data", "raw", "repair_me.csv"),
                      na = c("", "NA", "n/a"), show_col_types = FALSE)
class(repair_na$life_exp)
[1] "numeric"sum(is.na(repair_na$life_exp))[1] 1life_exp est maintenant numérique, avec un seul NA, que nous avons choisi. na = remplace la valeur par défaut c("", "NA") : gardez ces deux-là dans la liste.
ImportantIdée clé
Une conversion peut transformer une valeur en NA avec un simple avertissement, ou sans rien dire. Comptez les NA avant et après chaque conversion : chaque nouveau NA doit avoir une explication.
Le fichier contient encore un problème auquel nous n’avons pas touché ; l’exercice « Réparer cette analyse » de la séance 3 réunit toutes les corrections. Entraînez-vous dès maintenant avec l’exercice 2.6.
6. Texte et dates : un petit exemple complet (Facultatif : pour aller plus loin)
≈ 20 min Après cette section, vous saurez harmoniser des noms de pays, transformer du texte en vraies dates, et retrouver les dates qui ont échoué.
Cette section n’est pas nécessaire pour les séances suivantes : faites-la si vous finissez en avance, ou chez vous. Les données annuelles du WDI n’ont pas de dates, mais les données d’enquête en ont. Voici un petit tableau d’entretiens auprès de ménages, saisis par différents enquêteurs :
interviews <- tibble(
  country   = c("Senegal", "senegal ", "Côte d'Ivoire", "Cote d'Ivoire", "IVORY COAST", " Ghana"),
  interview = c("15/03/2019", "02/11/2019", "30/06/2020", "31/02/2020", "14/07/2020", "03/12/2019")
)
interviews
# A tibble: 6 × 2
country interview
<chr> <chr>
1 "Senegal" 15/03/2019
2 "senegal " 02/11/2019
3 "Côte d'Ivoire" 30/06/2020
4 "Cote d'Ivoire" 31/02/2020
5 "IVORY COAST" 14/07/2020
6 " Ghana" 03/12/2019Les libellés. D’abord les deux étapes de la section 5, les espaces puis la casse. Ensuite, un seul case_when() (vu à la séance 3 : lisez-le comme « si … alors … ») regroupe les variantes de nom, y compris celle que str_to_title() a abîmée :
interviews <- interviews |>
  mutate(
    country = str_to_title(str_squish(country)),
    country = case_when(
      country %in% c("Côte D'ivoire", "Cote D'ivoire", "Ivory Coast") ~ "Côte d'Ivoire",
      .default = country   # tous les autres libellés restent tels quels
    )
  )
count(interviews, country)
# A tibble: 3 × 2
country n
<chr> <int>
1 Côte d'Ivoire 3
2 Ghana 1
3 Senegal 2Trois pays, comme prévu.
Les dates. À la section 2, yq() a transformé "2022-Q2" en date. Chaque fonction de lecture de lubridate porte le nom de l’ordre des éléments dans le texte : y pour l’année (year), m le mois, d le jour (day), q le trimestre (quarter).
ymd("2019-03-15")[1] "2019-03-15"dmy("15/03/2019")[1] "2019-03-15"my("03/2019")[1] "2019-03-01"yq("2019-Q1")[1] "2019-01-01"Les quatre renvoient une Date. Nos entretiens sont écrits jour/mois/année, donc on utilise dmy(), puis on extrait l’année avec year() :
interviews <- interviews |>
  mutate(date = dmy(interview), year = year(date))
Warning: There was 1 warning in `mutate()`.
ℹ In argument: `date = dmy(interview)`.
Caused by warning:
! 1 failed to parse.interviews# A tibble: 6 × 4
country interview date year
<chr> <chr> <date> <dbl>
1 Senegal 15/03/2019 2019-03-15 2019
2 Senegal 02/11/2019 2019-11-02 2019
3 Côte d'Ivoire 30/06/2020 2020-06-30 2020
4 Côte d'Ivoire 31/02/2020 NA NA
5 Côte d'Ivoire 14/07/2020 2020-07-14 2020
6 Ghana 03/12/2019 2019-12-03 2019L’avertissement 1 failed to parse (« 1 valeur n’a pas pu être lue ») signifie qu’un texte n’a pas pu être lu comme une date. Comme à la section 5, retrouvez-le avec is.na() :
interviews |> filter(is.na(date))# A tibble: 1 × 4
country interview date year
<chr> <chr> <date> <dbl>
1 Côte d'Ivoire 31/02/2020 NA NALe 31 février n’existe pas : c’est une erreur de saisie. Ne devinez pas le bon jour ; demandez à la source (questionnaire, équipe d’enquête), ou gardez le NA et signalez-le.
AvertissementErreur fréquente
"02/11/2019" est le 2 novembre avec dmy(), mais le 11 février avec mdy(), et les deux s’exécutent sans aucun avertissement. lubridate ne peut pas savoir quelle convention la source a suivie : lisez sa documentation (les sources américaines mettent souvent le mois en premier), et vérifiez que range(interviews$date, na.rm = TRUE) tombe bien dans la période de collecte.
Entraînez-vous avec l’exercice 2.7 (facultatif).
7. Écrire des fichiers
≈ 25 min Après cette section, vous saurez sauvegarder un résultat dans le format qui convient à son destinataire.
Créez le dossier output/ (rien ne se passe s’il existe déjà), puis écrivez-y.
dir.create(here("output"), showWarnings = FALSE)Fichiers texte. write_csv() écrit un fichier séparé par des virgules, write_delim() n’importe quel délimiteur :
write_csv(wid_gini, here("output", "wid_gini_copy.csv"))
write_delim(wid_gini, here("output", "wid_gini_tab.txt"), delim = "\t")
Excel. writexl::write_xlsx() écrit une feuille à partir d’un data frame, ou plusieurs feuilles à partir d’une liste nommée ; les noms deviennent les noms des feuilles :
write_xlsx(wid_gini, here("output", "wid_gini.xlsx"))

write_xlsx(
  list(wid_clean = wid_gini, scim_sample = head(scim, 100)),
  here("output", "two_sheets.xlsx")
)
excel_sheets(here("output", "two_sheets.xlsx"))
[1] "wid_clean" "scim_sample"Le format propre à R : .rds. Un CSV perd de l’information (types de colonnes, niveaux des facteurs). saveRDS() stocke un objet R exactement tel qu’il est ; readRDS() le restaure.
saveRDS(wid_gini, here("output", "wid_gini.rds"))
wid_back <- readRDS(here("output", "wid_gini.rds"))
all.equal(wid_gini, wid_back)   # TRUE : mêmes valeurs, types et noms
[1] TRUE
ImportantIdée clé
Vos données brutes ne changent jamais ; vos résultats peuvent toujours être régénérés en relançant le script. Si vous pouvez supprimer output/ et le reconstruire, votre travail est reproductible.
Quel format utiliser, et quand ?
| Format | À utiliser quand |
|---|---|
.csv |
vous partagez avec d’autres personnes ou d’autres logiciels ; le fichier doit être lisible partout |
.xlsx |
le destinataire travaille dans Excel (plusieurs tableaux dans un seul fichier) |
.rds |
vous voulez recharger l’objet dans R exactement tel qu’il était (résultats intermédiaires) |
8. Données issues de packages : la Banque mondiale
≈ 25 min Après cette section, vous saurez récupérer des données de la Banque mondiale avec WDI() et expliquer pourquoi nous lisons une copie en cache.
De nombreuses institutions fournissent un package R pour récupérer directement leurs données. Le package WDI interroge les World Development Indicators (indicateurs du développement dans le monde) de la Banque mondiale. Chaque indicateur a un code, p. ex. NY.GDP.MKTP.CD = PIB en dollars américains courants. Trouvez un code avec WDIsearch() :
WDIsearch("gdp per capita") # nécessite InternetRécupérer le PIB des États-Unis, de la Chine et de l’Inde se présente ainsi :
gdp_api <- WDI(
  country   = c("US", "CN", "IN"),     # codes ISO-2
  indicator = c(gdp = "NY.GDP.MKTP.CD"),  # nouveau_nom = code de l'indicateur
  start = 2000, end = 2020
)
Ce bloc n’est pas évalué lors de la construction de cette page : il nécessite une connexion Internet, et le serveur de la Banque mondiale peut être lent ou modifier ses données. À la place, le cours utilise une copie en cache enregistrée une fois pour toutes par R/00_prepare_data.R.
NotePourquoi mettre des données en cache ?
- Reproductibilité : la Banque mondiale révise ses séries. L’appel d’aujourd’hui peut donner des chiffres différents de ceux de l’an dernier.
- Robustesse : pas d’Internet, pas de téléchargement, pas d’échec. Le Wi-Fi de la salle n’est pas une dépendance.
- Rapidité : appeler une API à chaque exécution est lent.
Bonne pratique : récupérer une fois, sauvegarder le fichier dans votre projet, lire ensuite ce fichier, et noter la date de téléchargement.
wdi3 <- read_csv(here("data", "wdi_3countries.csv"), show_col_types = FALSE)
glimpse(wdi3)
Rows: 63
Columns: 4
$ country <chr> "China", "China", "China", "China", "China", "China", "China",…
$ iso3c <chr> "CHN", "CHN", "CHN", "CHN", "CHN", "CHN", "CHN", "CHN", "CHN",…
$ year <dbl> 2000, 2001, 2002, 2003, 2004, 2005, 2006, 2007, 2008, 2009, 20…
$ gdp <dbl> 1.223755e+12, 1.355037e+12, 1.489822e+12, 1.683903e+12, 1.9841…Nous disposons aussi d’un panel plus large : tous les pays, 2000–2023, six indicateurs. Ce sera notre jeu de données principal à partir de la séance 3.
wdi_panel <- read_csv(here("data", "wdi_panel.csv"), show_col_types = FALSE)
glimpse(wdi_panel)
Rows: 5,208
Columns: 11
$ country <chr> "Afghanistan", "Afghanistan", "Afghanistan", "Afghanistan"…
$ iso3c <chr> "AFG", "AFG", "AFG", "AFG", "AFG", "AFG", "AFG", "AFG", "A…
$ year <dbl> 2000, 2001, 2002, 2003, 2004, 2005, 2006, 2007, 2008, 2009…
$ region <chr> "Middle East, North Africa, Afghanistan & Pakistan", "Midd…
$ income <chr> "Low income", "Low income", "Low income", "Low income", "L…
$ gdp <dbl> 3521418060, 2813571754, 3825701439, 4520946819, 5224896719…
$ gdp_pc_ppp <dbl> 1617.826, 1454.111, 1774.309, 1815.928, 1776.918, 1908.115…
$ population <dbl> 20130327, 20284307, 21378117, 22733049, 23560654, 24404567…
$ life_exp <dbl> 55.005, 55.511, 56.225, 57.171, 57.810, 58.247, 58.553, 58…
$ gini <dbl> NA, NA, NA, NA, NA, NA, NA, NA, NA, NA, NA, NA, NA, NA, NA…
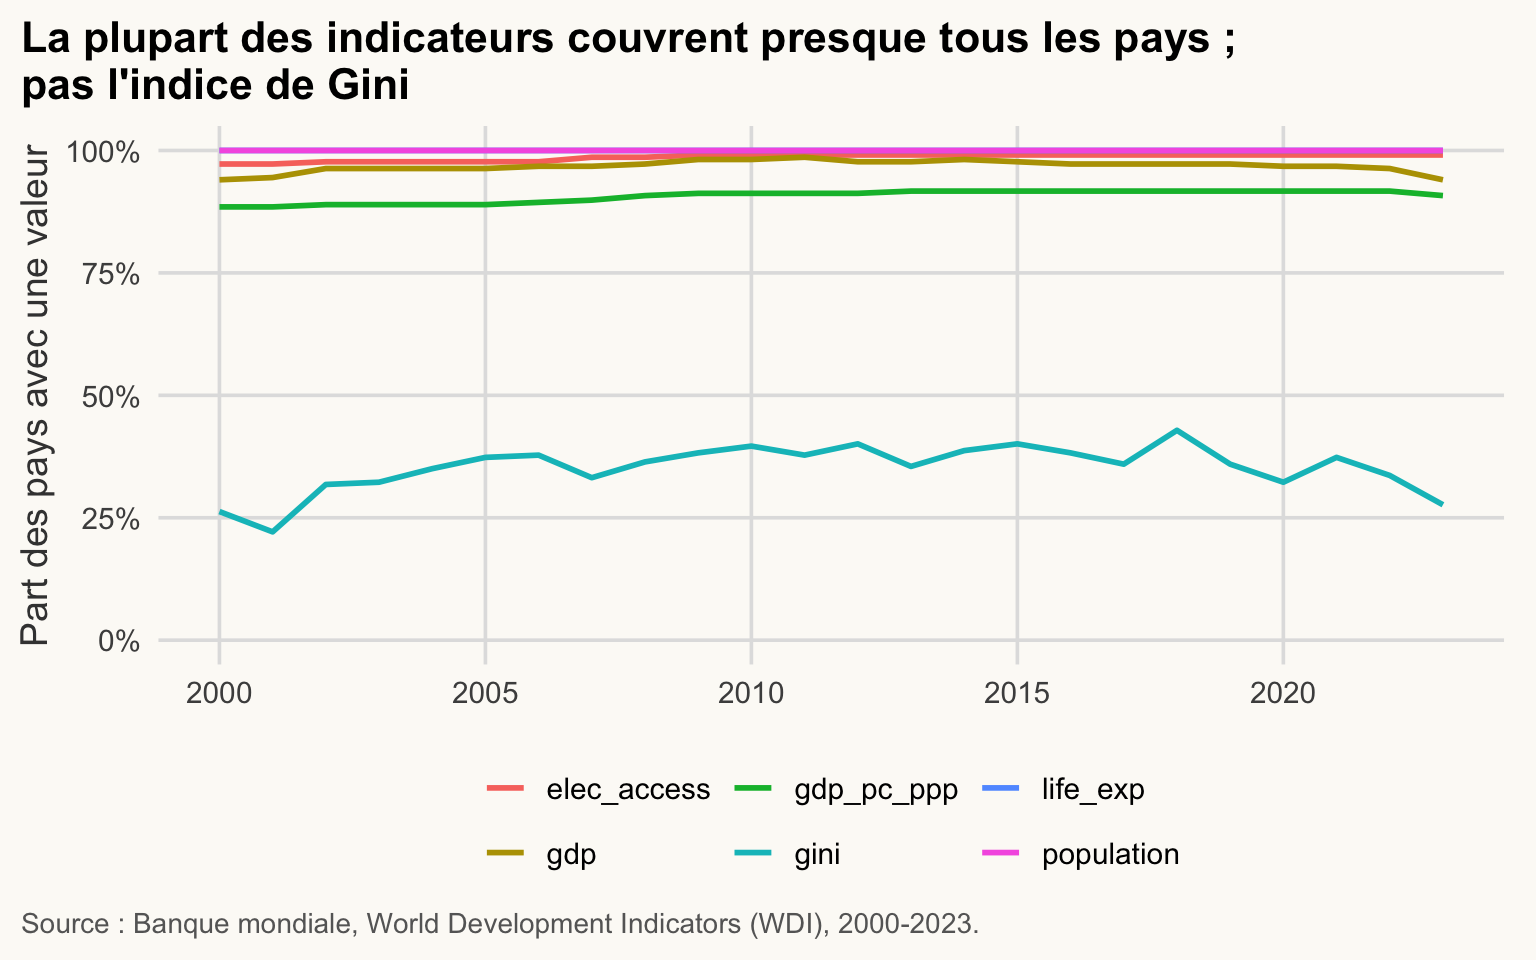
$ elec_access <dbl> 4.4, 9.3, 14.1, 19.0, 23.8, 28.7, 33.5, 38.4, 42.4, 48.3, …Avant d’utiliser un panel, demandez-vous : quelle part en est réellement observée ? Le graphique ci-dessous montre, pour chaque indicateur et chaque année, la part des pays ayant une valeur non manquante. (Les lignes proches de 100 % se superposent : population et life_exp sont entièrement observées.)
Afficher le code du graphique (enseigné à la séance 5)
wdi_panel |>
  summarise(across(c(gdp, gdp_pc_ppp, population, life_exp, gini, elec_access),
                   \(x) mean(!is.na(x))),
            .by = year) |>
  pivot_longer(-year, names_to = "indicator", values_to = "share_observed") |>
  ggplot(aes(x = year, y = share_observed, colour = indicator)) +
  geom_line(linewidth = 1) +
  scale_y_continuous(labels = label_percent(), limits = c(0, 1)) +
  labs(
    title = str_wrap("La plupart des indicateurs couvrent presque tous les pays ; pas l'indice de Gini", 60),
    x = NULL, y = "Part des pays avec une valeur", colour = NULL,
    caption = str_wrap("Source : Banque mondiale, World Development Indicators (WDI), 2000-2023.", 95)
  )
AvertissementErreur fréquente
Faire la moyenne d’un indicateur ou le comparer sans vérifier sa couverture. Si l’indice de Gini n’est observé que pour moins de la moitié des pays une année donnée, toute « moyenne mondiale » décrit un groupe sélectionné (les pays qui réalisent des enquêtes auprès des ménages), pas le monde.
NotePourquoi c’est important en économie du développement
Les données manquantes dans les WDI ne sont pas aléatoires : les pays à faible revenu et fragiles sont ceux qui comptent le moins d’observations. Vérifier d’abord la couverture vous dit de qui parlent réellement vos résultats.
9. Un premier aperçu des données (Facultatif : pour aller plus loin)
≈ 5 min Après cette section, vous aurez vu ce qu’un import propre permet de faire ensuite.
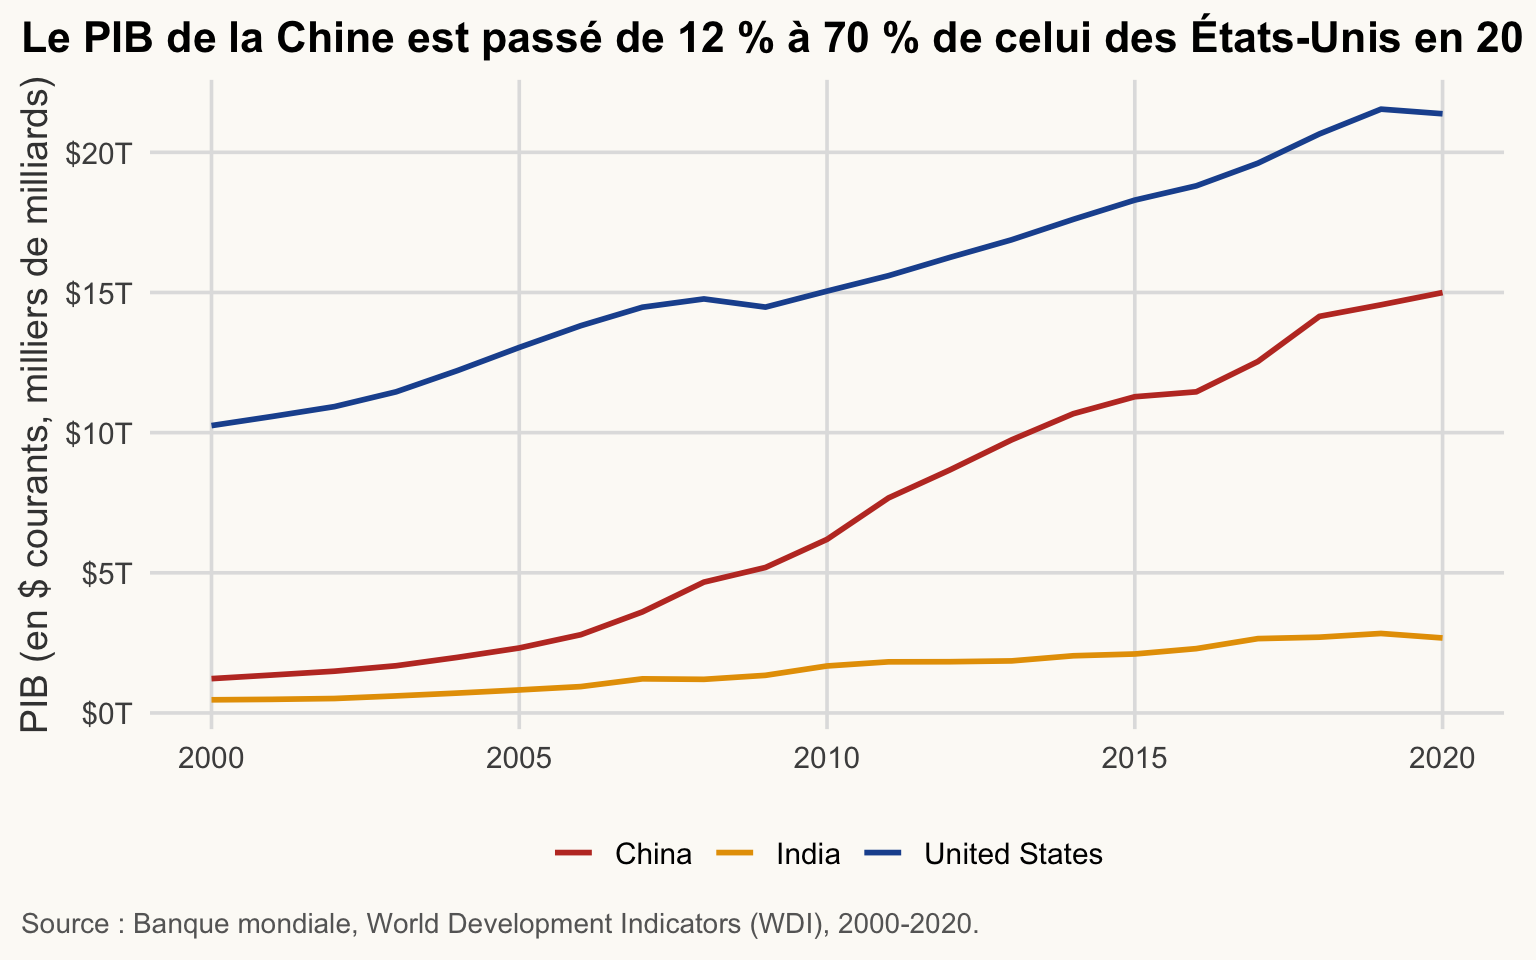
Juste pour voir où nous allons (la séance 5 explique chaque ligne ; pour l’instant, recopiez le schéma) : le PIB des trois pays.
ggplot(wdi3, aes(x = year, y = gdp, colour = country)) +
  geom_line(linewidth = 1) +
  scale_y_continuous(labels = label_dollar(scale = 1e-12, suffix = "T")) +
  scale_colour_manual(values = c(China = pal_cours[["accent"]],
                                 India = "#E69F00",
                                 `United States` = pal_cours[["principal"]])) +
  labs(
    title = "Le PIB de la Chine est passé de 12 % à 70 % de celui des États-Unis en 20 ans",
    x = NULL, y = "PIB (en $ courants, milliers de milliards)", colour = NULL,
    caption = "Source : Banque mondiale, World Development Indicators (WDI), 2000-2020."
  )
10. Exercices (≈ 25 min, plus ≈ 20 min facultatives)
AstuceExercice 2.1
Importez data/raw/SCIM.csv. Nettoyez les noms de colonnes, ne gardez que location, time, subject et value, et affichez les 6 premières lignes. Combien y a-t-il de pays distincts (location) ?
NoteAfficher la solution
ex1 <- read_csv(here("data", "raw", "SCIM.csv"), show_col_types = FALSE) |>
  clean_names() |>
  select(location, time, subject, value)

head(ex1)
# A tibble: 6 × 4
location time subject value
<chr> <chr> <chr> <dbl>
1 ISR 2022-Q2 XTEXVA01 17.2
2 ISR 2022-Q3 XTEXVA01 17.2
3 ISR 2022-Q4 XTEXVA01 16.5
4 ISR 2023-Q1 XTEXVA01 14.0
5 ISR 2023-Q2 XTEXVA01 15.5
6 ISR 2023-Q3 XTEXVA01 15.7n_distinct(ex1$location)[1] 49
AstuceExercice 2.2
À partir de data/raw/SCIM.xlsx, lisez la feuille Sheet1, mais seulement les cellules A1:C11 (le pays et les deux premiers mois). Quel pays a la valeur la plus élevée dans la première colonne de mois ?
NoteAfficher la solution
ex2 <- read_excel(here("data", "raw", "SCIM.xlsx"), sheet = "Sheet1", range = "A1:C11")
ex2
# A tibble: 10 × 3
Pays `Août-2022` `Sept-2022`
<chr> <dbl> <dbl>
1 Australie 35.2 36.0
2 Autriche 17.3 17.2
3 Belgique 55.1 54.2
4 Canada 50.9 49.6
5 Chili 8.07 8.34
6 Colombie 4.29 4.68
7 Costa Rica 1.60 1.53
8 Tchéquie 20.3 19.9
9 Danemark 10.8 10.7
10 Estonie 1.85 1.78ex2 |> slice_max(`Août-2022`, n = 1) # backticks : accent et tiret dans le nom# A tibble: 1 × 3
Pays `Août-2022` `Sept-2022`
<chr> <dbl> <dbl>
1 Belgique 55.1 54.2
AstuceExercice 2.3
Écrivez ex2 dans output/ sous la forme d’un fichier CSV et d’un fichier Excel à deux feuilles (ex2 et ex1_head, cette dernière contenant les 20 premières lignes de ex1). Vérifiez que les fichiers existent.
NoteAfficher la solution
write_csv(ex2, here("output", "ex2.csv"))
write_xlsx(list(ex2 = ex2, ex1_head = head(ex1, 20)),
           here("output", "ex2_sheets.xlsx"))

file.exists(here("output", c("ex2.csv", "ex2_sheets.xlsx")))
[1] TRUE TRUE
AstuceExercice 2.4 (Facultatif : pour aller plus loin)
Écrivez l’appel à WDI() qui récupérerait la population totale (SP.POP.TOTL) du Japon, de l’Allemagne et du Brésil de 2000 à 2020. (Vous ne pouvez pas l’exécuter en classe sans Internet : écrivez-le seulement.)
NoteAfficher la solution
pop_api <- WDI(
  country   = c("JP", "DE", "BR"),
  indicator = c(population = "SP.POP.TOTL"),
  start = 2000, end = 2020
)
# puis sauvegardez-le une fois, pour ne plus jamais avoir à rappeler l'API :
dir.create(here("output"), showWarnings = FALSE)
write_csv(pop_api, here("output", "pop_3countries.csv"))
WDI() prend des codes pays ISO-2 (ou "all"), un vecteur nommé d’indicateurs (new_name = code) et une période. Le résultat comporte une ligne par pays-année.
AstuceExercice 2.5 (Facultatif : pour aller plus loin)
À l’aide du panel en cache wdi_panel, calculez la population moyenne (en millions) du Japon, de l’Allemagne et du Brésil sur 2000–2020.
NoteAfficher la solution
wdi_panel |>
  filter(country %in% c("Japan", "Germany", "Brazil"), year <= 2020) |>
  summarise(mean_pop_millions = mean(population, na.rm = TRUE) / 1e6,
            .by = country)
# A tibble: 3 × 2
country mean_pop_millions
<chr> <dbl>
1 Brazil 193.
2 Germany 82.1
3 Japan 127.
AstuceExercice 2.6 : du texte aux nombres
Quelqu’un a saisi ces montants à la main :
x <- c(" 12", "1,200", "n/a", "7 ")- Exécutez
as.numeric(x). Combien deNAobtenez-vous ? Lequel est une vraie valeur manquante, et lequel est un échec de conversion ? - Convertissez
xavecparse_number(). Quelle valeur est maintenant correcte ? - Indiquez à
parse_number()que"n/a"signifie « manquant » (argumentna =). Vérifiez avecsum(is.na())qu’il reste exactement unNA, et que l’avertissement a disparu.
NoteAfficher la solution
as.numeric(x) # les espaces passent ; la virgule et "n/a", nonWarning: NAs introduced by coercion[1] 12 NA NA 7sum(is.na(as.numeric(x)))Warning: NAs introduced by coercion[1] 2parse_number(x) # 1200 est correct ; "n/a" donne encore un avertissementWarning: 1 parsing failure.
row col expected actual
3 -- a number n/a[1] 12 1200 NA 7
attr(,"problems")
# A tibble: 1 × 4
row col expected actual
<int> <int> <chr> <chr>
1 3 NA a number n/a parse_number(x, na = "n/a") # "n/a" déclaré manquant : plus d'avertissement[1] 12 1200 NA 7sum(is.na(parse_number(x, na = "n/a")))[1] 1as.numeric() donne deux NA : "n/a" est une vraie valeur manquante, "1,200" est un échec de conversion. parse_number() lit "1,200" comme 1200. Une fois "n/a" déclaré avec na =, le seul NA restant est celui que vous attendiez.
AstuceExercice 2.7 (Facultatif : pour aller plus loin)
Des visites de terrain, une ligne par visite, avec le mois saisi sous la forme mois/année :
visits <- tibble(
  country = c("Gambia, The", "the  gambia", "THE GAMBIA ", "Senegal", "senegal"),
  month   = c("03/2018", "11/2018", "13/2019", "06/2019", "09/2019")
)- Nettoyez
countrypour qu’il ne reste exactement que deux noms,"The Gambia"et"Senegal". - Transformez
monthen date avec la bonne fonction delubridate. Quelle ligne échoue, et pourquoi ? - Ajoutez l’année et comptez les visites par pays et par année.
NoteAfficher la solution
visits <- visits |>
  mutate(
    country = str_to_title(str_squish(country)),
    country = case_when(country == "Gambia, The" ~ "The Gambia",   # graphie de la Banque mondiale
                        .default = country),
    date = my(month),
    year = year(date)
  )
Warning: There was 1 warning in `mutate()`.
ℹ In argument: `date = my(month)`.
Caused by warning:
! 1 failed to parse.visits |> filter(is.na(date)) # le mois 13 n'existe pas# A tibble: 1 × 4
country month date year
<chr> <chr> <date> <dbl>
1 The Gambia 13/2019 NA NAvisits |> count(country, year)# A tibble: 3 × 3
country year n
<chr> <dbl> <int>
1 Senegal 2019 2
2 The Gambia 2018 2
3 The Gambia NA 1my() lit le mois puis l’année. "13/2019" ne peut pas être lu : il n’y a pas de 13e mois. Son année est NA elle aussi, donc le comptage affiche une visite en Gambie dont l’année est inconnue : signalez-la, ne la supprimez pas en silence.
À retenir
- N’utilisez jamais
setwd()ni de chemins absolus :here::here()fonctionne sur toutes les machines. -
data/raw/est en lecture seule. Tout ce que vous produisez va dansoutput/. - Regardez le texte brut d’un fichier avant de le lire, et vérifiez
nrow(),glimpse()etproblems()après. -
read_csv()pour les virgules,read_delim()pour les autres séparateurs (skip =,col_names =) ;read_excel()avecsheet =etrange =. -
clean_names()rend les noms de colonnes utilisables ; les colonnes dupliquées et les dates en texte sont courantes dans les données réelles. - Nombres stockés en texte :
parse_number(), pasas.numeric(). Les codes restent du texte :col_types = cols(code = col_character()). Libellés :str_squish(), puis vérification avecunique(). - Comptez les
NAavant et après chaque conversion ; déclarez à l’import les codes de valeurs manquantes du fournisseur avecna = c("", "NA", "n/a"). - Dates : la fonction de
lubridatesuit l’ordre du texte (dmy(),ymd(),my(),yq()) ; un avertissementfailed to parsesignale desNAà retrouver avecis.na(). - Écrivez avec
write_csv(),write_xlsx()(une liste nommée donne plusieurs feuilles) etsaveRDS()pour conserver les objets R à l’identique. - Mettez en cache les données d’API (
WDI) dans un fichier : reproductible, hors ligne, rapide.
Prochaine séance : Séance 3 : Manipuler les données (dplyr, tidyr, jointures).